<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://hoangtl.site/feed.xml" rel="self" type="application/atom+xml" /><link href="https://hoangtl.site/" rel="alternate" type="text/html" /><updated>2026-11-05T04:42:17+00:00</updated><id>https://hoangtl.site/feed.xml</id><title type="html">Le-Hoang Tran</title><subtitle>Le-Hoang Tran&apos;s professional portfolio</subtitle><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><entry><title type="html">1BRC in Java: from 204s to 13.5s</title><link href="https://hoangtl.site/posts/1brc-java/" rel="alternate" type="text/html" title="1BRC in Java: from 204s to 13.5s" /><published>2026-10-18T00:00:00+00:00</published><updated>2026-10-18T00:00:00+00:00</updated><id>https://hoangtl.site/posts/1brc-java</id><content type="html" xml:base="https://hoangtl.site/posts/1brc-java/"><![CDATA[<p>This post is my optimization log for the <a href="https://github.com/gunnarmorling/1brc">One Billion Row Challenge</a> (1BRC) in Java. I took a plain <code class="language-plaintext highlighter-rouge">Files.lines</code> + <code class="language-plaintext highlighter-rouge">HashMap</code> solution through 8 passes, and each pass started from what the previous flame graph showed.</p>
<ul>
  <li><strong>1B rows (14 GB):</strong> 204.6s → 13.5s</li>
  <li><strong>100M rows (1.4 GB):</strong> 21.0s → 0.5s</li>
  <li><strong>Code:</strong> <a href="https://github.com/lehoangtran289/1brc-java">lehoangtran289/1brc-java</a></li>
</ul>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#0-the-challenge" id="markdown-toc-0-the-challenge">0. The challenge</a></li>
  <li><a href="#1-setup" id="markdown-toc-1-setup">1. Setup</a></li>
  <li><a href="#2-results" id="markdown-toc-2-results">2. Results</a></li>
  <li><a href="#pass-1-baseline-210s" id="markdown-toc-pass-1-baseline-210s">Pass 1: Baseline (21.0s)</a></li>
  <li><a href="#pass-2-mmap--parse-bytes-by-hand-210s--70s" id="markdown-toc-pass-2-mmap--parse-bytes-by-hand-210s--70s">Pass 2: mmap + parse bytes by hand (21.0s → 7.0s)</a>    <ul>
      <li><a href="#why-mmap-saved-only-2s" id="markdown-toc-why-mmap-saved-only-2s">Why mmap saved only 2s</a></li>
    </ul>
  </li>
  <li><a href="#pass-3-byte-key-instead-of-string-70s--298s" id="markdown-toc-pass-3-byte-key-instead-of-string-70s--298s">Pass 3: <code class="language-plaintext highlighter-rouge">byte[]</code> key instead of <code class="language-plaintext highlighter-rouge">String</code> (7.0s → 2.98s)</a></li>
  <li><a href="#pass-4-custom-hash-table-298s--265s" id="markdown-toc-pass-4-custom-hash-table-298s--265s">Pass 4: Custom hash table (2.98s → 2.65s)</a></li>
  <li><a href="#pass-5-8-bytes-at-a-time-265s--18s" id="markdown-toc-pass-5-8-bytes-at-a-time-265s--18s">Pass 5: 8 bytes at a time (2.65s → 1.8s)</a></li>
  <li><a href="#pass-6-branch-free-temperature-18s--17s" id="markdown-toc-pass-6-branch-free-temperature-18s--17s">Pass 6: Branch-free temperature (1.8s → 1.7s)</a></li>
  <li><a href="#pass-7-drop-the-per-read-bound-check-17s-no-change" id="markdown-toc-pass-7-drop-the-per-read-bound-check-17s-no-change">Pass 7: Drop the per-read bound check (~1.7s, no change)</a></li>
  <li><a href="#pass-8-parallel-chunks-17s--05s" id="markdown-toc-pass-8-parallel-chunks-17s--05s">Pass 8: Parallel chunks (1.7s → 0.5s)</a></li>
  <li><a href="#possible-next-directions" id="markdown-toc-possible-next-directions">Possible next directions</a></li>
</ul>

  </nav>
</aside>

<h2 id="0-the-challenge">0. The challenge</h2>

<p>The input is a text file with one measurement per line, in the format <code class="language-plaintext highlighter-rouge">&lt;station name&gt;;&lt;temperature&gt;</code>. The temperature always has exactly one fractional digit:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Hamburg;12.0
Bulawayo;8.9
Palembang;38.8
St. John's;15.2
Istanbul;23.0
</code></pre></div></div>

<p>The program has to compute the min, mean and max temperature for each station and print them sorted by station name:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>{Abha=-23.0/18.0/59.2, Abidjan=-16.2/26.0/67.3, Abéché=-10.0/29.4/69.0, ...}
</code></pre></div></div>

<p>The rules that matter for the tricks below: station names are 1 to 100 bytes of UTF-8, there are at most 10,000 unique stations (the generated data has about 413), and temperatures range from -99.9 to 99.9.</p>

<h2 id="1-setup">1. Setup</h2>

<table>
  <thead>
    <tr>
      <th> </th>
      <th> </th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Machine</td>
      <td>Apple M1 Pro: 8 cores (6 performance + 2 efficiency), 16 GB RAM, macOS</td>
    </tr>
    <tr>
      <td>JDK</td>
      <td>OpenJDK 21 (Temurin)</td>
    </tr>
    <tr>
      <td>Dataset</td>
      <td><code class="language-plaintext highlighter-rouge">measurements_100M.txt</code>: 100M rows, 1.4 GB (stays in page cache)</td>
    </tr>
    <tr>
      <td>Profiler</td>
      <td>IntelliJ IDEA Profiler (JFR), CPU Time flame graph</td>
    </tr>
    <tr>
      <td>Timing</td>
      <td><code class="language-plaintext highlighter-rouge">hyperfine --warmup 1 --runs 10</code></td>
    </tr>
  </tbody>
</table>

<p>The 1B times don’t scale 10× from 100M. Pass 6 took 1.7s on 100M, which would predict 17s for 1B, but the 1B run took 43.9s. The 14 GB file likely doesn’t stay in page cache next to the JVM and the IDE on 16 GB of RAM, so the 1B runs include disk reads.</p>

<h2 id="2-results">2. Results</h2>

<table>
  <thead>
    <tr>
      <th>Pass</th>
      <th>Change</th>
      <th>100M</th>
      <th>1B</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>1</td>
      <td>Baseline: <code class="language-plaintext highlighter-rouge">Files.lines</code> + <code class="language-plaintext highlighter-rouge">split</code> + <code class="language-plaintext highlighter-rouge">parseDouble</code> + <code class="language-plaintext highlighter-rouge">HashMap&lt;String&gt;</code></td>
      <td>21.0s</td>
      <td>204.6s</td>
    </tr>
    <tr>
      <td>2</td>
      <td>mmap + parse bytes by hand</td>
      <td>7.0s</td>
      <td>83.2s</td>
    </tr>
    <tr>
      <td>3</td>
      <td><code class="language-plaintext highlighter-rouge">byte[]</code> key instead of <code class="language-plaintext highlighter-rouge">String</code></td>
      <td>2.98s</td>
      <td>62.6s</td>
    </tr>
    <tr>
      <td>4</td>
      <td>Custom open-addressing hash table</td>
      <td>2.65s</td>
      <td>59.8s</td>
    </tr>
    <tr>
      <td>5</td>
      <td>Read and compare the name 8 bytes at a time as <code class="language-plaintext highlighter-rouge">long</code></td>
      <td>1.8s</td>
      <td>46.6s</td>
    </tr>
    <tr>
      <td>6</td>
      <td>Branch-free temperature parsing, first 2 name words as fields</td>
      <td>1.7s</td>
      <td>43.9s</td>
    </tr>
    <tr>
      <td>7</td>
      <td>Drop the per-read bound check</td>
      <td>~1.7s (no change)</td>
      <td>42.2s</td>
    </tr>
    <tr>
      <td>8</td>
      <td>Parallel chunks, one table per chunk</td>
      <td>0.5s</td>
      <td>13.5s</td>
    </tr>
  </tbody>
</table>

<p>Each pass below starts from what the previous profile showed, then describes the idea it led to and the result. The flame graph at the end of a pass is the evidence for the next one.</p>

<h2 id="pass-1-baseline-210s">Pass 1: Baseline (21.0s)</h2>

<p>The baseline is the most obvious Java you could write: read each line with <code class="language-plaintext highlighter-rouge">Files.lines</code>, split it on <code class="language-plaintext highlighter-rouge">;</code>, parse the temperature with <code class="language-plaintext highlighter-rouge">Double.parseDouble</code> and aggregate into a <code class="language-plaintext highlighter-rouge">HashMap</code>. A <code class="language-plaintext highlighter-rouge">TreeMap</code> sorts the output at the end.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Stats</span><span class="o">&gt;</span> <span class="n">stats</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">HashMap</span><span class="o">&lt;&gt;();</span>

<span class="k">try</span> <span class="o">(</span><span class="nc">Stream</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">&gt;</span> <span class="n">lines</span> <span class="o">=</span> <span class="nc">Files</span><span class="o">.</span><span class="na">lines</span><span class="o">(</span><span class="nc">Path</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="no">FILE</span><span class="o">)))</span> <span class="o">{</span>
    <span class="n">lines</span><span class="o">.</span><span class="na">forEach</span><span class="o">(</span><span class="n">line</span> <span class="o">-&gt;</span> <span class="o">{</span>
        <span class="nc">String</span><span class="o">[]</span> <span class="n">parts</span> <span class="o">=</span> <span class="n">line</span><span class="o">.</span><span class="na">split</span><span class="o">(</span><span class="s">";"</span><span class="o">);</span>
        <span class="nc">String</span> <span class="n">station</span> <span class="o">=</span> <span class="n">parts</span><span class="o">[</span><span class="mi">0</span><span class="o">];</span>
        <span class="kt">double</span> <span class="n">measurement</span> <span class="o">=</span> <span class="nc">Double</span><span class="o">.</span><span class="na">parseDouble</span><span class="o">(</span><span class="n">parts</span><span class="o">[</span><span class="mi">1</span><span class="o">]);</span>

        <span class="n">stats</span><span class="o">.</span><span class="na">computeIfAbsent</span><span class="o">(</span><span class="n">station</span><span class="o">,</span> <span class="n">k</span> <span class="o">-&gt;</span> <span class="k">new</span> <span class="nc">Stats</span><span class="o">()).</span><span class="na">add</span><span class="o">(</span><span class="n">measurement</span><span class="o">);</span>
    <span class="o">});</span>
<span class="o">}</span>

<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="k">new</span> <span class="nc">TreeMap</span><span class="o">&lt;&gt;(</span><span class="n">stats</span><span class="o">));</span>
</code></pre></div></div>

<p><img src="/images/blogs/1brc/pass1-baseline.png" alt="Pass 1 flame graph" /></p>

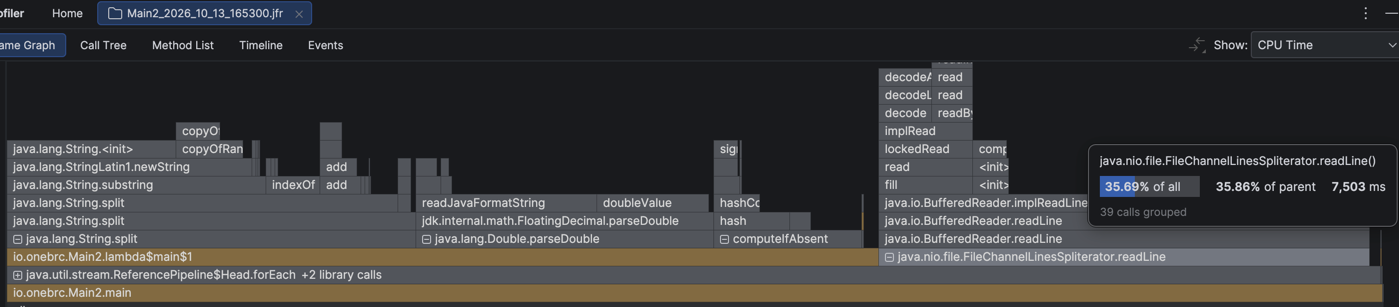
<p>In the profile, <code class="language-plaintext highlighter-rouge">readLine</code> takes 36%, <code class="language-plaintext highlighter-rouge">String.split</code> about 29%, <code class="language-plaintext highlighter-rouge">parseDouble</code> about 21% and the <code class="language-plaintext highlighter-rouge">HashMap</code> about 11%.</p>

<h2 id="pass-2-mmap--parse-bytes-by-hand-210s--70s">Pass 2: mmap + parse bytes by hand (21.0s → 7.0s)</h2>

<p>The three biggest frames in Pass 1, <code class="language-plaintext highlighter-rouge">readLine</code>, <code class="language-plaintext highlighter-rouge">split</code> and <code class="language-plaintext highlighter-rouge">parseDouble</code>, all do the same kind of work. They turn text into objects: a <code class="language-plaintext highlighter-rouge">String</code> for every line, then substrings and a <code class="language-plaintext highlighter-rouge">String[]</code>, then text into a <code class="language-plaintext highlighter-rouge">double</code>. The aggregation itself, the <code class="language-plaintext highlighter-rouge">HashMap</code>, is only about 11%.</p>

<p>I removed those object-creating steps one at a time and profiled again after each one.</p>

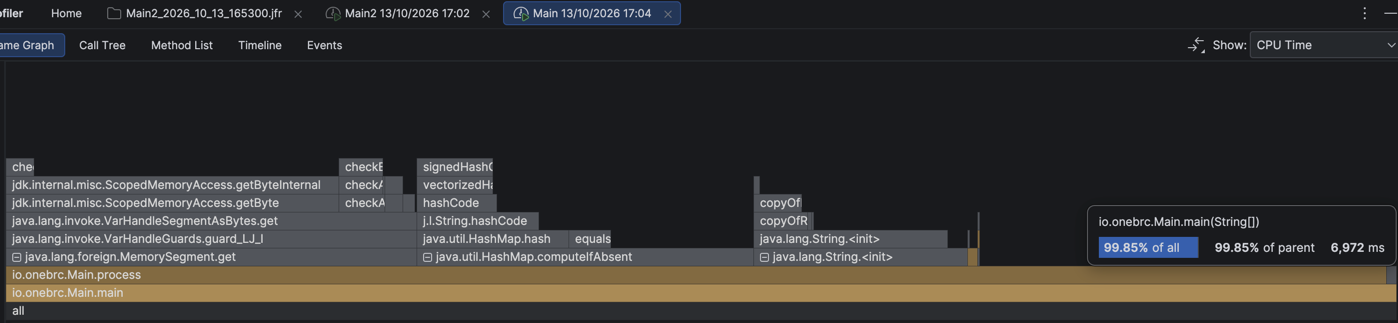
<p><strong>Step 1: replace <code class="language-plaintext highlighter-rouge">readLine</code> with mmap.</strong> The file is mapped into memory as a <code class="language-plaintext highlighter-rouge">MemorySegment</code> (the Foreign Memory API, final in Java 22, preview in 21). The code now scans the mapped bytes for <code class="language-plaintext highlighter-rouge">\n</code> itself, but it still does <code class="language-plaintext highlighter-rouge">new String</code> for every line. That brought the time down to 19.4s.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">try</span> <span class="o">(</span><span class="nc">FileChannel</span> <span class="n">channel</span> <span class="o">=</span> <span class="nc">FileChannel</span><span class="o">.</span><span class="na">open</span><span class="o">(</span><span class="nc">Path</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="no">FILE</span><span class="o">),</span> <span class="nc">StandardOpenOption</span><span class="o">.</span><span class="na">READ</span><span class="o">))</span> <span class="o">{</span>
    <span class="nc">MemorySegment</span> <span class="n">file</span> <span class="o">=</span> <span class="n">channel</span><span class="o">.</span><span class="na">map</span><span class="o">(</span><span class="nc">FileChannel</span><span class="o">.</span><span class="na">MapMode</span><span class="o">.</span><span class="na">READ_ONLY</span><span class="o">,</span> <span class="mi">0</span><span class="o">,</span> <span class="n">channel</span><span class="o">.</span><span class="na">size</span><span class="o">(),</span> <span class="nc">Arena</span><span class="o">.</span><span class="na">global</span><span class="o">());</span>
    <span class="c1">// ...</span>
<span class="o">}</span>
</code></pre></div></div>

<p><img src="/images/blogs/1brc/pass2-mmap.png" alt="Pass 2, step 1 flame graph" /></p>

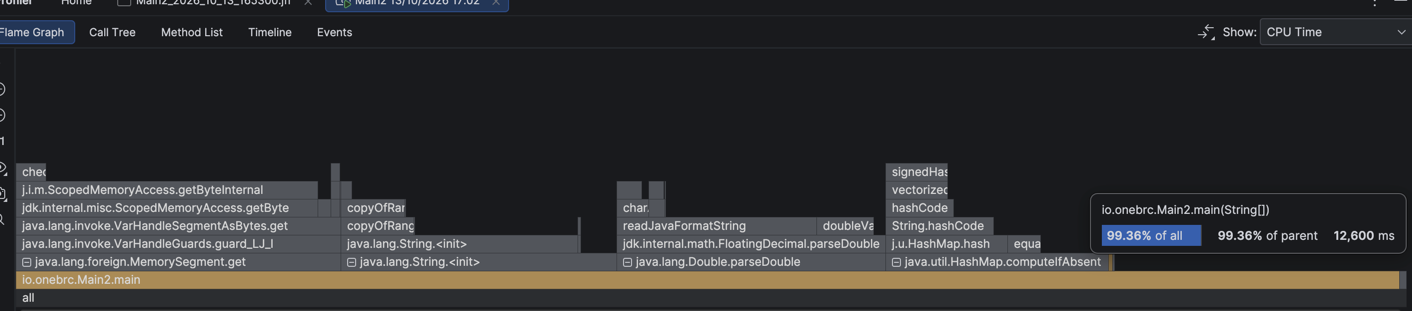
<p><strong>Step 2: find <code class="language-plaintext highlighter-rouge">;</code> in the same byte scan instead of calling <code class="language-plaintext highlighter-rouge">split</code>.</strong> The name and the temperature were each still turned into a <code class="language-plaintext highlighter-rouge">String</code>. That got it to 12.6s.</p>

<p><img src="/images/blogs/1brc/pass2-no-split.png" alt="Pass 2, step 2 flame graph" /></p>

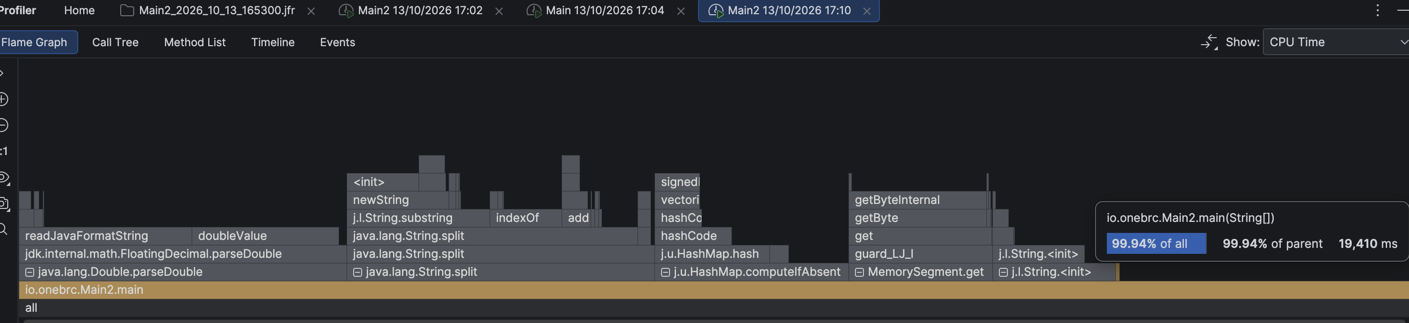
<p><strong>Step 3: replace <code class="language-plaintext highlighter-rouge">parseDouble</code>.</strong> Since every temperature has exactly one fractional digit, I parse the digits straight into an <code class="language-plaintext highlighter-rouge">int</code> of tenths, so <code class="language-plaintext highlighter-rouge">-12.3</code> becomes <code class="language-plaintext highlighter-rouge">-123</code>. The stats stay in integers until printing. That reached 7.0s.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// "-12.3" -&gt; -123</span>
<span class="kt">int</span> <span class="n">sign</span> <span class="o">=</span> <span class="mi">1</span><span class="o">;</span>
<span class="n">currentByte</span> <span class="o">=</span> <span class="n">file</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="no">JAVA_BYTE</span><span class="o">,</span> <span class="n">offset</span><span class="o">++);</span>    <span class="c1">// first char</span>
<span class="k">if</span> <span class="o">(</span><span class="n">currentByte</span> <span class="o">==</span> <span class="no">MINUS</span><span class="o">)</span> <span class="o">{</span>
    <span class="n">sign</span> <span class="o">=</span> <span class="o">-</span><span class="mi">1</span><span class="o">;</span>
    <span class="n">currentByte</span> <span class="o">=</span> <span class="n">file</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="no">JAVA_BYTE</span><span class="o">,</span> <span class="n">offset</span><span class="o">++);</span>
<span class="o">}</span>
<span class="kt">int</span> <span class="n">temp</span> <span class="o">=</span> <span class="n">toDigit</span><span class="o">(</span><span class="n">currentByte</span><span class="o">);</span>                <span class="c1">// first digit</span>
<span class="n">currentByte</span> <span class="o">=</span> <span class="n">file</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="no">JAVA_BYTE</span><span class="o">,</span> <span class="n">offset</span><span class="o">++);</span>
<span class="k">if</span> <span class="o">(</span><span class="n">currentByte</span> <span class="o">!=</span> <span class="no">DOT</span><span class="o">)</span> <span class="o">{</span>
    <span class="n">temp</span> <span class="o">=</span> <span class="n">temp</span> <span class="o">*</span> <span class="mi">10</span> <span class="o">+</span> <span class="n">toDigit</span><span class="o">(</span><span class="n">currentByte</span><span class="o">);</span>    <span class="c1">// second digit</span>
    <span class="n">offset</span><span class="o">++;</span>                                   <span class="c1">// skip '.'</span>
<span class="o">}</span>
<span class="n">currentByte</span> <span class="o">=</span> <span class="n">file</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="no">JAVA_BYTE</span><span class="o">,</span> <span class="n">offset</span><span class="o">);</span>
<span class="n">temp</span> <span class="o">=</span> <span class="n">temp</span> <span class="o">*</span> <span class="mi">10</span> <span class="o">+</span> <span class="n">toDigit</span><span class="o">(</span><span class="n">currentByte</span><span class="o">);</span>        <span class="c1">// fraction digit</span>
<span class="n">offset</span> <span class="o">+=</span> <span class="mi">2</span><span class="o">;</span>                                    <span class="c1">// skip fraction digit &amp; '\n'</span>
<span class="kt">int</span> <span class="n">measurement</span> <span class="o">=</span> <span class="n">sign</span> <span class="o">*</span> <span class="n">temp</span><span class="o">;</span>
</code></pre></div></div>

<p><img src="/images/blogs/1brc/pass2-no-parsedouble.png" alt="Pass 2, step 3 flame graph" /></p>

<h3 id="why-mmap-saved-only-2s">Why mmap saved only 2s</h3>

<p>The mmap step saved only about 2s, even though <code class="language-plaintext highlighter-rouge">readLine</code> had been 7.5s of the profile. The reason is that <code class="language-plaintext highlighter-rouge">readLine</code> did three jobs: getting the bytes, finding the <code class="language-plaintext highlighter-rouge">\n</code> and building the <code class="language-plaintext highlighter-rouge">String</code>. The mmap version still does the last two, which now show up as <code class="language-plaintext highlighter-rouge">MemorySegment.get</code> (about 2.6s) and <code class="language-plaintext highlighter-rouge">String.&lt;init&gt;</code> (about 2.1s). Copying the file was never the cost. Here is each piece measured in isolation:</p>

<table>
  <thead>
    <tr>
      <th>Step</th>
      <th>Time</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">read()</code> the whole file into a 1 MB buffer (all the copying)</td>
      <td>0.1s</td>
    </tr>
    <tr>
      <td>mmap: touch one byte per 16 KB page (page faults)</td>
      <td>0.2s</td>
    </tr>
    <tr>
      <td>mmap: byte loop finding <code class="language-plaintext highlighter-rouge">\n</code></td>
      <td>1.9s</td>
    </tr>
    <tr>
      <td>mmap: byte loop + <code class="language-plaintext highlighter-rouge">new String</code> per line</td>
      <td>3.5s</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">Files.lines</code> (read + decode + <code class="language-plaintext highlighter-rouge">readLine</code> + <code class="language-plaintext highlighter-rouge">String</code>)</td>
      <td>5.6s</td>
    </tr>
  </tbody>
</table>

<p>The lesson: to estimate a saving, you have to subtract <em>all</em> the new frames that still do the old job, and then confirm end to end with hyperfine, not with a single profiling run.</p>

<h2 id="pass-3-byte-key-instead-of-string-70s--298s">Pass 3: <code class="language-plaintext highlighter-rouge">byte[]</code> key instead of <code class="language-plaintext highlighter-rouge">String</code> (7.0s → 2.98s)</h2>

<p>In Pass 2’s profile, <code class="language-plaintext highlighter-rouge">HashMap.computeIfAbsent</code> is about 24% (<code class="language-plaintext highlighter-rouge">String.hashCode</code>, <code class="language-plaintext highlighter-rouge">equals</code>) and <code class="language-plaintext highlighter-rouge">String.&lt;init&gt;</code> about 16%. Both costs exist only because the program still builds a <code class="language-plaintext highlighter-rouge">String</code> for every line to use as a map key, which then gets hashed and compared.</p>

<p>I switched to using the name bytes as the key. One reusable <code class="language-plaintext highlighter-rouge">Key</code>, holding a scratch buffer, the length and a hash computed while scanning, does every lookup. The bytes get copied into a new <code class="language-plaintext highlighter-rouge">Key</code> only the first time a station shows up, which happens about 413 times in 100M lines.</p>

<p><img src="/images/blogs/1brc/pass3-byte-key.png" alt="Pass 3 flame graph" /></p>

<h2 id="pass-4-custom-hash-table-298s--265s">Pass 4: Custom hash table (2.98s → 2.65s)</h2>

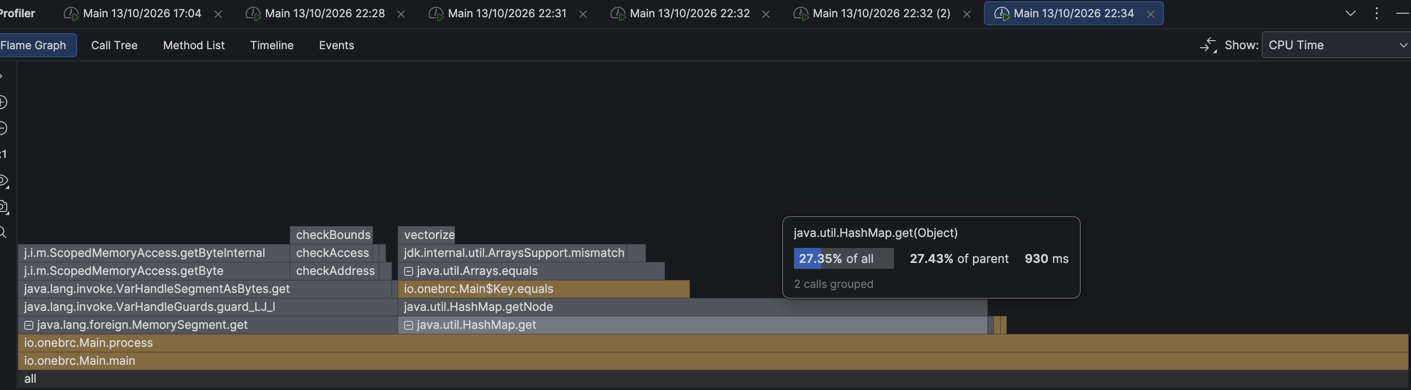
<p>With the <code class="language-plaintext highlighter-rouge">String</code> gone, the map itself is the next cost. In Pass 3’s profile, <code class="language-plaintext highlighter-rouge">HashMap.get</code> is 27%, spent in <code class="language-plaintext highlighter-rouge">getNode</code> → <code class="language-plaintext highlighter-rouge">Key.equals</code> → <code class="language-plaintext highlighter-rouge">Arrays.equals</code>. Every lookup goes through several layers (virtual <code class="language-plaintext highlighter-rouge">hashCode</code>/<code class="language-plaintext highlighter-rouge">equals</code>, node objects), all for a table of only ~413 keys.</p>

<p>I replaced it with my own open-addressing table: 2^14 slots with linear probing, indexed by the precomputed hash. On a probe, it compares the hash and the length first and looks at the bytes only if both match. One <code class="language-plaintext highlighter-rouge">Entry</code> holds both the name and the stats, so a lookup returns the thing to update directly.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="nc">Entry</span> <span class="nf">getOrInsert</span><span class="o">(</span><span class="kt">byte</span><span class="o">[]</span> <span class="n">buffer</span><span class="o">,</span> <span class="kt">int</span> <span class="n">length</span><span class="o">,</span> <span class="kt">int</span> <span class="n">hash</span><span class="o">)</span> <span class="o">{</span>
    <span class="kt">int</span> <span class="n">index</span> <span class="o">=</span> <span class="o">(</span><span class="n">hash</span> <span class="o">^</span> <span class="o">(</span><span class="n">hash</span> <span class="o">&gt;&gt;&gt;</span> <span class="mi">14</span><span class="o">))</span> <span class="o">&amp;</span> <span class="no">MASK</span><span class="o">;</span>

    <span class="k">while</span> <span class="o">(</span><span class="kc">true</span><span class="o">)</span> <span class="o">{</span>
        <span class="nc">Entry</span> <span class="n">entry</span> <span class="o">=</span> <span class="n">entries</span><span class="o">[</span><span class="n">index</span><span class="o">];</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">entry</span> <span class="o">==</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span> <span class="c1">// new station: copy the name only here</span>
            <span class="n">entries</span><span class="o">[</span><span class="n">index</span><span class="o">]</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">Entry</span><span class="o">(</span><span class="nc">Arrays</span><span class="o">.</span><span class="na">copyOf</span><span class="o">(</span><span class="n">buffer</span><span class="o">,</span> <span class="n">length</span><span class="o">),</span> <span class="n">hash</span><span class="o">);</span>
            <span class="k">return</span> <span class="n">entries</span><span class="o">[</span><span class="n">index</span><span class="o">];</span>
        <span class="o">}</span>

        <span class="c1">// cheap checks first, bytes last</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">entry</span><span class="o">.</span><span class="na">hash</span> <span class="o">==</span> <span class="n">hash</span>
                <span class="o">&amp;&amp;</span> <span class="n">entry</span><span class="o">.</span><span class="na">nameBuffer</span><span class="o">.</span><span class="na">length</span> <span class="o">==</span> <span class="n">length</span>
                <span class="o">&amp;&amp;</span> <span class="nc">Arrays</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">entry</span><span class="o">.</span><span class="na">nameBuffer</span><span class="o">,</span> <span class="mi">0</span><span class="o">,</span> <span class="n">length</span><span class="o">,</span> <span class="n">buffer</span><span class="o">,</span> <span class="mi">0</span><span class="o">,</span> <span class="n">length</span><span class="o">))</span> <span class="o">{</span>
            <span class="k">return</span> <span class="n">entry</span><span class="o">;</span>
        <span class="o">}</span>

        <span class="n">index</span> <span class="o">=</span> <span class="o">(</span><span class="n">index</span> <span class="o">+</span> <span class="mi">1</span><span class="o">)</span> <span class="o">&amp;</span> <span class="no">MASK</span><span class="o">;</span> <span class="c1">// collision: linear probing</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>With 2^14 slots and ~413 keys, the table is under 3% full, so probe chains stay short.</p>

<p><img src="/images/blogs/1brc/pass4-hash-table.png" alt="Pass 4 flame graph" /></p>

<h2 id="pass-5-8-bytes-at-a-time-265s--18s">Pass 5: 8 bytes at a time (2.65s → 1.8s)</h2>

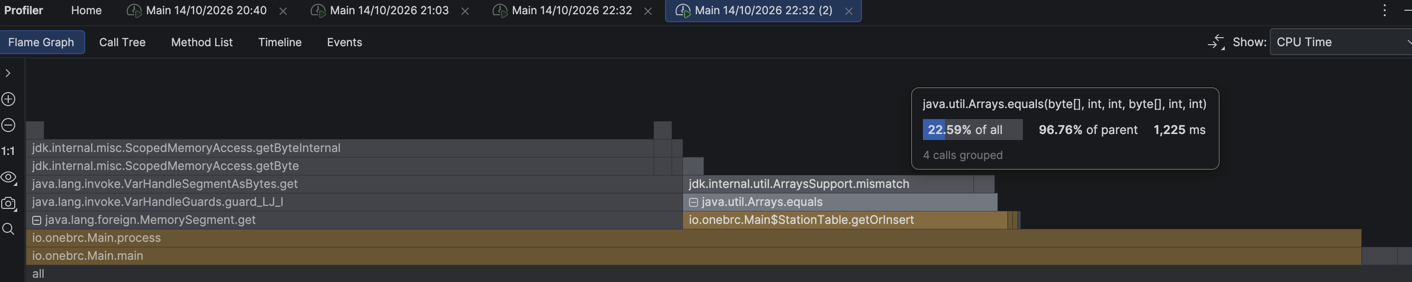
<p>In Pass 4’s profile, about 47% is <code class="language-plaintext highlighter-rouge">MemorySegment.get</code> → <code class="language-plaintext highlighter-rouge">getByte</code>, which reads one byte per call and checks bounds and liveness on every call. Another 23% is <code class="language-plaintext highlighter-rouge">Arrays.equals</code>, comparing names byte by byte.</p>

<p>Both come down to handling one byte at a time, so the fix is to read 8 bytes at once as a little-endian <code class="language-plaintext highlighter-rouge">long</code>. To find the <code class="language-plaintext highlighter-rouge">;</code> inside that <code class="language-plaintext highlighter-rouge">long</code> without looping over its bytes, I used a SWAR (SIMD Within A Register) bit trick:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">long</span> <span class="no">SEMI_PATTERN</span> <span class="o">=</span> <span class="mh">0x3B3B3B3B3B3B3B3B</span><span class="no">L</span><span class="o">;</span> <span class="c1">// ';' in every byte</span>
<span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">long</span> <span class="no">ONES</span>         <span class="o">=</span> <span class="mh">0x0101010101010101</span><span class="no">L</span><span class="o">;</span>
<span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">long</span> <span class="no">HIGH_BITS</span>    <span class="o">=</span> <span class="mh">0x8080808080808080</span><span class="no">L</span><span class="o">;</span>

<span class="kd">private</span> <span class="kd">static</span> <span class="kt">long</span> <span class="nf">findSemicolon</span><span class="o">(</span><span class="kt">long</span> <span class="n">word</span><span class="o">)</span> <span class="o">{</span>
    <span class="kt">long</span> <span class="n">input</span> <span class="o">=</span> <span class="n">word</span> <span class="o">^</span> <span class="no">SEMI_PATTERN</span><span class="o">;</span>            <span class="c1">// the ';' byte becomes 0x00</span>
    <span class="k">return</span> <span class="o">(</span><span class="n">input</span> <span class="o">-</span> <span class="no">ONES</span><span class="o">)</span> <span class="o">&amp;</span> <span class="o">~</span><span class="n">input</span> <span class="o">&amp;</span> <span class="no">HIGH_BITS</span><span class="o">;</span>  <span class="c1">// marks the first 0x00 byte</span>
<span class="o">}</span>
</code></pre></div></div>

<ol>
  <li>XOR with <code class="language-plaintext highlighter-rouge">;;;;;;;;</code> turns the <code class="language-plaintext highlighter-rouge">;</code> byte into <code class="language-plaintext highlighter-rouge">00</code> and every other byte into something non-zero.</li>
  <li><code class="language-plaintext highlighter-rouge">(x - 0x0101…) &amp; ~x &amp; 0x8080…</code> is the classic “find a zero byte” expression. It sets the high bit of the first <code class="language-plaintext highlighter-rouge">00</code> byte.</li>
  <li>Because the long is little-endian, the first byte in the file is the lowest byte of the <code class="language-plaintext highlighter-rouge">long</code>, so <code class="language-plaintext highlighter-rouge">Long.numberOfTrailingZeros(match) &gt;&gt;&gt; 3</code> gives the index of <code class="language-plaintext highlighter-rouge">;</code> (0 to 7).</li>
</ol>

<p>For example, <code class="language-plaintext highlighter-rouge">Hamburg;</code> fits in one <code class="language-plaintext highlighter-rouge">long</code> with <code class="language-plaintext highlighter-rouge">;</code> as byte 7, so <code class="language-plaintext highlighter-rouge">match</code> is <code class="language-plaintext highlighter-rouge">0x8000000000000000</code>, which has 63 trailing zeros, and <code class="language-plaintext highlighter-rouge">63 &gt;&gt;&gt; 3 = 7</code>.</p>

<p>The name is kept as those <code class="language-plaintext highlighter-rouge">long</code> words too: they are XOR’d into the hash as they’re read and compared as a <code class="language-plaintext highlighter-rouge">long[]</code> in the table. A typical name now takes 1 or 2 compares instead of about 10.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">while</span> <span class="o">(</span><span class="kc">true</span><span class="o">)</span> <span class="o">{</span>
    <span class="n">word</span> <span class="o">=</span> <span class="n">file</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="no">LONG_LE</span><span class="o">,</span> <span class="n">offset</span><span class="o">);</span>   <span class="c1">// read 8 bytes</span>
    <span class="n">match</span> <span class="o">=</span> <span class="n">findSemicolon</span><span class="o">(</span><span class="n">word</span><span class="o">);</span>
    <span class="k">if</span> <span class="o">(</span><span class="n">match</span> <span class="o">!=</span> <span class="mi">0</span><span class="o">)</span> <span class="k">break</span><span class="o">;</span>              <span class="c1">// ';' is in this word</span>

    <span class="n">words</span><span class="o">[</span><span class="n">wordsLength</span><span class="o">++]</span> <span class="o">=</span> <span class="n">word</span><span class="o">;</span>
    <span class="n">hash</span> <span class="o">^=</span> <span class="n">word</span><span class="o">;</span>
    <span class="n">offset</span> <span class="o">+=</span> <span class="mi">8</span><span class="o">;</span>
<span class="o">}</span>
<span class="c1">// keep only the bytes before ';' in the last word</span>
<span class="kt">long</span> <span class="n">nameBytes</span> <span class="o">=</span> <span class="n">word</span> <span class="o">&amp;</span> <span class="o">((</span><span class="n">match</span> <span class="o">^</span> <span class="o">(</span><span class="n">match</span> <span class="o">-</span> <span class="mi">1</span><span class="o">))</span> <span class="o">&gt;&gt;&gt;</span> <span class="mi">8</span><span class="o">);</span>
</code></pre></div></div>

<p><img src="/images/blogs/1brc/pass5-swar.png" alt="Pass 5 flame graph" /></p>

<h2 id="pass-6-branch-free-temperature-18s--17s">Pass 6: Branch-free temperature (1.8s → 1.7s)</h2>

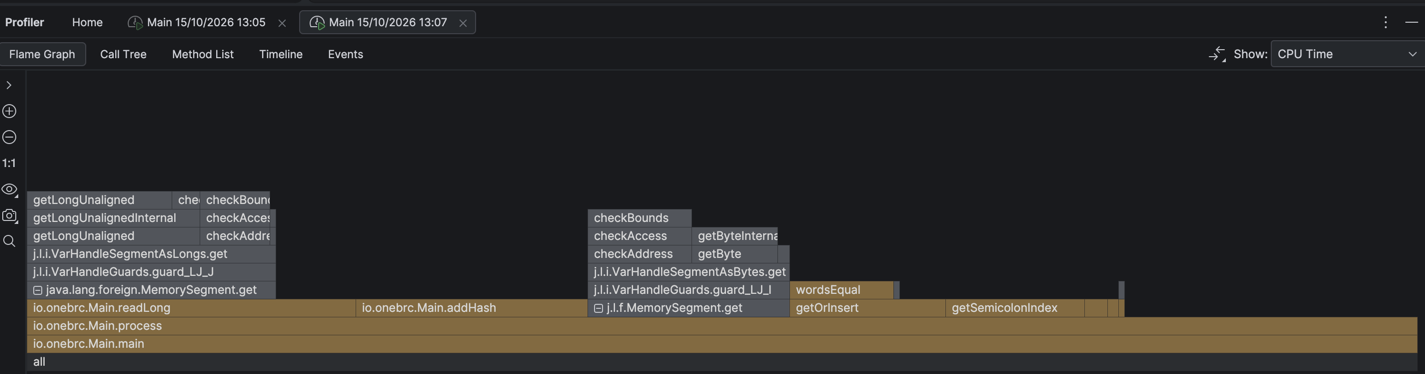
<p>About 14% of Pass 5’s profile is still <code class="language-plaintext highlighter-rouge">MemorySegment.get</code> → <code class="language-plaintext highlighter-rouge">getByte</code>. That is the temperature, which was still parsed byte by byte, with branches on the sign and the digit count. Both depend on random data, so the branch predictor can’t learn them. On top of that, <code class="language-plaintext highlighter-rouge">getOrInsert</code> (about 11%) runs a <code class="language-plaintext highlighter-rouge">wordsEqual</code> loop on every lookup.</p>

<p>I made two changes.</p>

<p><strong>The temperature is now read as one <code class="language-plaintext highlighter-rouge">long</code>.</strong> The 4 possible shapes are <code class="language-plaintext highlighter-rouge">X.X</code>, <code class="language-plaintext highlighter-rouge">-X.X</code>, <code class="language-plaintext highlighter-rouge">XX.X</code> and <code class="language-plaintext highlighter-rouge">-XX.X</code>. A bit trick finds the <code class="language-plaintext highlighter-rouge">.</code>: ASCII digits (<code class="language-plaintext highlighter-rouge">0x30</code>–<code class="language-plaintext highlighter-rouge">0x39</code>) have bit 4 set and <code class="language-plaintext highlighter-rouge">.</code> (<code class="language-plaintext highlighter-rouge">0x2E</code>) doesn’t. Shifts and one multiply then compute the value with no branches. This one is not mine: credit goes to merykitty and royvanrijn from the original challenge.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">long</span> <span class="no">DOT_BITS</span> <span class="o">=</span> <span class="mh">0x10101000</span><span class="o">;</span>

<span class="c1">// bit 4 of bytes 1, 2, 3: the one that is 0 is the '.'</span>
<span class="c1">// returns 12, 20 or 28</span>
<span class="kd">private</span> <span class="kd">static</span> <span class="kt">int</span> <span class="nf">dotPos</span><span class="o">(</span><span class="kt">long</span> <span class="n">word</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">return</span> <span class="nc">Long</span><span class="o">.</span><span class="na">numberOfTrailingZeros</span><span class="o">(~</span><span class="n">word</span> <span class="o">&amp;</span> <span class="no">DOT_BITS</span><span class="o">);</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>The first two name words are now fields on <code class="language-plaintext highlighter-rouge">Entry</code>.</strong> In the 100M file, about 98% of lines have a station name of 15 bytes or less, so the name and its <code class="language-plaintext highlighter-rouge">;</code> fit in the first two words. Those lookups are two <code class="language-plaintext highlighter-rouge">long</code> compares with no loop. Only longer names fall back to comparing the rest of the array.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">if</span> <span class="o">(</span><span class="n">entry</span><span class="o">.</span><span class="na">hash</span> <span class="o">==</span> <span class="n">hash</span>
        <span class="o">&amp;&amp;</span> <span class="n">entry</span><span class="o">.</span><span class="na">word0</span> <span class="o">==</span> <span class="n">words</span><span class="o">[</span><span class="mi">0</span><span class="o">]</span>
        <span class="o">&amp;&amp;</span> <span class="n">entry</span><span class="o">.</span><span class="na">word1</span> <span class="o">==</span> <span class="n">words</span><span class="o">[</span><span class="mi">1</span><span class="o">]</span>
        <span class="o">&amp;&amp;</span> <span class="o">(</span><span class="n">wordLength</span> <span class="o">&lt;=</span> <span class="mi">2</span> <span class="o">||</span> <span class="n">wordTailEquals</span><span class="o">(</span><span class="n">entry</span><span class="o">.</span><span class="na">words</span><span class="o">,</span> <span class="n">words</span><span class="o">,</span> <span class="n">wordLength</span><span class="o">)))</span> <span class="o">{</span>
    <span class="k">return</span> <span class="n">entry</span><span class="o">;</span>
<span class="o">}</span>
</code></pre></div></div>

<p><img src="/images/blogs/1brc/pass6-branchless.png" alt="Pass 6 flame graph" /></p>

<h2 id="pass-7-drop-the-per-read-bound-check-17s-no-change">Pass 7: Drop the per-read bound check (~1.7s, no change)</h2>

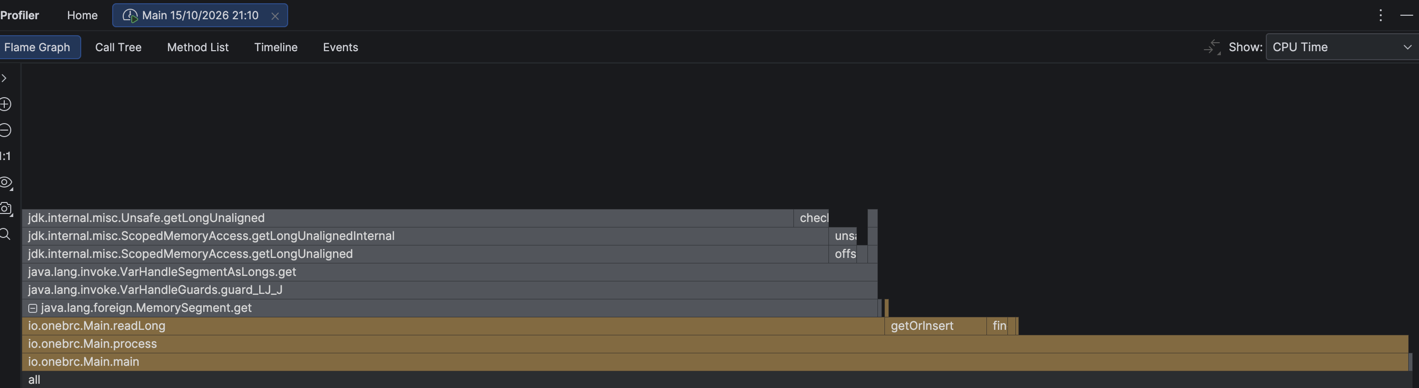
<p>In Pass 6’s profile, about 62% of the samples are in <code class="language-plaintext highlighter-rouge">readLong</code> → <code class="language-plaintext highlighter-rouge">MemorySegment.get</code> → <code class="language-plaintext highlighter-rouge">getLongUnaligned</code>, and <code class="language-plaintext highlighter-rouge">readLong</code> checks <code class="language-plaintext highlighter-rouge">offset + 7 &lt; fileSize</code> on every read.</p>

<p>A line reads at most 108 bytes past its start, so every line that starts more than 128 bytes before EOF can use a plain <code class="language-plaintext highlighter-rouge">file.get</code>. The last ≤128 bytes are copied into a zero-padded buffer and parsed by the same code:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kt">long</span> <span class="n">tailLength</span> <span class="o">=</span> <span class="n">fileSize</span> <span class="o">-</span> <span class="n">tailStart</span><span class="o">;</span>
<span class="nc">MemorySegment</span> <span class="n">tail</span> <span class="o">=</span> <span class="nc">Arena</span><span class="o">.</span><span class="na">global</span><span class="o">().</span><span class="na">allocate</span><span class="o">(</span><span class="n">tailLength</span> <span class="o">+</span> <span class="mi">128</span><span class="o">);</span> <span class="c1">// zero-filled</span>
<span class="nc">MemorySegment</span><span class="o">.</span><span class="na">copy</span><span class="o">(</span><span class="n">file</span><span class="o">,</span> <span class="n">tailStart</span><span class="o">,</span> <span class="n">tail</span><span class="o">,</span> <span class="mi">0</span><span class="o">,</span> <span class="n">tailLength</span><span class="o">);</span>
<span class="n">processFileRange</span><span class="o">(</span><span class="n">tail</span><span class="o">,</span> <span class="mi">0</span><span class="o">,</span> <span class="n">tailLength</span><span class="o">,</span> <span class="n">stationTable</span><span class="o">);</span>
</code></pre></div></div>

<p>It made no difference on 100M. On 1B the time went from 43.9s to 42.2s, which is likely run-to-run noise.</p>

<p>The reason is that the check was always true, so the branch predictor always got it right and it cost almost nothing. The profiler puts the time on the load because that’s where the CPU waits. Each line’s reads depend on where the previous line ended, and new pages cause page faults.</p>

<p>The lesson: a hot load means “waiting for data”, not “the read code is slow”. Removing predictable instructions that aren’t on that chain of dependent steps doesn’t save time.</p>

<h2 id="pass-8-parallel-chunks-17s--05s">Pass 8: Parallel chunks (1.7s → 0.5s)</h2>

<p>Every profile so far shows one thread, <code class="language-plaintext highlighter-rouge">main</code>, mostly waiting on that chain of dependent loads, while 7 of the 8 cores sit idle.</p>

<p>So I split the file into line-aligned chunks and parsed them in a parallel <code class="language-plaintext highlighter-rouge">IntStream</code>. Each chunk gets its own <code class="language-plaintext highlighter-rouge">StationTable</code>, so there’s no sharing and no locks, and the tables are merged by station name at the end.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">int</span> <span class="no">CHUNK_COUNT</span> <span class="o">=</span> <span class="nc">Runtime</span><span class="o">.</span><span class="na">getRuntime</span><span class="o">().</span><span class="na">availableProcessors</span><span class="o">()</span> <span class="o">*</span> <span class="mi">16</span><span class="o">;</span>

<span class="nc">StationTable</span><span class="o">[]</span> <span class="n">stationTables</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">StationTable</span><span class="o">[</span><span class="no">CHUNK_COUNT</span><span class="o">];</span>
<span class="kt">long</span><span class="o">[]</span> <span class="n">boundaries</span> <span class="o">=</span> <span class="n">splitFileIntoChunks</span><span class="o">(</span><span class="n">file</span><span class="o">,</span> <span class="n">tailStart</span><span class="o">);</span> <span class="c1">// each boundary is a '\n'</span>

<span class="nc">IntStream</span><span class="o">.</span><span class="na">range</span><span class="o">(</span><span class="mi">0</span><span class="o">,</span> <span class="no">CHUNK_COUNT</span><span class="o">)</span>
        <span class="o">.</span><span class="na">parallel</span><span class="o">()</span>
        <span class="o">.</span><span class="na">forEach</span><span class="o">(</span><span class="n">i</span> <span class="o">-&gt;</span> <span class="o">{</span>
            <span class="kt">long</span> <span class="n">start</span> <span class="o">=</span> <span class="o">(</span><span class="n">i</span> <span class="o">==</span> <span class="mi">0</span><span class="o">)</span> <span class="o">?</span> <span class="mi">0</span> <span class="o">:</span> <span class="n">boundaries</span><span class="o">[</span><span class="n">i</span> <span class="o">-</span> <span class="mi">1</span><span class="o">]</span> <span class="o">+</span> <span class="mi">1</span><span class="o">;</span>
            <span class="n">stationTables</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">StationTable</span><span class="o">();</span>
            <span class="nc">ChunkProcessor</span><span class="o">.</span><span class="na">processFileRange</span><span class="o">(</span><span class="n">file</span><span class="o">,</span> <span class="n">start</span><span class="o">,</span> <span class="n">boundaries</span><span class="o">[</span><span class="n">i</span><span class="o">]</span> <span class="o">+</span> <span class="mi">1</span><span class="o">,</span> <span class="n">stationTables</span><span class="o">[</span><span class="n">i</span><span class="o">]);</span>
        <span class="o">});</span>

<span class="c1">// merge</span>
<span class="nc">TreeMap</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Entry</span><span class="o">&gt;</span> <span class="n">results</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">TreeMap</span><span class="o">&lt;&gt;();</span>
<span class="k">for</span> <span class="o">(</span><span class="nc">StationTable</span> <span class="n">table</span> <span class="o">:</span> <span class="n">stationTables</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">for</span> <span class="o">(</span><span class="nc">Entry</span> <span class="n">entry</span> <span class="o">:</span> <span class="n">table</span><span class="o">.</span><span class="na">entries</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">entry</span> <span class="o">==</span> <span class="kc">null</span><span class="o">)</span> <span class="k">continue</span><span class="o">;</span>
        <span class="n">results</span><span class="o">.</span><span class="na">merge</span><span class="o">(</span><span class="k">new</span> <span class="nc">String</span><span class="o">(</span><span class="n">entry</span><span class="o">.</span><span class="na">nameBuffer</span><span class="o">,</span> <span class="nc">StandardCharsets</span><span class="o">.</span><span class="na">UTF_8</span><span class="o">),</span> <span class="n">entry</span><span class="o">,</span> <span class="nl">Entry:</span><span class="o">:</span><span class="n">merge</span><span class="o">);</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>A few details:</p>

<ul>
  <li>There are 128 chunks (8 cores × 16), not 8. The M1 Pro has 6 performance and 2 efficiency cores, so equal-sized chunks per core would leave the fast cores waiting on the slow ones. With many small chunks, the fast cores just take more of them.</li>
  <li>Reads may cross a chunk’s end by a few bytes. That’s harmless, because the mapping is read-only and the bytes past the end belong to the next line anyway.</li>
  <li>The merge walks 128 small tables of ~413 stations each, which is tiny next to the parse.</li>
</ul>

<p><img src="/images/blogs/1brc/pass8-parallel.png" alt="Pass 8 flame graph" /></p>

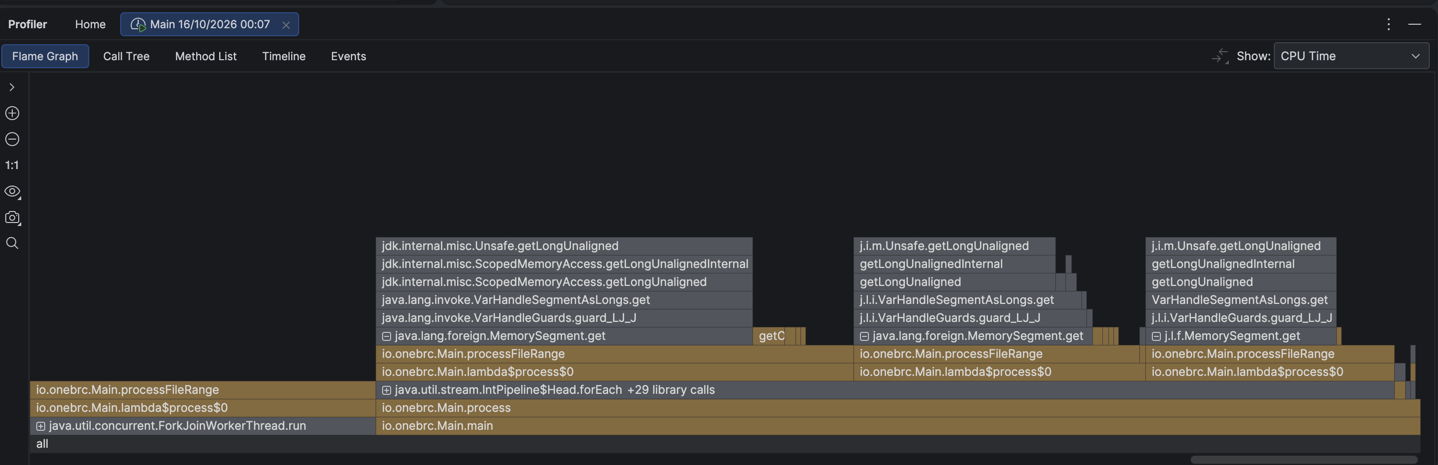
<p>The work is now spread across <code class="language-plaintext highlighter-rouge">ForkJoinWorkerThread</code>s, and each one is still dominated by <code class="language-plaintext highlighter-rouge">MemorySegment.get</code>. On 1B the run took 13.5s, far from 10 × 0.5s, which fits the page-cache note in Setup.</p>

<h2 id="possible-next-directions">Possible next directions</h2>

<p>The <a href="https://github.com/gunnarmorling/1brc#results">official leaderboard</a> is topped by 1.535s, measured on 8 cores of an AMD EPYC 7502P server with the file on a RAM disk. The README’s FAQ points out that wall-clock times are only comparable on the same machine, so my 13.5s on a laptop says little about where this solution would rank. The README does list ideas, though, and these are the ones I haven’t tried yet:</p>

<ul>
  <li><strong>Measure 1B without the disk.</strong> The official runs read the file “from a RAM disk”, so I/O isn’t part of the result. My 1B runs likely include disk reads (see Setup). A machine with enough RAM to keep the 14 GB file cached would show how much of the 13.5s is actually parsing.</li>
  <li><strong><code class="language-plaintext highlighter-rouge">Unsafe</code> instead of <code class="language-plaintext highlighter-rouge">MemorySegment</code>.</strong> Every entry in the top 10 is marked “uses Unsafe”, and <code class="language-plaintext highlighter-rouge">MemorySegment.get</code> has been the biggest frame since Pass 4. Pass 7 is a warning, though: if that frame is the CPU waiting on memory, cheaper reads won’t save much.</li>
  <li><strong>Start-up time: GraalVM native image, AppCDS, CRaC.</strong> The README lists these for “speeding up the application start-up”, and 8 of the top 10 entries run as a GraalVM native binary. At 0.5s for 100M rows, JVM start-up and JIT warm-up are likely a noticeable share of the time.</li>
  <li><strong>The Vector API.</strong> The README suggests “using the (incubating) Vector API”. Pass 5 looks for <code class="language-plaintext highlighter-rouge">;</code> 8 bytes at a time with SWAR, while SIMD registers can check 16 or more bytes per instruction.</li>
  <li><strong>Choosing and tuning the GC.</strong> This is also on the README’s list. After Pass 3 the hot loop allocates almost nothing, so I’d expect little from it.</li>
  <li><strong>10,000 stations.</strong> The generated data has 413 stations, but the rules allow up to 10,000, and the README’s <a href="https://github.com/gunnarmorling/1brc#10k-key-set">10K key set</a> results note that entries “may perform very differently” there. My 2^14-slot table would be about 61% full instead of under 3%, so probe chains get longer. That’s worth measuring with the repo’s <code class="language-plaintext highlighter-rouge">create_measurements3.sh</code>.</li>
  <li><strong>Read the top entries.</strong> Each leaderboard row links to its source. Quan Anh Mai (merykitty), whose temperature trick Pass 6 uses, is one of the three authors of the winning entry. The README’s “1BRC on the Web” list also has write-ups, such as Marko Topolnik’s <a href="https://questdb.io/blog/billion-row-challenge-step-by-step/">step-by-step from 71s to 1.7s</a>.</li>
</ul>

<p>The full code and the benchmark scripts are on <a href="https://github.com/lehoangtran289/1brc-java">GitHub</a>. If you spot a mistake or have an idea for the next pass, feel free to leave a comment or contact me directly.</p>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Java" /><category term="Performance" /><summary type="html"><![CDATA[This post is my optimization log for the One Billion Row Challenge (1BRC) in Java. I took a plain Files.lines + HashMap solution through 8 passes, and each pass started from what the previous flame graph showed.]]></summary></entry><entry><title type="html">A guide to Database Isolation level</title><link href="https://hoangtl.site/posts/mysql-isolation/" rel="alternate" type="text/html" title="A guide to Database Isolation level" /><published>2026-07-18T00:00:00+00:00</published><updated>2026-07-18T00:00:00+00:00</updated><id>https://hoangtl.site/posts/mysql-isolation</id><content type="html" xml:base="https://hoangtl.site/posts/mysql-isolation/"><![CDATA[<p>This post is a quick guide to MySQL Isolation level, but the same concept can still be applied to other relational databases. Think of this post as a <strong>quick reference</strong> to refresh your memory.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#0-introduction" id="markdown-toc-0-introduction">0. Introduction</a></li>
  <li><a href="#1-read-uncommitted" id="markdown-toc-1-read-uncommitted">1. READ UNCOMMITTED</a></li>
  <li><a href="#2-read-committed" id="markdown-toc-2-read-committed">2. READ COMMITTED</a>    <ul>
      <li><a href="#how-mysql-implements-read-committed" id="markdown-toc-how-mysql-implements-read-committed">How MySQL implements READ COMMITTED?</a></li>
    </ul>
  </li>
  <li><a href="#3-repeatable-read" id="markdown-toc-3-repeatable-read">3. REPEATABLE READ</a>    <ul>
      <li><a href="#1-snapshot-refresh" id="markdown-toc-1-snapshot-refresh">(1) Snapshot refresh</a></li>
      <li><a href="#2-locking-strategy" id="markdown-toc-2-locking-strategy">(2) Locking strategy</a></li>
      <li><a href="#edge-case-mixing-snapshot-reads-and-current-reads" id="markdown-toc-edge-case-mixing-snapshot-reads-and-current-reads">Edge Case: Mixing Snapshot Reads and Current Reads</a></li>
      <li><a href="#lost-update-problem" id="markdown-toc-lost-update-problem">Lost Update problem</a></li>
    </ul>
  </li>
  <li><a href="#4-serializable" id="markdown-toc-4-serializable">4. Serializable</a></li>
  <li><a href="#summary" id="markdown-toc-summary">Summary</a></li>
  <li><a href="#references" id="markdown-toc-references">References</a></li>
</ul>

  </nav>
</aside>

<p>I wrote this post based on my own conceptual understanding of the topic, if you notice any mistakes or have any suggestions for improvement, feel free to leave a comment or contact me directly. I will be happy to update the post accordingly.</p>

<h2 id="0-introduction">0. Introduction</h2>

<p>The Isolation level (I in ACID) is the setting that fine-tunes the <strong>balance/trade-off between performance and reliability, consistency</strong> when multiple transactions are performing queries simultaneously.</p>

<p>From highest amount of consistency and protection to the least, the isolation levels supported by MySQL InnoDB are: <code class="language-plaintext highlighter-rouge">SERIALIZABLE</code>, <code class="language-plaintext highlighter-rouge">REPEATABLE READ</code> (default), <code class="language-plaintext highlighter-rouge">READ COMMITTED</code>, and <code class="language-plaintext highlighter-rouge">READ UNCOMMITTED</code>.</p>

<h2 id="1-read-uncommitted">1. READ UNCOMMITTED</h2>

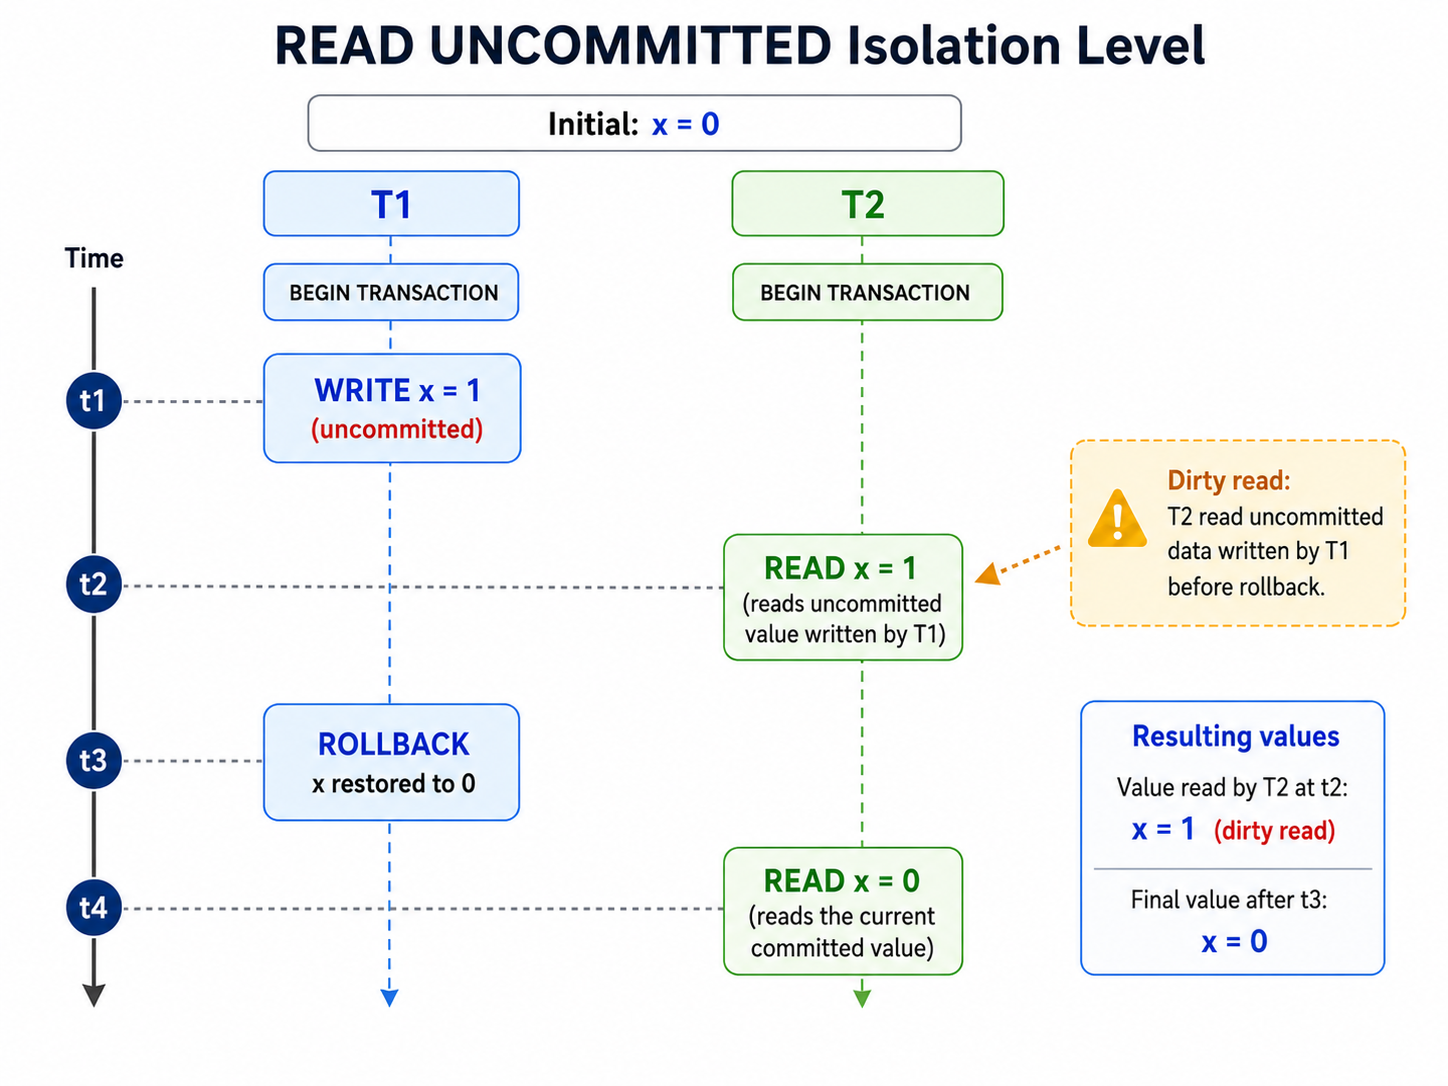
<p>In this mode, a transaction is allowed to READ UNCOMMITTED data from other transactions. This is the lowest isolation level, and it can lead to <strong>DIRTY READS</strong> (visible uncommitted changes) and other anomalies that we will cover in the next sections.</p>

<p><img src="/images/blogs/mysqlisolation/read-uncommitted.png" alt="alt text" /></p>

<h2 id="2-read-committed">2. READ COMMITTED</h2>

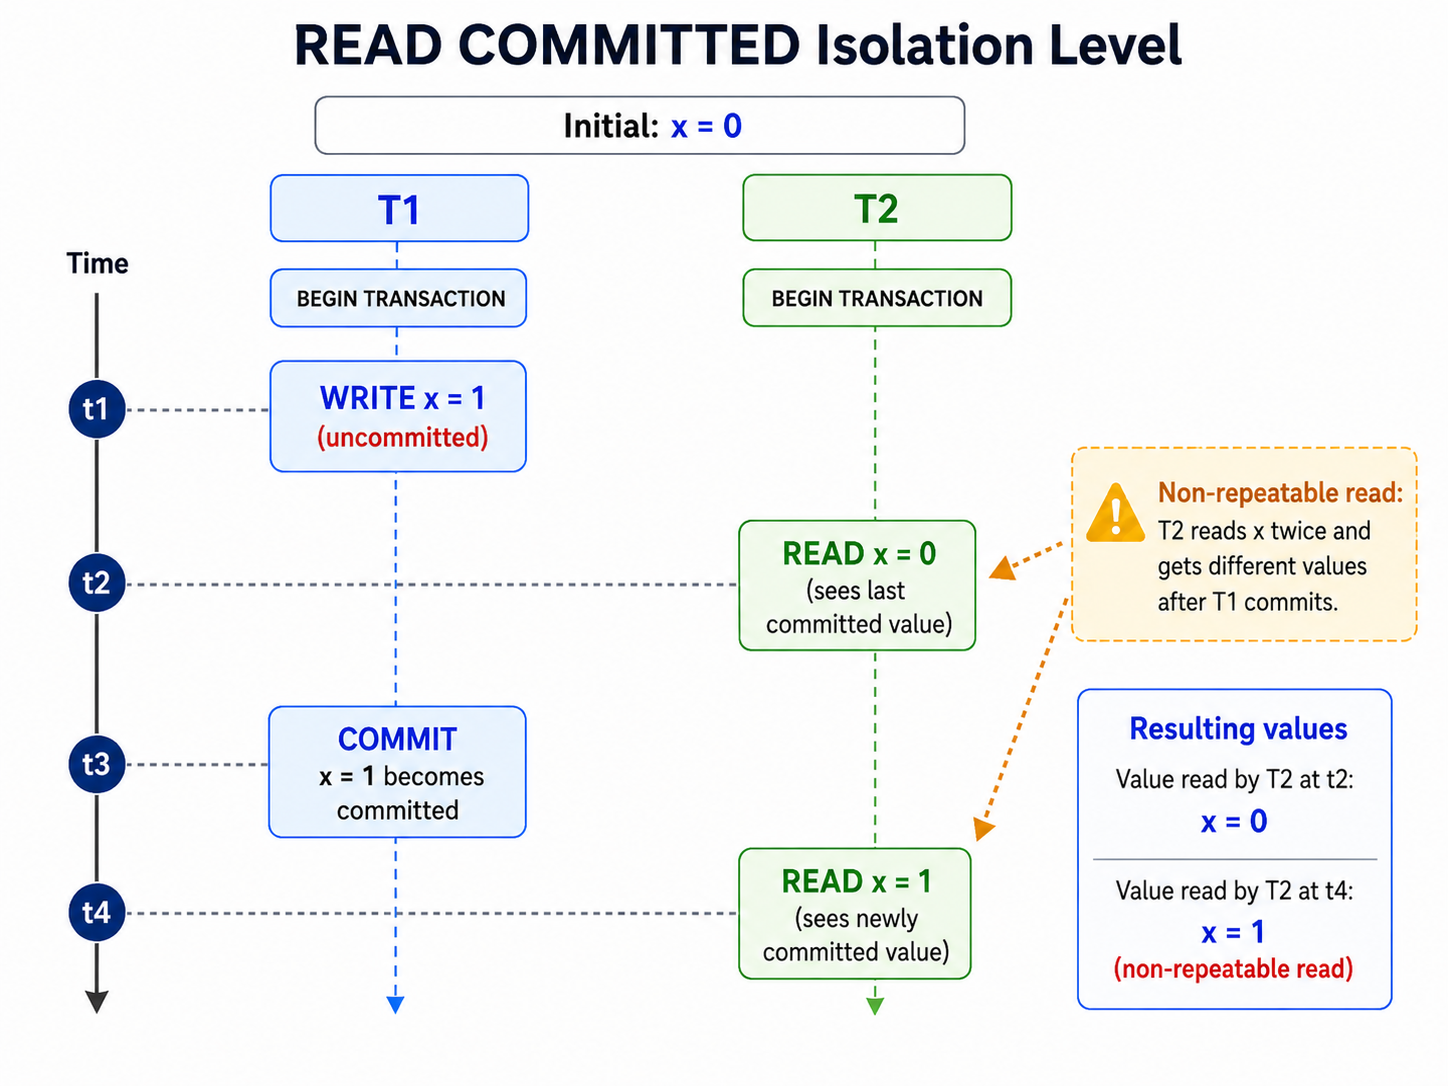
<p>A transaction can only READ COMMITTED data from other transactions. This <strong>prevents DIRTY READS</strong>, but it can still lead to:</p>

<ul>
  <li><strong>NON-REPEATABLE READS</strong> (data can change between reads in the same transaction).</li>
  <li><strong>PHANTOM READS</strong> (#rows changed between 2 reads in the same transaction).</li>
</ul>

<p>This example illustrates the <strong>NON-REPEATABLE READ</strong> phenomenon, but similar logic can be applied to phantom reads:</p>

<p><img src="/images/blogs/mysqlisolation/read-committed.png" alt="alt text" /></p>

<h3 id="how-mysql-implements-read-committed">How MySQL implements READ COMMITTED?</h3>

<p>MySQL takes a <strong>“snapshot”</strong> (latest committed data) of the database’s current state <strong>for each query</strong> in a transaction.</p>

<p>When a transaction reads data, it <strong>accesses the snapshot instead of the source table</strong>. A snapshot is refreshed and synced with committed data for subsequent queries within the same transaction. For example Tx1 COMMIT could refresh the snapshot for Tx2, and Tx2 will see the changes made by Tx1, just like the diagram above.</p>

<h2 id="3-repeatable-read">3. REPEATABLE READ</h2>

<p>TLDR, <code class="language-plaintext highlighter-rouge">REPEATABLE READ</code>:</p>

<ul>
  <li>Prevents <strong>NON-REPEATABLE READs</strong> by reusing the snapshot created by the transaction’s <strong>first plain SELECT</strong>. Rows committed by other transactions afterward remain invisible to this transaction.</li>
  <li>Prevents <strong>phantom reads</strong> by using <strong>gap locks</strong> and <strong>next-key locks</strong> for range scans.</li>
  <li>But there are edge cases</li>
</ul>

<p>Compare to <code class="language-plaintext highlighter-rouge">READ COMMITTED</code>, there are 2 main differences at this level: (1) when does snapshot refresh? (2) locking strategy.</p>

<h3 id="1-snapshot-refresh">(1) Snapshot refresh</h3>

<p>In this mode, a snapshot is taken <strong>at the transaction’s first read</strong>.</p>

<p>Transaction only sees 1 snapshot at its first read, and that snapshot is <strong>used for all subsequent reads</strong> within that transaction. ==&gt; This ensures consistent subsequent READs throughout the transaction’s execution and avoids <strong>NON-REPEATABLE READS</strong>.</p>

<h3 id="2-locking-strategy">(2) Locking strategy</h3>

<p>Under <code class="language-plaintext highlighter-rouge">READ COMMITTED</code>, InnoDB uses <strong>record locks</strong> for locking: it locks index records but generally does not lock the surrounding gaps. Because gaps remain unlocked, another transaction can insert a new row into the searched range, <strong>allowing phantom reads</strong>.</p>

<p>Meanwhile, <code class="language-plaintext highlighter-rouge">REPEATABLE READ</code> adds <strong>gap locks</strong> and <strong>next-key locks</strong> for range scans. I covered these in detail here <a href="/posts/mysql-locks/">MySQL locks post</a>.</p>

<p>Basically, when a transaction executes a locking range operation (e.g., <code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code>, <code class="language-plaintext highlighter-rouge">UPDATE</code>, or <code class="language-plaintext highlighter-rouge">DELETE</code>), InnoDB locks the scanned index range using next-key or gap locks. This prevents other transactions from inserting new rows and therefore <strong>prevents phantom reads</strong>.</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">-- Tx1</span>
<span class="k">BEGIN</span><span class="p">;</span>
<span class="k">SELECT</span> <span class="o">*</span> <span class="k">FROM</span> <span class="n">users</span> <span class="k">WHERE</span> <span class="n">age</span> <span class="k">BETWEEN</span> <span class="mi">20</span> <span class="k">AND</span> <span class="mi">30</span> <span class="k">FOR</span> <span class="k">UPDATE</span><span class="p">;</span>

<span class="c1">-- Tx2: waits if age = 25 falls inside Tx1's locked index range</span>
<span class="k">INSERT</span> <span class="k">INTO</span> <span class="n">users</span><span class="p">(</span><span class="n">age</span><span class="p">)</span> <span class="k">VALUES</span> <span class="p">(</span><span class="mi">25</span><span class="p">);</span>
</code></pre></div></div>

<h3 id="edge-case-mixing-snapshot-reads-and-current-reads">Edge Case: Mixing Snapshot Reads and Current Reads</h3>

<p>Under <code class="language-plaintext highlighter-rouge">REPEATABLE READ</code>, plain <code class="language-plaintext highlighter-rouge">SELECT</code> statements use a fixed MVCC snapshot, while write operation like <code class="language-plaintext highlighter-rouge">UPDATE</code> and <code class="language-plaintext highlighter-rouge">DELETE</code> operate on the latest committed version of the data directly.</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">-- Tx1</span>
<span class="k">BEGIN</span><span class="p">;</span>
<span class="k">SELECT</span> <span class="o">*</span> <span class="k">FROM</span> <span class="n">users</span> <span class="k">WHERE</span> <span class="n">age</span> <span class="o">=</span> <span class="mi">25</span><span class="p">;</span> <span class="c1">-- Returns 0 rows; snapshot is established.</span>

<span class="c1">-- Tx2</span>
<span class="k">INSERT</span> <span class="k">INTO</span> <span class="n">users</span><span class="p">(</span><span class="n">age</span><span class="p">)</span> <span class="k">VALUES</span> <span class="p">(</span><span class="mi">25</span><span class="p">);</span>
<span class="k">COMMIT</span><span class="p">;</span>

<span class="c1">-- Tx1</span>
<span class="k">UPDATE</span> <span class="n">users</span> <span class="k">SET</span> <span class="n">status</span> <span class="o">=</span> <span class="s1">'active'</span> <span class="k">WHERE</span> <span class="n">age</span> <span class="o">=</span> <span class="mi">25</span><span class="p">;</span> <span class="c1">-- Affects 1 row.</span>
<span class="k">SELECT</span> <span class="o">*</span> <span class="k">FROM</span> <span class="n">users</span> <span class="k">WHERE</span> <span class="n">age</span> <span class="o">=</span> <span class="mi">25</span><span class="p">;</span> <span class="c1">-- Returns 1 row; Tx1 can now see its own modification.</span>
</code></pre></div></div>

<p>Although Tx1’s snapshot cannot see the row inserted by Tx2, the <code class="language-plaintext highlighter-rouge">UPDATE</code> uses the latest committed data (bypassing its snapshot), so it can find and modify the newly committed row. Note that the <code class="language-plaintext highlighter-rouge">UPDATE</code> statement <strong>does not refresh the snapshot</strong>, but Tx1 can see its own modification afterward.</p>

<h3 id="lost-update-problem">Lost Update problem</h3>

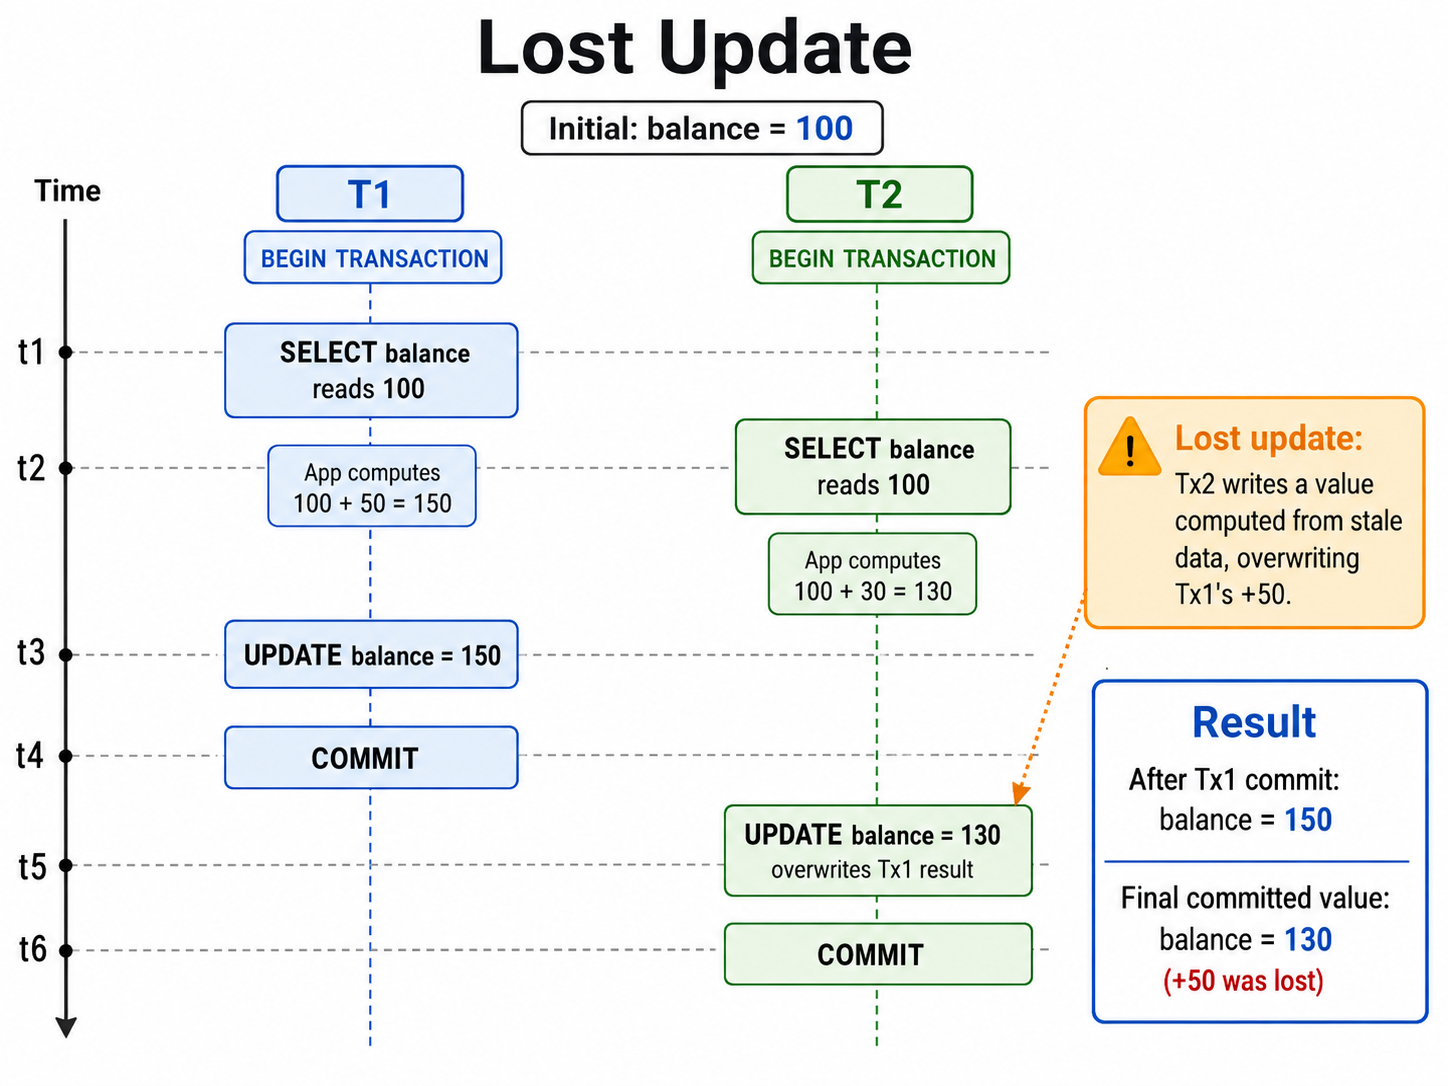
<p>This problem occurs when applications use a <strong>read-modify-write pattern</strong> instead of performing the modification atomically in the database.</p>

<p>For example, 2 transactions can <strong>read</strong> the same data, <strong>update</strong> it in its own memory, and <strong>write</strong> back to the database. The 2nd transaction wins and <strong>overwrites</strong> the first transaction’s update, resulting in a <strong>LOST UPDATE</strong>.</p>

<p><img src="/images/blogs/mysqlisolation/lost-update.png" alt="alt text" /></p>

<p>So how to prevent this? There are 2 approaches:</p>

<ul>
  <li><strong>Pessimistic locking</strong>: use <code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code> to lock the row before reading it. This prevents other transactions from modifying the row until the transaction is committed or rolled back.</li>
  <li><strong>Optimistic locking</strong>: use a <code class="language-plaintext highlighter-rouge">version</code> column to detect if the row has been modified by another transaction before updating it. If the version number has changed, the transaction can abort or retry.
    <ul>
      <li>In implementation, the <code class="language-plaintext highlighter-rouge">version</code> should be compared between <strong>client’s data vs the database’s data</strong> (etags or if-match HTTP pattern).</li>
    </ul>
  </li>
</ul>

<h2 id="4-serializable">4. Serializable</h2>

<p>This level is like <code class="language-plaintext highlighter-rouge">REPEATABLE READ</code>, but InnoDB implicitly converts all plain <code class="language-plaintext highlighter-rouge">SELECT</code> statements to <code class="language-plaintext highlighter-rouge">SELECT ... FOR SHARE</code> (shared locks). The exact locks depend on the query:</p>

<ul>
  <li>UNIQUE index lookup: acquires a <strong>shared record lock</strong> on the found row.</li>
  <li>Range or NON-UNIQUE index scan: acquires <strong>shared next-key locks</strong> over the scanned index range.</li>
</ul>

<p>Shared locks <strong>allow concurrent reads</strong>, but <strong>conflicting writes must wait</strong>. Next-key locks also prevent new rows from being inserted into the protected gaps.</p>

<p>As a result, <code class="language-plaintext highlighter-rouge">SERIALIZABLE</code> prevents dirty reads, non-REPEATABLE READs, phantoms, and typical lost-update patterns.</p>

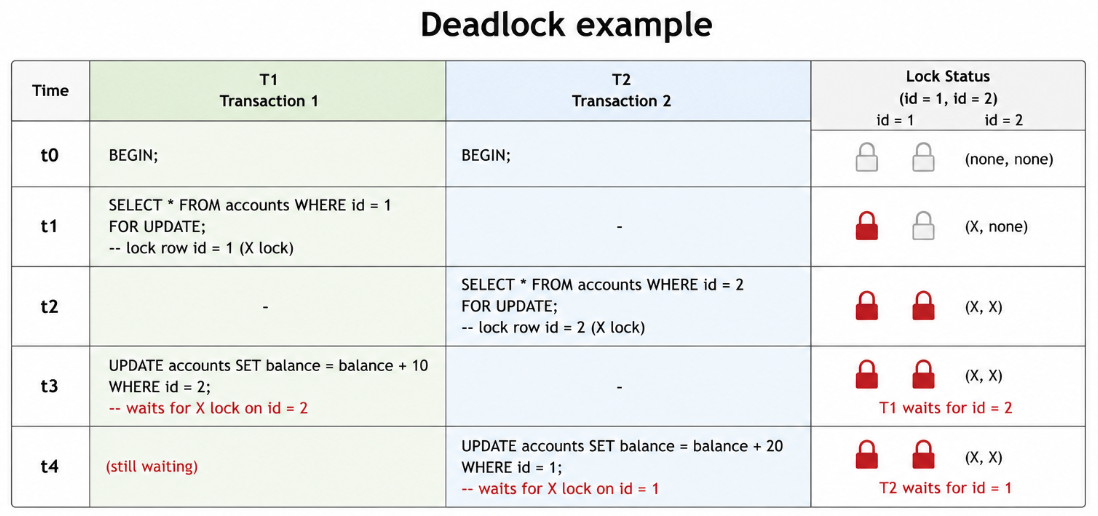
<p><strong>The trade-off</strong> is lower concurrency and <strong>potential deadlocks</strong>. Therefore in practice, applications often remain on <code class="language-plaintext highlighter-rouge">REPEATABLE READ</code> and use targeted <code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code> queries where serialization is required to reduce locking scope.</p>

<p><img src="/images/blogs/mysqlisolation/deadlock.png" alt="alt text" /></p>

<h2 id="summary">Summary</h2>

<table>
  <thead>
    <tr>
      <th style="text-align: left">Isolation Level</th>
      <th style="text-align: center">Dirty Read</th>
      <th style="text-align: center">Non-REPEATABLE READ</th>
      <th style="text-align: center">Phantom Read</th>
      <th style="text-align: left">How</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">READ UNCOMMITTED</code></td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: left">No snapshot, reads live data directly</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">READ COMMITTED</code></td>
      <td style="text-align: center">✅</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: center">❌</td>
      <td style="text-align: left">Snapshot refreshed <strong>per query</strong></td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">REPEATABLE READ</code></td>
      <td style="text-align: center">✅</td>
      <td style="text-align: center">✅</td>
      <td style="text-align: center">✅</td>
      <td style="text-align: left">Snapshot fixed at <strong>first read</strong> + gap/next-key locks</td>
    </tr>
    <tr>
      <td style="text-align: left"><code class="language-plaintext highlighter-rouge">SERIALIZABLE</code></td>
      <td style="text-align: center">✅</td>
      <td style="text-align: center">✅</td>
      <td style="text-align: center">✅</td>
      <td style="text-align: left">Plain <code class="language-plaintext highlighter-rouge">SELECT</code> implicitly becomes <code class="language-plaintext highlighter-rouge">SELECT ... FOR SHARE</code></td>
    </tr>
  </tbody>
</table>

<p><strong>Key takeaways:</strong></p>

<ul>
  <li>
    <p>Isolation level is fundamentally a <strong>trade-off</strong> between consistency and performance ⇒ higher isolation means more locking, less throughput.</p>
  </li>
  <li><code class="language-plaintext highlighter-rouge">READ UNCOMMITTED</code>
    <ul>
      <li>best performance, lowest isolation level. It can lead to <strong>DIRTY READS</strong> and other anomalies.</li>
    </ul>
  </li>
  <li><code class="language-plaintext highlighter-rouge">READ COMMITTED</code>
    <ul>
      <li>Use snapshot mechanism: prevents <strong>DIRTY READS</strong>, but it can still lead to <strong>NON-REPEATABLE READS</strong> and <strong>PHANTOM READS</strong>.</li>
    </ul>
  </li>
  <li><code class="language-plaintext highlighter-rouge">REPEATABLE READ</code> (InnoDB default)
    <ul>
      <li>Blocks the most common anomalies (dirty read, non-REPEATABLE READ, phantom read on locking scans) while still being reasonably concurrent.</li>
      <li>Beware for Mixing Snapshot Reads and Current Reads: plain <code class="language-plaintext highlighter-rouge">SELECT</code> reads the snapshot, <code class="language-plaintext highlighter-rouge">UPDATE</code>/<code class="language-plaintext highlighter-rouge">DELETE</code>/<code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code> read the latest committed data.</li>
      <li>Lost updates problem: Use pessimistic or optimistic locking to prevent this.</li>
    </ul>
  </li>
  <li><code class="language-plaintext highlighter-rouge">SERIALIZABLE</code>
    <ul>
      <li>Gives strongest data consistency, but trades off performance, hence reach for targeted <code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code> on <code class="language-plaintext highlighter-rouge">REPEATABLE READ</code> instead.</li>
    </ul>
  </li>
</ul>

<h2 id="references">References</h2>

<ul>
  <li><a href="https://dev.mysql.com/doc/refman/8.4/en/innodb-transaction-isolation-levels.html">MySQL ACID</a></li>
  <li><a href="https://dev.to/eyochen/a-straightforward-guide-for-isolation-levels-3h66">A straightforward guide for isolation levels</a></li>
  <li><a href="/posts/mysql-locks/">MySQL locks: A quick guide</a></li>
</ul>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Computer Science" /><category term="Database" /><summary type="html"><![CDATA[This post is a quick guide to MySQL Isolation level, but the same concept can still be applied to other relational databases. Think of this post as a quick reference to refresh your memory.]]></summary></entry><entry><title type="html">MySQL locks: A quick guide</title><link href="https://hoangtl.site/posts/mysql-locks/" rel="alternate" type="text/html" title="MySQL locks: A quick guide" /><published>2026-07-16T00:00:00+00:00</published><updated>2026-07-16T00:00:00+00:00</updated><id>https://hoangtl.site/posts/mysql-locks</id><content type="html" xml:base="https://hoangtl.site/posts/mysql-locks/"><![CDATA[<p>Below are some notes on MySQL Locks concepts, I will not go into the very details underneath and cover every single lock type, but I will give you a quick overview of the most common locks and how they work.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#exclusive-locks-x-and-shared-locks-s" id="markdown-toc-exclusive-locks-x-and-shared-locks-s">Exclusive Locks (X) and Shared Locks (S)</a>    <ul>
      <li><a href="#exclusive-locks-x" id="markdown-toc-exclusive-locks-x">Exclusive Locks (X)</a></li>
      <li><a href="#shared-locks-s" id="markdown-toc-shared-locks-s">Shared Locks (S)</a></li>
      <li><a href="#compatibility" id="markdown-toc-compatibility">Compatibility</a></li>
    </ul>
  </li>
  <li><a href="#intention-locks-is-and-ix" id="markdown-toc-intention-locks-is-and-ix">Intention Locks (IS and IX)</a>    <ul>
      <li><a href="#why-intention-locks-are-needed" id="markdown-toc-why-intention-locks-are-needed">Why Intention Locks are Needed</a></li>
      <li><a href="#lock-compatibility" id="markdown-toc-lock-compatibility">Lock Compatibility</a></li>
    </ul>
  </li>
  <li><a href="#record-locks" id="markdown-toc-record-locks">Record Locks</a>    <ul>
      <li><a href="#innodb-index" id="markdown-toc-innodb-index">InnoDB Index</a></li>
    </ul>
  </li>
  <li><a href="#gap-locks" id="markdown-toc-gap-locks">Gap Locks</a>    <ul>
      <li><a href="#drawback-of-gap-locks" id="markdown-toc-drawback-of-gap-locks">Drawback of Gap Locks</a></li>
    </ul>
  </li>
  <li><a href="#next-key-locks" id="markdown-toc-next-key-locks">Next-Key Locks</a></li>
  <li><a href="#examples" id="markdown-toc-examples">Examples</a>    <ul>
      <li><a href="#example-1-unique-index-vs-non-unique-index" id="markdown-toc-example-1-unique-index-vs-non-unique-index">Example 1: Unique Index vs Non-Unique Index</a></li>
      <li><a href="#example-2-full-table-scan-and-locks" id="markdown-toc-example-2-full-table-scan-and-locks">Example 2: Full Table Scan and Locks</a></li>
      <li><a href="#example-3-how-insert-works-with-locks" id="markdown-toc-example-3-how-insert-works-with-locks">Example 3: How INSERT works with locks</a></li>
    </ul>
  </li>
  <li><a href="#references" id="markdown-toc-references">References</a></li>
</ul>

  </nav>
</aside>

<h2 id="exclusive-locks-x-and-shared-locks-s">Exclusive Locks (X) and Shared Locks (S)</h2>

<h3 id="exclusive-locks-x">Exclusive Locks (X)</h3>

<p>As the name suggests, exclusive lock is a type of lock that <strong>prevents any other transaction from locking the same row</strong>.</p>

<p>It means that no other transaction can READ or WRITE to that resource until the lock is released (but this depends on the isolation level). InnoDB’s REPEATABLE READ allows tx to read rows with X locks (<strong>consistent read</strong> technique).</p>

<h3 id="shared-locks-s">Shared Locks (S)</h3>

<p>Shared Lock (S) allows other transactions to READ the locked object and acquire shared locks on it, but not to write to it.</p>

<p>It means that multiple transactions can hold shared locks on the same resource at the same time, allowing them to read the data concurrently.</p>

<h3 id="compatibility">Compatibility</h3>

<p>Row lock can be either shared or exclusive. The compatibility of locks is as follows:</p>

<ul>
  <li>Shared (S) locks are compatible with other shared locks, but not with exclusive locks (X). 1 row can have <strong>multiple shared locks</strong> at the same time.</li>
  <li>Exclusive (X) locks are not compatible with any other (X and S) locks. 1 row can only have <strong>one exclusive lock</strong> at a time.</li>
</ul>

<h2 id="intention-locks-is-and-ix">Intention Locks (IS and IX)</h2>

<p>Intention Lock is a table-level lock that indicates a transaction’s intention to acquire row-level locks on a table (either shared or exclusive). So there are 2 types of intention locks:</p>

<ul>
  <li>
    <p>Intention Shared Lock (IS): a transaction intends to acquire shared locks (S) on rows in the table. E.g., <code class="language-plaintext highlighter-rouge">SELECT ... FOR SHARE</code></p>
  </li>
  <li>
    <p>Intention Exclusive Lock (IX): a transaction intends to acquire exclusive locks (X) on rows in the table. E.g., <code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code></p>
  </li>
</ul>

<p>Intention locks <strong>do not lock the whole table</strong>, but they mark that there exists a transaction that wants to lock rows in this table. This allows further transactions to know that they cannot acquire conflicting locks on the table without having to check every row, which improves efficiency.</p>

<h3 id="why-intention-locks-are-needed">Why Intention Locks are Needed</h3>

<p>Simply put, an intention lock isn’t used to lock the new row; it is used to ask permission to enter the neighborhood and to provide a structured way to wait in line if the neighborhood is currently blocked.</p>

<p>For example, when a transaction wants to insert the number <code class="language-plaintext highlighter-rouge">5</code> into a gap between <code class="language-plaintext highlighter-rouge">4</code> and <code class="language-plaintext highlighter-rouge">7</code>: The row <code class="language-plaintext highlighter-rouge">5</code> does not exist yet. Since an exclusive lock (X) is a record lock (meaning it must be physically attached to and existing slot or key in the index tree), there is <strong>no physical data structure for an exclusive lock to latch onto</strong> yet. Therefore, MySQL must lock the gap <code class="language-plaintext highlighter-rouge">(4, 7)</code> instead.</p>

<p>==&gt; Hence The insert intention lock acts as the placeholder on the gap until the physical row is created. And it allows other transactions to insert into the same gap concurrently, as long as they are not trying to insert the same value.</p>

<h3 id="lock-compatibility">Lock Compatibility</h3>

<table>
  <thead>
    <tr>
      <th style="text-align: left"> </th>
      <th style="text-align: center">X</th>
      <th style="text-align: center">IX</th>
      <th style="text-align: center">S</th>
      <th style="text-align: center">IS</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left"><strong>X</strong></td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">X</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>IX</strong></td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">OK</td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">OK</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>S</strong></td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">OK</td>
      <td style="text-align: center">OK</td>
    </tr>
    <tr>
      <td style="text-align: left"><strong>IS</strong></td>
      <td style="text-align: center">X</td>
      <td style="text-align: center">OK</td>
      <td style="text-align: center">OK</td>
      <td style="text-align: center">OK</td>
    </tr>
  </tbody>
</table>

<h2 id="record-locks">Record Locks</h2>

<p>Record lock is a lock on an <strong>index</strong> record (not actual data row, but its index record). E.g, <code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code> or <code class="language-plaintext highlighter-rouge">SELECT ... FOR SHARE</code> will acquire record locks on the index records of the selected rows.</p>

<p>Note: record locks always lock index records, even if table has no index. InnoDB will create a hidden clustered index and use it for locking.</p>

<h3 id="innodb-index">InnoDB Index</h3>

<ul>
  <li>Clustered Index: associated with the primary key (PK) of the table. The data rows are stored in the leaf nodes of the clustered index.
    <ul>
      <li>If there is no PK, InnoDB will choose first UNIQUE NOT NULL column as the clustered index.</li>
      <li>If there is no PK + UNIQUE column, InnoDB will create a hidden clustered index.</li>
    </ul>
  </li>
  <li>Secondary Index: any Indexes other than the clustered index. Each record of a secondary index contains the indexed column values and <strong>its PK</strong>.</li>
</ul>

<h2 id="gap-locks">Gap Locks</h2>

<p>Gap lock is a lock on the <strong>gap between index records</strong>. Its main GOAL is to <strong>prevent insertion</strong> of new rows into the gap range -&gt; preventing <strong>PHANTOM READ</strong>.</p>

<p><img src="/images/blogs/mysqllock/gap-lock.png" alt="gap-lock" /></p>

<p>E.g, <code class="language-plaintext highlighter-rouge">SELECT ... WHERE id BETWEEN 10 AND 20 FOR UPDATE</code> will acquire gap locks on the range (10, 20) and prevent insertions of new rows into that range.</p>

<p>NOTE: Gap lock can coexist even with conflicting types. For example, transaction A can hold a shared gap lock (gap S-lock) on a gap while transaction B holds an exclusive gap lock (gap X-lock) on the same gap. Because gap locks’ only purpose is to prevent insertions, and they do not conflict with each other in terms of reading or writing existing rows.</p>

<p>==&gt; There is no difference between shared (S) and exclusive (X) gap locks.</p>

<h3 id="drawback-of-gap-locks">Drawback of Gap Locks</h3>

<p>Gap locks can lead to <strong>deadlocks</strong> in certain scenarios. For example:</p>

<ul>
  <li>Tx A holds a gap lock on (10, 20), Tx B holds a gap lock on (10, 20)</li>
  <li>Now Tx A wants to insert a new row with id=15, it must wait for tx B to release its gap lock.</li>
  <li>But Tx B also wants to insert a new row with id=12, it must wait for tx A to release its gap lock.
==&gt; This creates a deadlock</li>
</ul>

<p>How to avoid deadlocks caused by gap locks:</p>

<ul>
  <li>Use <strong>lower isolation levels</strong>: consider using READ COMMITTED instead of REPEATABLE READ to reduce the use of gap locks.</li>
  <li>Use <strong>consistent locking order</strong>: always lock rows in the same order across transactions.</li>
  <li>Use <strong>short transactions</strong>: keep transactions as short as possible to reduce the chance of deadlocks.</li>
</ul>

<h2 id="next-key-locks">Next-Key Locks</h2>

<p>Next key lock is a combination of Record Lock + Gap Lock <strong>before the index record.</strong> That is, a next-key lock is an index-record lock plus a gap lock on the gap preceding the index record.</p>

<p>MySQL performs row-level locking on index records it scans through.</p>

<p>Example: given index contains 5, 9, 10, and 20. Possible next-key locks cover the following ranges: <code class="language-plaintext highlighter-rouge">(-inf, 5]</code>, <code class="language-plaintext highlighter-rouge">(5, 9]</code>, <code class="language-plaintext highlighter-rouge">(9, 10]</code>, <code class="language-plaintext highlighter-rouge">(10, 20]</code>, and <code class="language-plaintext highlighter-rouge">(20, +inf)</code>. Query <code class="language-plaintext highlighter-rouge">SELECT ... WHERE id &gt; 10 FOR UPDATE</code> will acquire next-key locks on <code class="language-plaintext highlighter-rouge">(10, 20]</code> and <code class="language-plaintext highlighter-rouge">(20, +inf)</code>.</p>

<h2 id="examples">Examples</h2>

<h3 id="example-1-unique-index-vs-non-unique-index">Example 1: Unique Index vs Non-Unique Index</h3>

<p>Assume an InnoDB index (<code class="language-plaintext highlighter-rouge">REPEATABLE READ</code>) contains: <code class="language-plaintext highlighter-rouge">10, 20, 30, 50</code></p>

<ul>
  <li>Query: <code class="language-plaintext highlighter-rouge">SELECT ... WHERE id = 20 FOR UPDATE;</code>
    <ul>
      <li>On an <strong>UNIQUE</strong> index, InnoDB will acquire a <strong>record lock only</strong> on <code class="language-plaintext highlighter-rouge">20</code>. No gap lock is needed because a unique index guarantees that no additional row with id = 20 can be inserted.</li>
      <li>On a <strong>non-unique</strong> index, InnoDB will acquire a <strong>next-key lock</strong> on <code class="language-plaintext highlighter-rouge">(10, 20]</code> and a record lock on <code class="language-plaintext highlighter-rouge">20</code> to prevent insertion of new rows with id = 20.</li>
    </ul>
  </li>
  <li>Query: <code class="language-plaintext highlighter-rouge">SELECT ... WHERE id BETWEEN 15 AND 35 FOR UPDATE;</code>
    <ul>
      <li>
        <p>InnoDB will acquire next-key locks on the ranges <code class="language-plaintext highlighter-rouge">(10, 20]</code> and <code class="language-plaintext highlighter-rouge">(20, 30]</code>, which also locks the rows <code class="language-plaintext highlighter-rouge">20</code> and <code class="language-plaintext highlighter-rouge">30</code> (record locks).</p>
      </li>
      <li>
        <p>Using next-key lock, the resulting behavior is as follows:</p>
        <ul>
          <li>Block <strong>Insert inside gap:</strong> <code class="language-plaintext highlighter-rouge">INSERT ... VALUES (25);</code></li>
          <li>Block <strong>Update locked record:</strong> <code class="language-plaintext highlighter-rouge">UPDATE ... WHERE age = 30;</code></li>
          <li>Block <strong>Move into gap:</strong> <code class="language-plaintext highlighter-rouge">UPDATE ... SET age = 25 WHERE age = 10;</code></li>
        </ul>
      </li>
    </ul>
  </li>
</ul>

<p>Conditions for using next-key locks:</p>

<ul>
  <li>The table uses <strong>InnoDB</strong> and isolation level is <strong><code class="language-plaintext highlighter-rouge">REPEATABLE READ</code></strong>.</li>
  <li>The statement is a locking operation such as <code class="language-plaintext highlighter-rouge">SELECT ... FOR UPDATE</code>, <code class="language-plaintext highlighter-rouge">UPDATE</code>, or <code class="language-plaintext highlighter-rouge">DELETE</code>.</li>
  <li>The query performs a range or nonunique-index scan.</li>
  <li>The execution plan uses the relevant index.</li>
</ul>

<p>A plain <code class="language-plaintext highlighter-rouge">SELECT</code> normally uses an MVCC snapshot (I will cover this in another topic about MySQL’s isolation level) and does not acquire these locks. An exact lookup using a complete unique index usually acquires only a record lock.</p>

<h3 id="example-2-full-table-scan-and-locks">Example 2: Full Table Scan and Locks</h3>

<p>Assume a table with index on column <code class="language-plaintext highlighter-rouge">address</code> but not <code class="language-plaintext highlighter-rouge">nickname</code>. The table definition is as follows:</p>

<p><img src="/images/blogs/mysqllock/table.png" alt="alt text" /></p>

<ul>
  <li>Query: <code class="language-plaintext highlighter-rouge">UPDATE member SET age = 30 WHERE address='HN' AND nickname='T';</code>
    <ul>
      <li>Since there is no index on <code class="language-plaintext highlighter-rouge">nickname</code>, InnoDB will perform a full table scan and acquire <strong>next-key locks</strong> on all rows that match the condition <code class="language-plaintext highlighter-rouge">address='HN'</code>. In this case, all write operations with <code class="language-plaintext highlighter-rouge">address='HN'</code> will be blocked until the transaction is committed or rolled back. ==&gt; This can impact concurrency performance.</li>
    </ul>
  </li>
</ul>

<p>What happens if the table does not have an index? In this case, the <code class="language-plaintext highlighter-rouge">UPDATE</code> operation is performed by <strong>full scanning</strong> the table, and locks are set <strong>on all table records</strong>.</p>

<p>==&gt; So index could affect not only query performance but also concurrency performance, and must be designed well to avoid unnecessary locks.</p>

<h3 id="example-3-how-insert-works-with-locks">Example 3: How INSERT works with locks</h3>

<p>Assume application performs multiple <code class="language-plaintext highlighter-rouge">INSERT</code> operations simultaneously with the same PK value. For example, two transactions try to insert a row with <code class="language-plaintext highlighter-rouge">id=10</code> at the same time:</p>

<div class="language-sql highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">--- TX1</span>
<span class="k">INSERT</span> <span class="k">INTO</span> <span class="n">users</span><span class="p">(</span><span class="n">id</span><span class="p">)</span> <span class="k">VALUES</span> <span class="p">(</span><span class="mi">10</span><span class="p">);</span>

<span class="c1">--- TX2</span>
<span class="k">INSERT</span> <span class="k">INTO</span> <span class="n">users</span><span class="p">(</span><span class="n">id</span><span class="p">)</span> <span class="k">VALUES</span> <span class="p">(</span><span class="mi">10</span><span class="p">);</span>
</code></pre></div></div>

<p>Locks Acquired by <code class="language-plaintext highlighter-rouge">INSERT</code>:</p>

<ul>
  <li>an <strong>insert-intention lock</strong> on the target index gap ==&gt; allows other transactions to insert into the same gap concurrently</li>
  <li>an <strong>exclusive record lock</strong> (X) on the inserted row</li>
</ul>

<p>So, without loss of generality, assume <code class="language-plaintext highlighter-rouge">T1</code> inserts the row and holds an exclusive lock (X) on <code class="language-plaintext highlighter-rouge">id = 10</code>. Hence <code class="language-plaintext highlighter-rouge">T2</code> must wait, and when <code class="language-plaintext highlighter-rouge">T1</code> commits, <code class="language-plaintext highlighter-rouge">T2</code> will try to insert the same row but fails because of <strong>duplicate key error</strong>.</p>

<h2 id="references">References</h2>

<ul>
  <li><a href="https://dev.mysql.com/doc/refman/8.4/en/innodb-locking.html">MySQL 8.4 Reference Manual: Locking</a></li>
  <li><a href="https://dev.to/eyochen/a-straightforward-guide-for-mysql-locks-56i1">Straightforward Guide for MySQL Locks</a></li>
  <li><a href="https://blog.csdn.net/qq_20597727/article/details/87308709">CSDN Article on MySQL Locks</a></li>
  <li><a href="https://ksh-coding.tistory.com/124">Tistory Article on MySQL Locks</a></li>
</ul>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Computer Science" /><category term="Database" /><summary type="html"><![CDATA[Below are some notes on MySQL Locks concepts, I will not go into the very details underneath and cover every single lock type, but I will give you a quick overview of the most common locks and how they work.]]></summary></entry><entry><title type="html">Kubernetes 101</title><link href="https://hoangtl.site/posts/k8s-101/" rel="alternate" type="text/html" title="Kubernetes 101" /><published>2026-03-05T00:00:00+00:00</published><updated>2026-03-05T00:00:00+00:00</updated><id>https://hoangtl.site/posts/k8s-101</id><content type="html" xml:base="https://hoangtl.site/posts/k8s-101/"><![CDATA[<p>This article introduces the basics of Kubernetes, including its architecture, key components, and how it can be used to manage containerized applications. This post is based on my understanding of Kubernetes and its docs. Feel free to leave any feedback or corrections in the comments.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#1-introduction-to-container-orchestration" id="markdown-toc-1-introduction-to-container-orchestration">1. Introduction to Container Orchestration</a></li>
  <li><a href="#2-kubernetes-architecture-overview" id="markdown-toc-2-kubernetes-architecture-overview">2. Kubernetes Architecture Overview</a>    <ul>
      <li><a href="#21-control-plane" id="markdown-toc-21-control-plane">2.1. Control Plane</a></li>
      <li><a href="#22-worker-nodes" id="markdown-toc-22-worker-nodes">2.2. Worker Nodes</a></li>
      <li><a href="#23-interacting-with-k8s-cluster" id="markdown-toc-23-interacting-with-k8s-cluster">2.3. Interacting with K8s cluster</a></li>
      <li><a href="#24-how-k8s-runs-your-application" id="markdown-toc-24-how-k8s-runs-your-application">2.4. How K8s runs your application</a></li>
    </ul>
  </li>
  <li><a href="#3-kubernetes-objects" id="markdown-toc-3-kubernetes-objects">3. Kubernetes Objects</a>    <ul>
      <li><a href="#31-pod" id="markdown-toc-31-pod">3.1. Pod</a></li>
      <li><a href="#32-replicaset" id="markdown-toc-32-replicaset">3.2. ReplicaSet</a></li>
      <li><a href="#33-deployment" id="markdown-toc-33-deployment">3.3. Deployment</a></li>
      <li><a href="#34-service" id="markdown-toc-34-service">3.4. Service</a>        <ul>
          <li><a href="#341-clusterip" id="markdown-toc-341-clusterip">3.4.1. ClusterIP</a></li>
          <li><a href="#342-nodeport" id="markdown-toc-342-nodeport">3.4.2. NodePort</a></li>
          <li><a href="#343-loadbalancer" id="markdown-toc-343-loadbalancer">3.4.3. LoadBalancer</a></li>
        </ul>
      </li>
      <li><a href="#35-ingress" id="markdown-toc-35-ingress">3.5. Ingress</a></li>
      <li><a href="#36-k8s-volumes" id="markdown-toc-36-k8s-volumes">3.6. K8s Volumes</a></li>
      <li><a href="#37-configmap-and-secret" id="markdown-toc-37-configmap-and-secret">3.7. ConfigMap and Secret</a></li>
      <li><a href="#38-statefulset" id="markdown-toc-38-statefulset">3.8. StatefulSet</a></li>
    </ul>
  </li>
</ul>

  </nav>
</aside>

<h2 id="1-introduction-to-container-orchestration">1. Introduction to Container Orchestration</h2>

<p>The challenge of Managing containerized applications: creating a container image and managing from your local laptop is easy. But managing a <strong>cluster of containerized applications across multiple distributed nodes</strong> in productions is much harder.</p>

<p>But once you have dozens (or hundreds) of conta`iners running across multiple machines, new problems appear:</p>

<ul>
  <li>How do you deploy applications with <strong>horizontal scalability</strong> across multiple servers?</li>
  <li>How do you handle <strong>network connection</strong> between nodes and among containers?</li>
  <li>How do you handle <strong>monitoring, observability</strong> to ensure containers and nodes are resilient?</li>
  <li>How do you <strong>roll out new versions</strong> without service interruption?</li>
  <li>How do you <strong>group related containers</strong>?</li>
</ul>

<p>This is where <strong>container orchestration</strong> comes in. It automates the <strong>deployment, scaling and management</strong> of containerized applications across a cluster of machines.</p>

<p>Popular container orchestrators includes: <strong>Kubernetes (K8s)</strong>, Google GKE, AWS EKS, Azure AKS, Docker swarm. But we will focus on K8s in this post.</p>

<h2 id="2-kubernetes-architecture-overview">2. Kubernetes Architecture Overview</h2>

<p><img src="/images/blogs/k8s101/k8s-overview.png" alt="k8s_overview" /></p>

<p>A Kubernetes cluster contains 2 main parts: <strong>Control Plane nodes</strong> and <strong>Worker nodes</strong>.</p>

<p>The control plane makes decisions, while Worker nodes actually run your containers.</p>

<h3 id="21-control-plane">2.1. Control Plane</h3>

<p>The control plane is responsible for <strong>managing the entire K8s cluster</strong>. It coordinates all activities and communications with worker nodes to ensure desired state of the whole cluster.</p>

<p>The control plane core components:</p>

<ul>
  <li><strong>kube-apiserver</strong>:
    <ul>
      <li>Exposes K8s API</li>
      <li>Acts as the <strong>entry point</strong> and <strong>gatekeeper</strong> for the cluster</li>
      <li>Every interaction (from <code class="language-plaintext highlighter-rouge">kubectl</code>, <code class="language-plaintext highlighter-rouge">helm chart</code>, automation, …) goes through here. It validates and persists objects to etcd.</li>
    </ul>
  </li>
  <li><strong>kube-scheduler</strong>
    <ul>
      <li>Watches for newly created Pods that haven’t been assigned to a node yet, then <strong>picks the best node</strong> based on resource availability, taints, affinity rules, etc.</li>
    </ul>
  </li>
  <li><strong>etcd</strong>
    <ul>
      <li>A distributed key-value store.</li>
      <li>This is where <strong>entire</strong> cluster state (configurations, metadata) lives: nodes, pods, configs, secrets. If etcd goes down, the cluster can’t function.</li>
    </ul>
  </li>
  <li><strong>kube-controller-manager</strong>
    <ul>
      <li>Runs background controller that continuously ensure the actual cluster state matches the desired state. E.g: node health, replica counts, job completion.
        <ul>
          <li><strong>Node controller</strong> - notices when nodes go offline</li>
          <li><strong>ReplicaSet controller</strong> - ensures the right number of pod replicas are running</li>
          <li><strong>Endpoints controller</strong> - populates Service endpoints</li>
        </ul>
      </li>
    </ul>
  </li>
</ul>

<h3 id="22-worker-nodes">2.2. Worker Nodes</h3>

<p>Each worker node runs the following components:</p>

<ul>
  <li><strong>kubelet</strong>
    <ul>
      <li>An agent that runs on every node.</li>
      <li>It talks to the API server, receives Pod specs, and ensures containers are running and healthy via the container runtime.</li>
    </ul>
  </li>
  <li><strong>kube-proxy</strong>
    <ul>
      <li>Handles <strong>networking</strong> and <strong>service communication</strong></li>
      <li>Enables communication between Pods and Services across the cluster. It implements the virtual IP abstraction for Services, forwarding traffic to the correct Pod endpoints.</li>
    </ul>
  </li>
  <li><strong>Container runtime</strong>
    <ul>
      <li>The software that actually runs containers (e.g., <code class="language-plaintext highlighter-rouge">Docker</code>, <code class="language-plaintext highlighter-rouge">containerd</code>, …).</li>
    </ul>
  </li>
</ul>

<p>Note: <strong>kubelet</strong> and <strong>kube-proxy</strong> also run on control-plan nodes, but primary role is managing workloads on worker nodes. (since control-plane components themselves)</p>

<h3 id="23-interacting-with-k8s-cluster">2.3. Interacting with K8s cluster</h3>

<p><img src="/images/blogs/k8s101/k8s_interaction.png" alt="k8s_interaction" /></p>

<p>Developer interacts with <strong>API Server</strong> running on control plane node for administration and application management.</p>

<p>The primary tool for interacting with a Kubernetes cluster is <code class="language-plaintext highlighter-rouge">kubectl</code>, the CLI client (basically <code class="language-plaintext highlighter-rouge">curl</code>).</p>

<p>Users access the <strong>deployed applications</strong> running on <strong>worker nodes</strong> via <strong>kube-proxy</strong>.</p>

<p><code class="language-plaintext highlighter-rouge">kubectl</code> reads from a <strong>kubeconfig</strong> file (<code class="language-plaintext highlighter-rouge">~/.kube/config</code> by default) which contains cluster endpoints and credentials. You can manage multiple clusters using contexts:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># List available contexts</span>
kubectl config get-contexts

<span class="c"># Switch context</span>
kubectl config use-context my-cluster
</code></pre></div></div>

<ul>
  <li>Common Q/A:
    <ul>
      <li><em>What happens if control plan crashes?</em>
        <ul>
          <li>You the administrator ofcourse :D you should have set up multiple control plane nodes for HA. If one goes down, the others take over.</li>
          <li>Also, if a control plane crashes, <strong>cluster management halts</strong>: existing <strong>pods keep running</strong>, but no new pods can be scheduled, updated, or deleted, and API requests fail. While worker nodes continue running, <strong>the system cannot self-heal</strong> or scale, and recovery requires restoring the API server and etcd database to resume operations.</li>
        </ul>
      </li>
    </ul>
  </li>
</ul>

<h3 id="24-how-k8s-runs-your-application">2.4. How K8s runs your application</h3>

<p><img src="/images/blogs/k8s101/k8s-intro-diagram.png" alt="k8s-intro-diagram" /></p>

<p>Kubernetes deploys workloads by placing <strong>containers into Pods</strong></p>

<ul>
  <li><strong>Pods</strong> is smallest deployment unit, pods are <strong>scheduled</strong> to run on <strong>Nodes</strong></li>
  <li>Kubernetes continuously <strong>monitors</strong>: Application health, Node health, Desired vs actual state</li>
  <li>Kubernetes is <strong>declarative</strong>, you tell it what you want, not how to do it and the control plane makes it happen.</li>
</ul>

<p>At a high level, here’s the sequence of events when you run <code class="language-plaintext highlighter-rouge">kubectl apply -f deployment.yaml</code>:</p>

<p><img src="/images/blogs/k8s101/deploy-flow.png" alt="deploy-flow" /></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code>  <span class="s">kubectl apply -f deployment.yaml</span>
        <span class="s">│</span>
        <span class="s">▼</span>
  <span class="s">kube-apiserver   ← validates manifest, stores in etcd</span>
        <span class="s">│</span>
        <span class="s">▼</span>
  <span class="s">kube-controller-manager  ← ReplicaSet controller notices new Pods are needed</span>
        <span class="s">│</span>
        <span class="s">▼</span>
  <span class="s">kube-scheduler   ← assigns each Pod to a suitable Node</span>
        <span class="s">│</span>
        <span class="s">▼</span>
  <span class="s">kubelet (on Node) ← pulls image, starts container via container runtime</span>
        <span class="s">│</span>
        <span class="s">▼</span>
  <span class="s">Container is running 🚀</span>
</code></pre></div></div>

<ol>
  <li>You write a <strong>YAML manifest</strong> describing the desired state (e.g., “run 3 replicas of my-app using image <code class="language-plaintext highlighter-rouge">my-app:1.2.0</code>”).</li>
  <li>You submit it to the <strong>API server</strong>, which authenticates, validates &amp; persists desired state in <strong>etcd</strong>.
    <ul>
      <li><strong>etcd</strong> maintains the source of truth for the cluster state.</li>
    </ul>
  </li>
  <li>The <strong>scheduler</strong> spots the unscheduled Pods in etcd and <strong>selects best worker nodes</strong> based on constraints, returns the <strong>scheduling decision</strong> to the API Server.</li>
  <li><strong>API Server</strong> persists the scheduling decision back to etcd, triggers <strong>kubelet</strong> on the assigned node.</li>
  <li>The <strong>kubelet</strong> on assigned node pulls image and runs workload inside a pod.</li>
  <li>The cluster (<strong>kube-controller-manager</strong>) continuously monitors the actual state and reconciles any drift - if a container crashes, it’s restarted automatically.</li>
</ol>

<h2 id="3-kubernetes-objects">3. Kubernetes Objects</h2>

<p><strong>Kubernetes objects</strong> represent the <strong>resources</strong> that <strong>define</strong> and run applications inside a cluster. They are defined in YAML manifests and managed via the API server.</p>

<p>Every object has:</p>

<ul>
  <li><strong>apiVersion</strong> - Which <strong>version of the Kubernetes API</strong> you’re using to create this object</li>
  <li><strong>kind</strong> - the type of object (e.g: Deployment, Service, …)</li>
  <li><strong>metadata</strong> - data that helps uniquely identify the object (e.g: name, namespace, labels, annotations)
    <ul>
      <li><strong>name</strong> - unique name for the object within its namespace</li>
      <li><strong>namespace</strong> - specifies which namespace the object belongs to (default is <code class="language-plaintext highlighter-rouge">default</code>)</li>
      <li><strong>labels</strong> - key-value pairs used for grouping and selecting objects (e.g: <code class="language-plaintext highlighter-rouge">app: my-app</code>, <code class="language-plaintext highlighter-rouge">env: production</code>)</li>
    </ul>
  </li>
  <li><strong>spec</strong> - the desired state you’re declaring, <strong>technical details</strong>, including image, applications, ports, etc.</li>
</ul>

<p><img src="/images/blogs/k8s101/k8s-yaml.png" alt="k8s-yaml" /></p>

<h3 id="31-pod">3.1. Pod</h3>

<ul>
  <li>A <strong>Pod</strong> is the smallest deployable unit in Kubernetes, an abstraction over a container.</li>
  <li>It wraps one or more tightly coupled containers that share the <strong>same network namespace (same IP address) and storage.</strong></li>
  <li>Kubernetes manages Pods, not individual containers.</li>
  <li><strong>Pods are ephemeral</strong> - it can crash for any reason, <strong>kubelet</strong> coordinates with API Server to start a new pod if it is managed by ReplicaSet or Deployment.</li>
  <li>
    <p>New pod = new cluster IP address</p>
  </li>
  <li>E.g: In practice, most Pods run a single container. Multi-container Pods are used for sidecar patterns (e.g., a logging agent alongside your app).</li>
</ul>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Pod</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-app-pod</span>
  <span class="na">labels</span><span class="pi">:</span>
    <span class="na">app</span><span class="pi">:</span> <span class="s">my-app</span>
    <span class="na">env</span><span class="pi">:</span> <span class="s">production</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">containers</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">my-app</span>
      <span class="na">image</span><span class="pi">:</span> <span class="s">my-app:1.2.0</span>
      <span class="na">ports</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">containerPort</span><span class="pi">:</span> <span class="m">8080</span>
      <span class="na">resources</span><span class="pi">:</span>
        <span class="na">requests</span><span class="pi">:</span>
          <span class="na">cpu</span><span class="pi">:</span> <span class="s2">"</span><span class="s">100m"</span>
          <span class="na">memory</span><span class="pi">:</span> <span class="s2">"</span><span class="s">128Mi"</span>
        <span class="na">limits</span><span class="pi">:</span>
          <span class="na">cpu</span><span class="pi">:</span> <span class="s2">"</span><span class="s">500m"</span>
          <span class="na">memory</span><span class="pi">:</span> <span class="s2">"</span><span class="s">256Mi"</span>
</code></pre></div></div>

<h3 id="32-replicaset">3.2. ReplicaSet</h3>

<p>A <strong>ReplicaSet</strong> ensures <strong>how many replicas</strong> of a pod should be running (<code class="language-plaintext highlighter-rouge">spec.replicas</code>).</p>

<p>The <code class="language-plaintext highlighter-rouge">selector.matchLabels</code> field is how the ReplicaSet knows which Pods it <strong>owns</strong>. It will create or delete Pods until the count matches <code class="language-plaintext highlighter-rouge">replicas</code>. Example:</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">apps/v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">ReplicaSet</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">frontend</span>
  <span class="na">labels</span><span class="pi">:</span> <span class="c1"># labels on the ReplicaSet itself, not the pods it manages</span>
    <span class="na">app</span><span class="pi">:</span> <span class="s">guestbook</span>
    <span class="na">tier</span><span class="pi">:</span> <span class="s">frontend</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="c1"># modify replicas according to your case</span>
  <span class="na">replicas</span><span class="pi">:</span> <span class="m">3</span>
  <span class="na">selector</span><span class="pi">:</span>
    <span class="na">matchLabels</span><span class="pi">:</span> <span class="c1"># which existing Pods belong to this ReplicaSet</span>
      <span class="na">tier</span><span class="pi">:</span> <span class="s">frontend</span>
  <span class="na">template</span><span class="pi">:</span> <span class="c1"># When the ReplicaSet needs more Pods, it creates them using this template.</span>
    <span class="na">metadata</span><span class="pi">:</span>
      <span class="c1"># new pods created by this ReplicaSet will have these labels</span>
      <span class="c1"># must match the selector.matchLabels above</span>
      <span class="na">labels</span><span class="pi">:</span> 
        <span class="na">tier</span><span class="pi">:</span> <span class="s">frontend</span>
    <span class="na">spec</span><span class="pi">:</span>
      <span class="na">containers</span><span class="pi">:</span>
      <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">php-redis</span>
        <span class="na">image</span><span class="pi">:</span> <span class="s">us-docker.pkg.dev/google-samples/containers/gke/gb-frontend:v5</span>
</code></pre></div></div>

<ul>
  <li>ReplicaSet checks all Pods with label <code class="language-plaintext highlighter-rouge">tier=frontend</code></li>
  <li>If there are less than 3, it creates new Pods using the template <code class="language-plaintext highlighter-rouge">spec.template</code></li>
  <li>Those Pods get the same label: <code class="language-plaintext highlighter-rouge">tier=frontend</code></li>
  <li>Now they match the selector → ReplicaSet manages them.</li>
</ul>

<p><strong>In practice, you rarely create ReplicaSets directly.</strong> You use a <strong>Deployment</strong>, which manages ReplicaSets for you and adds rolling-update capabilities.</p>

<h3 id="33-deployment">3.3. Deployment</h3>

<p>A <strong>Deployment</strong> manages <strong>ReplicaSets</strong> and provides a level of abstraction above <strong>ReplicaSet</strong>, which manages pods.</p>

<p>Creating deployment = creating ReplicaSets + pods</p>

<p>Deployment runs pods/containers, but it <strong>won’t expose any IP address or port#</strong>. You need to create a <strong>Service</strong> for that.</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">apps/v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Deployment</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">nginx-deployment</span> <span class="c1"># name of the deployment object</span>
  <span class="na">labels</span><span class="pi">:</span>
    <span class="na">app</span><span class="pi">:</span> <span class="s">nginx</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">replicas</span><span class="pi">:</span> <span class="m">3</span>
  <span class="c1"># .spec.selector must match .spec.template.metadata.labels</span>
  <span class="na">selector</span><span class="pi">:</span> <span class="c1"># specifies a label selector for the Pods targeted by this Deployment</span>
    <span class="na">matchLabels</span><span class="pi">:</span>
      <span class="na">app</span><span class="pi">:</span> <span class="s">nginx</span>
  <span class="na">template</span><span class="pi">:</span> <span class="c1"># pod template </span>
    <span class="na">metadata</span><span class="pi">:</span>
      <span class="na">labels</span><span class="pi">:</span> <span class="c1"># labels for the pods created by this deployment, must match the selector above</span>
        <span class="na">app</span><span class="pi">:</span> <span class="s">nginx</span>
    <span class="na">spec</span><span class="pi">:</span>
      <span class="na">containers</span><span class="pi">:</span> <span class="c1"># list of containers in the pod</span>
      <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">nginx</span>
        <span class="na">image</span><span class="pi">:</span> <span class="s">nginx:1.14.2</span>
        <span class="na">ports</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">containerPort</span><span class="pi">:</span> <span class="m">80</span>

</code></pre></div></div>

<p>Note:</p>

<ul>
  <li>The <code class="language-plaintext highlighter-rouge">selector</code> field is required in a Deployment. It tells the Deployment which Pods to manage. The <code class="language-plaintext highlighter-rouge">template.metadata.labels</code> must match the <code class="language-plaintext highlighter-rouge">selector.matchLabels</code> for the Deployment to work correctly.</li>
  <li>You should not create other Pods whose labels match this selector, either directly, by creating another Deployment -&gt; controllers will fight and won’t behave correctly.</li>
</ul>

<h3 id="34-service">3.4. Service</h3>

<blockquote>
  <p>Pods are ephemeral - their IP addresses change when they restart. This is where <strong>Services</strong> come in.</p>
</blockquote>

<p><strong>Service</strong> defines a <strong>stable DNS name</strong> and <strong>stable IP address</strong> to communicate with <strong>a group of pod</strong> instances. It acts as a <strong>virtual load balancer</strong> that distributes traffic to the healthy pods matching its selector.</p>

<p><strong>Service</strong> and <strong>Pod</strong> life cycle are <strong>not connected</strong>. If a pod dies, the Service and its IP address still stay. So we can use a Service to <strong>expose workload inside or outside</strong> the cluster.</p>

<p>Within the cluster, Services are discoverable by DNS. A Service named <code class="language-plaintext highlighter-rouge">my-app-service</code> in namespace <code class="language-plaintext highlighter-rouge">default</code> is reachable at <code class="language-plaintext highlighter-rouge">my-app-service.default.svc.cluster.local</code> (or just <code class="language-plaintext highlighter-rouge">my-app-service</code> from within the same namespace).</p>

<p><strong>Service types:</strong></p>

<h4 id="341-clusterip">3.4.1. ClusterIP</h4>

<p><img src="/images/blogs/k8s101/k8s-service.png" alt="k8s service" /></p>

<p>It gives you a service inside your cluster that other apps inside your cluster can access. There is no external access. However, you can access it from outside the cluster using <code class="language-plaintext highlighter-rouge">kubectl proxy --port=xxxx</code> for debugging internal pods and development.</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Service</span>
<span class="na">metadata</span><span class="pi">:</span>  
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-internal-service</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">selector</span><span class="pi">:</span>    
    <span class="na">app</span><span class="pi">:</span> <span class="s">my-app</span> <span class="c1"># select pods with label app=my-app</span>
  <span class="na">type</span><span class="pi">:</span> <span class="s">ClusterIP</span>
  <span class="na">ports</span><span class="pi">:</span>  
  <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">http</span>
    <span class="na">port</span><span class="pi">:</span> <span class="m">80</span> <span class="c1"># the port that the service will listen on</span>
    <span class="na">targetPort</span><span class="pi">:</span> <span class="m">80</span> <span class="c1"># the port on the pod that the service will forward to</span>
    <span class="na">protocol</span><span class="pi">:</span> <span class="s">TCP</span>
</code></pre></div></div>

<h4 id="342-nodeport">3.4.2. NodePort</h4>

<p><img src="/images/blogs/k8s101/k8s-node-port.png" alt="node port" />
<img src="/images/blogs/k8s101/k8s-node-port2.png" alt="node port" /></p>

<p>Opens a specific <strong>port on all Nodes</strong>, and any traffic that is sent to this port is forwarded to the cluster IP service. Accessible from outside the cluster at <code class="language-plaintext highlighter-rouge">&lt;NodeIP&gt;:&lt;NodePort&gt;</code>.</p>

<p><strong>Cons</strong>: you can only have 1 service per NodePort, range is limited (30000-32767), and you need to manage load balancing across nodes yourself.</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Service</span>
<span class="na">metadata</span><span class="pi">:</span>  
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-nodeport-service</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">selector</span><span class="pi">:</span>    
    <span class="na">app</span><span class="pi">:</span> <span class="s">my-app</span> <span class="c1"># select pods with label app=my-app</span>
  <span class="na">type</span><span class="pi">:</span> <span class="s">NodePort</span>
  <span class="na">ports</span><span class="pi">:</span>  
  <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">http</span>
    <span class="na">port</span><span class="pi">:</span> <span class="m">80</span> <span class="c1"># the port that the service will listen on</span>
    <span class="na">targetPort</span><span class="pi">:</span> <span class="m">80</span> <span class="c1"># the port on the pod that the service will forward to</span>
    <span class="na">nodePort</span><span class="pi">:</span> <span class="m">30036</span> <span class="c1"># the port on each node to expose (must be in range 30000-32767)</span>
    <span class="na">protocol</span><span class="pi">:</span> <span class="s">TCP</span>
</code></pre></div></div>

<p><img src="/images/blogs/k8s101/node-port-deployment-diagram.png" alt="node port deployment" /></p>

<h4 id="343-loadbalancer">3.4.3. LoadBalancer</h4>

<p>Provisions an external load balancer (e.g., AWS ELB, GCP Load Balancer). The standard way to expose a service externally in cloud environments.</p>

<p>If your cluster is in a cloud, then Kubernetes first <strong>creates ClusterIP service</strong>, then <strong>opens high port</strong> on each node, and then <strong>reaches out to cloud provider’s API</strong> and <strong>configures a cloud load balancer</strong> with the host and port. Adding/removing nodes automatically updates load balancer config</p>

<blockquote>
  <p>Traffic -&gt; load balancer -&gt; NodePort -&gt; clusterIP service, -&gt; routed to the Pod</p>
</blockquote>

<p>Cons: each exposed service with a LoadBalancer will get its own IP address, and you have to pay for a LoadBalancer per exposed service, which can get expensive!</p>

<p>Note: LoadBalancer &gt; NodePort &gt; ClusterIP. When you create NodePort -&gt; it also creates ClusterIP. When you create LoadBalancer, it also creates NodePort and ClusterIP.</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Service</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-service</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">type</span><span class="pi">:</span> <span class="s">LoadBalancer</span>
  <span class="na">selector</span><span class="pi">:</span>
    <span class="na">app.kubernetes.io/name</span><span class="pi">:</span> <span class="s">MyApp</span> <span class="c1"># select pods with this label</span>
  <span class="na">ports</span><span class="pi">:</span> <span class="c1"># list of ports to expose</span>
    <span class="pi">-</span> <span class="na">protocol</span><span class="pi">:</span> <span class="s">TCP</span>
      <span class="na">port</span><span class="pi">:</span> <span class="m">80</span> <span class="c1"># the port that the service will listen on</span>
      <span class="na">targetPort</span><span class="pi">:</span> <span class="m">9376</span> <span class="c1"># port on the pod to forward to</span>
  <span class="na">clusterIP</span><span class="pi">:</span> <span class="s">10.0.171.239</span>
<span class="na">status</span><span class="pi">:</span>
  <span class="na">loadBalancer</span><span class="pi">:</span> <span class="c1"># contains the status of the load balancer provisioned by the cloud provider</span>
    <span class="na">ingress</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">ip</span><span class="pi">:</span> <span class="s">192.0.2.127</span>
</code></pre></div></div>

<h3 id="35-ingress">3.5. Ingress</h3>

<p><strong>Services</strong> handle east-west (internal) and basic north-south traffic. But for production HTTP/HTTPS routing from the internet, you use an <strong>Ingress</strong>.</p>

<p>An Ingress resource defines routing rules - path-based or host-based - to route external traffic to the right Services. It requires an <strong>Ingress Controller</strong> (e.g., NGINX Ingress Controller, Traefik) to be installed in the cluster to enforce those rules.</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">networking.k8s.io/v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Ingress</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-app-ingress</span>
  <span class="na">annotations</span><span class="pi">:</span>
    <span class="na">nginx.ingress.kubernetes.io/rewrite-target</span><span class="pi">:</span> <span class="s">/</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">ingressClassName</span><span class="pi">:</span> <span class="s">nginx</span>
  <span class="na">rules</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">host</span><span class="pi">:</span> <span class="s">myapp.example.com</span>
      <span class="na">http</span><span class="pi">:</span>
        <span class="na">paths</span><span class="pi">:</span>
          <span class="pi">-</span> <span class="na">path</span><span class="pi">:</span> <span class="s">/api</span>
            <span class="na">pathType</span><span class="pi">:</span> <span class="s">Prefix</span>
            <span class="na">backend</span><span class="pi">:</span>
              <span class="na">service</span><span class="pi">:</span>
                <span class="na">name</span><span class="pi">:</span> <span class="s">api-service</span>
                <span class="na">port</span><span class="pi">:</span>
                  <span class="na">number</span><span class="pi">:</span> <span class="m">80</span>
          <span class="pi">-</span> <span class="na">path</span><span class="pi">:</span> <span class="s">/</span>
            <span class="na">pathType</span><span class="pi">:</span> <span class="s">Prefix</span>
            <span class="na">backend</span><span class="pi">:</span>
              <span class="na">service</span><span class="pi">:</span>
                <span class="na">name</span><span class="pi">:</span> <span class="s">frontend-service</span>
                <span class="na">port</span><span class="pi">:</span>
                  <span class="na">number</span><span class="pi">:</span> <span class="m">80</span>
  <span class="na">tls</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">hosts</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="s">myapp.example.com</span>
      <span class="na">secretName</span><span class="pi">:</span> <span class="s">myapp-tls-secret</span>
</code></pre></div></div>

<p>The flow looks like this:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Internet → LoadBalancer → Ingress Controller Pod → Service → Pod
</code></pre></div></div>

<p>Key advantages of Ingress over a plain LoadBalancer Service:</p>
<ul>
  <li>One LoadBalancer IP can serve many hostnames/paths (cost saving)</li>
  <li>TLS termination in one place</li>
  <li>Annotations for rate limiting, authentication, etc.</li>
</ul>

<h3 id="36-k8s-volumes">3.6. K8s Volumes</h3>

<p>Containers have ephemeral filesystems - anything written inside a container is lost when it restarts. <strong>Volumes</strong> solve this.</p>

<p>A volume is mounted into a Pod’s container at a specified path. There are many volume types:</p>

<p><strong>emptyDir</strong> - Temporary storage that lives for the lifetime of the Pod. Useful for sharing files between containers in the same Pod.</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spec</span><span class="pi">:</span>
  <span class="na">volumes</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">shared-data</span>
      <span class="na">emptyDir</span><span class="pi">:</span> <span class="pi">{}</span>
  <span class="na">containers</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">app</span>
      <span class="na">volumeMounts</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">shared-data</span>
          <span class="na">mountPath</span><span class="pi">:</span> <span class="s">/data</span>
</code></pre></div></div>

<p><strong>hostPath</strong> - Mounts a directory from the host node’s filesystem. Useful for development but generally avoid in production (breaks portability).</p>

<p><strong>PersistentVolume (PV) and PersistentVolumeClaim (PVC)</strong> - The standard pattern for durable storage.</p>

<ul>
  <li>A <strong>PersistentVolume</strong> is a piece of storage provisioned in the cluster (manually or dynamically by a StorageClass).</li>
  <li>A <strong>PersistentVolumeClaim</strong> is a request for storage. Pods reference PVCs, not PVs directly.</li>
</ul>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># PersistentVolumeClaim</span>
<span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">PersistentVolumeClaim</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-data-pvc</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">accessModes</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="s">ReadWriteOnce</span>   <span class="c1"># only one node can mount this at a time</span>
  <span class="na">resources</span><span class="pi">:</span>
    <span class="na">requests</span><span class="pi">:</span>
      <span class="na">storage</span><span class="pi">:</span> <span class="s">10Gi</span>
  <span class="na">storageClassName</span><span class="pi">:</span> <span class="s">standard</span>
<span class="nn">---</span>
<span class="c1"># Reference PVC in a Pod</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">volumes</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">my-data</span>
      <span class="na">persistentVolumeClaim</span><span class="pi">:</span>
        <span class="na">claimName</span><span class="pi">:</span> <span class="s">my-data-pvc</span>
  <span class="na">containers</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">app</span>
      <span class="na">volumeMounts</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">my-data</span>
          <span class="na">mountPath</span><span class="pi">:</span> <span class="s">/var/lib/data</span>
</code></pre></div></div>

<p><strong>Access modes:</strong></p>
<ul>
  <li><code class="language-plaintext highlighter-rouge">ReadWriteOnce</code> - mounted as read-write by a single node</li>
  <li><code class="language-plaintext highlighter-rouge">ReadOnlyMany</code> - mounted read-only by many nodes</li>
  <li><code class="language-plaintext highlighter-rouge">ReadWriteMany</code> - mounted read-write by many nodes (requires a distributed filesystem like NFS or EFS)</li>
</ul>

<h3 id="37-configmap-and-secret">3.7. ConfigMap and Secret</h3>

<p>Hardcoding configuration into container images is bad practice. Kubernetes provides two objects for externalizing config.</p>

<p><strong>ConfigMap</strong> - stores non-sensitive configuration as key-value pairs.</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">ConfigMap</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">app-config</span>
<span class="na">data</span><span class="pi">:</span>
  <span class="na">APP_ENV</span><span class="pi">:</span> <span class="s">production</span>
  <span class="na">LOG_LEVEL</span><span class="pi">:</span> <span class="s">info</span>
  <span class="na">DB_HOST</span><span class="pi">:</span> <span class="s">postgres-service</span>
  <span class="na">config.yaml</span><span class="pi">:</span> <span class="pi">|</span>
    <span class="s">server:</span>
      <span class="s">port: 8080</span>
      <span class="s">timeout: 30s</span>
</code></pre></div></div>

<p><strong>Secret</strong> - stores sensitive data (passwords, tokens, certificates). Values are base64-encoded (not encrypted by default - enable encryption at rest in production).</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Secret</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">app-secrets</span>
<span class="na">type</span><span class="pi">:</span> <span class="s">Opaque</span>
<span class="na">data</span><span class="pi">:</span>
  <span class="na">DB_PASSWORD</span><span class="pi">:</span> <span class="s">cGFzc3dvcmQxMjM=</span>  <span class="c1"># base64("password123")</span>
  <span class="na">API_KEY</span><span class="pi">:</span> <span class="s">c3VwZXJzZWNyZXQ=</span>
</code></pre></div></div>

<p>You can consume ConfigMaps and Secrets in Pods as environment variables or mounted files:</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spec</span><span class="pi">:</span>
  <span class="na">containers</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">app</span>
      <span class="na">image</span><span class="pi">:</span> <span class="s">my-app:1.2.0</span>
      <span class="c1"># Option 1: inject all keys as env vars</span>
      <span class="na">envFrom</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">configMapRef</span><span class="pi">:</span>
            <span class="na">name</span><span class="pi">:</span> <span class="s">app-config</span>
        <span class="pi">-</span> <span class="na">secretRef</span><span class="pi">:</span>
            <span class="na">name</span><span class="pi">:</span> <span class="s">app-secrets</span>
      <span class="c1"># Option 2: inject specific keys</span>
      <span class="na">env</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">LOG_LEVEL</span>
          <span class="na">valueFrom</span><span class="pi">:</span>
            <span class="na">configMapKeyRef</span><span class="pi">:</span>
              <span class="na">name</span><span class="pi">:</span> <span class="s">app-config</span>
              <span class="na">key</span><span class="pi">:</span> <span class="s">LOG_LEVEL</span>
      <span class="c1"># Option 3: mount as files</span>
      <span class="na">volumeMounts</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">config-volume</span>
          <span class="na">mountPath</span><span class="pi">:</span> <span class="s">/etc/config</span>
  <span class="na">volumes</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">config-volume</span>
      <span class="na">configMap</span><span class="pi">:</span>
        <span class="na">name</span><span class="pi">:</span> <span class="s">app-config</span>
</code></pre></div></div>

<p>A few important notes:</p>
<ul>
  <li><strong>Never commit Secrets</strong> directly to version control. Use a secrets management tool like HashiCorp Vault, Sealed Secrets, or cloud KMS integration.</li>
  <li>Mounting as files is useful when your app expects config files rather than env vars.</li>
  <li>ConfigMap updates don’t automatically propagate to running Pods when consumed as env vars - you need to restart the Pod. When mounted as a file, updates <em>do</em> propagate (with a short delay).</li>
</ul>

<h3 id="38-statefulset">3.8. StatefulSet</h3>

<p>Deployments are great for stateless applications. For stateful workloads - databases, message queues, distributed systems - you use a <strong>StatefulSet</strong>.</p>

<p>StatefulSets provide:</p>
<ul>
  <li><strong>Stable, unique Pod names</strong> - <code class="language-plaintext highlighter-rouge">my-db-0</code>, <code class="language-plaintext highlighter-rouge">my-db-1</code>, <code class="language-plaintext highlighter-rouge">my-db-2</code> (not random hashes)</li>
  <li><strong>Stable network identities</strong> - each Pod gets a predictable DNS entry: <code class="language-plaintext highlighter-rouge">my-db-0.my-db-service.default.svc.cluster.local</code></li>
  <li><strong>Ordered, graceful deployment and scaling</strong> - Pods are created/deleted one at a time in order</li>
  <li><strong>Per-Pod PVCs</strong> via <code class="language-plaintext highlighter-rouge">volumeClaimTemplates</code> - each Pod gets its own persistent volume</li>
</ul>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">apps/v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">StatefulSet</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-db</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">serviceName</span><span class="pi">:</span> <span class="s">my-db-service</span>   <span class="c1"># headless service for DNS</span>
  <span class="na">replicas</span><span class="pi">:</span> <span class="m">3</span>
  <span class="na">selector</span><span class="pi">:</span>
    <span class="na">matchLabels</span><span class="pi">:</span>
      <span class="na">app</span><span class="pi">:</span> <span class="s">my-db</span>
  <span class="na">template</span><span class="pi">:</span>
    <span class="na">metadata</span><span class="pi">:</span>
      <span class="na">labels</span><span class="pi">:</span>
        <span class="na">app</span><span class="pi">:</span> <span class="s">my-db</span>
    <span class="na">spec</span><span class="pi">:</span>
      <span class="na">containers</span><span class="pi">:</span>
        <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">my-db</span>
          <span class="na">image</span><span class="pi">:</span> <span class="s">postgres:16</span>
          <span class="na">ports</span><span class="pi">:</span>
            <span class="pi">-</span> <span class="na">containerPort</span><span class="pi">:</span> <span class="m">5432</span>
          <span class="na">env</span><span class="pi">:</span>
            <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">POSTGRES_PASSWORD</span>
              <span class="na">valueFrom</span><span class="pi">:</span>
                <span class="na">secretKeyRef</span><span class="pi">:</span>
                  <span class="na">name</span><span class="pi">:</span> <span class="s">app-secrets</span>
                  <span class="na">key</span><span class="pi">:</span> <span class="s">DB_PASSWORD</span>
          <span class="na">volumeMounts</span><span class="pi">:</span>
            <span class="pi">-</span> <span class="na">name</span><span class="pi">:</span> <span class="s">data</span>
              <span class="na">mountPath</span><span class="pi">:</span> <span class="s">/var/lib/postgresql/data</span>
  <span class="na">volumeClaimTemplates</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">metadata</span><span class="pi">:</span>
        <span class="na">name</span><span class="pi">:</span> <span class="s">data</span>
      <span class="na">spec</span><span class="pi">:</span>
        <span class="na">accessModes</span><span class="pi">:</span> <span class="pi">[</span><span class="s2">"</span><span class="s">ReadWriteOnce"</span><span class="pi">]</span>
        <span class="na">resources</span><span class="pi">:</span>
          <span class="na">requests</span><span class="pi">:</span>
            <span class="na">storage</span><span class="pi">:</span> <span class="s">20Gi</span>
</code></pre></div></div>

<p>StatefulSets require a <strong>headless Service</strong> (a Service with <code class="language-plaintext highlighter-rouge">clusterIP: None</code>) to provide the stable DNS for each Pod:</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">apiVersion</span><span class="pi">:</span> <span class="s">v1</span>
<span class="na">kind</span><span class="pi">:</span> <span class="s">Service</span>
<span class="na">metadata</span><span class="pi">:</span>
  <span class="na">name</span><span class="pi">:</span> <span class="s">my-db-service</span>
<span class="na">spec</span><span class="pi">:</span>
  <span class="na">clusterIP</span><span class="pi">:</span> <span class="s">None</span>        <span class="c1"># headless</span>
  <span class="na">selector</span><span class="pi">:</span>
    <span class="na">app</span><span class="pi">:</span> <span class="s">my-db</span>
  <span class="na">ports</span><span class="pi">:</span>
    <span class="pi">-</span> <span class="na">port</span><span class="pi">:</span> <span class="m">5432</span>
</code></pre></div></div>

<p><strong>When to use StatefulSet vs Deployment:</strong></p>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>Deployment</th>
      <th>StatefulSet</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Pod identity</td>
      <td>Random names, ephemeral IPs</td>
      <td>Stable names and DNS</td>
    </tr>
    <tr>
      <td>Storage</td>
      <td>Shared or no persistent storage</td>
      <td>Dedicated PVC per pod</td>
    </tr>
    <tr>
      <td>Scaling</td>
      <td>Any order</td>
      <td>Sequential (0 → 1 → 2)</td>
    </tr>
    <tr>
      <td>Use case</td>
      <td>Stateless apps, APIs</td>
      <td>Databases, Kafka, ZooKeeper</td>
    </tr>
  </tbody>
</table>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Kubernetes" /><category term="Devops" /><category term="Best Practices" /><summary type="html"><![CDATA[This article introduces the basics of Kubernetes, including its architecture, key components, and how it can be used to manage containerized applications. This post is based on my understanding of Kubernetes and its docs. Feel free to leave any feedback or corrections in the comments.]]></summary></entry><entry><title type="html">Spring Kafka Error Handling, with Best Practices</title><link href="https://hoangtl.site/posts/spring-kafka-error-handling/" rel="alternate" type="text/html" title="Spring Kafka Error Handling, with Best Practices" /><published>2026-02-14T00:00:00+00:00</published><updated>2026-02-14T00:00:00+00:00</updated><id>https://hoangtl.site/posts/spring-kafka-error-handling</id><content type="html" xml:base="https://hoangtl.site/posts/spring-kafka-error-handling/"><![CDATA[<p>This article covers error handling strategies in Spring Kafka, including offset management, retry mechanisms, dead letter topics, batch error handling, and common pitfalls to avoid when building resilient Kafka consumers.</p>

<p>Note that: <strong>This article is AI-generated</strong> based on the latest Spring Kafka documentation and best practices from several references.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#1-understanding-error-handlers" id="markdown-toc-1-understanding-error-handlers">1. Understanding Error Handlers</a>    <ul>
      <li><a href="#11-the-basics" id="markdown-toc-11-the-basics">1.1. The Basics</a></li>
      <li><a href="#12-defaulterrorhandler-overview" id="markdown-toc-12-defaulterrorhandler-overview">1.2. DefaultErrorHandler Overview</a></li>
    </ul>
  </li>
  <li><a href="#2-offset-commit-strategies" id="markdown-toc-2-offset-commit-strategies">2. Offset Commit Strategies</a>    <ul>
      <li><a href="#21-understanding-ackmode" id="markdown-toc-21-understanding-ackmode">2.1. Understanding AckMode</a></li>
      <li><a href="#22-batch-mode-default" id="markdown-toc-22-batch-mode-default">2.2. BATCH Mode (Default)</a></li>
      <li><a href="#23-record-mode" id="markdown-toc-23-record-mode">2.3. RECORD Mode</a></li>
      <li><a href="#24-manual_immediate-mode" id="markdown-toc-24-manual_immediate-mode">2.4. MANUAL_IMMEDIATE Mode</a></li>
      <li><a href="#25-async-acknowledgments-async-acks" id="markdown-toc-25-async-acknowledgments-async-acks">2.5. Async Acknowledgments (async-acks)</a></li>
    </ul>
  </li>
  <li><a href="#3-dead-letter-topics-dlt" id="markdown-toc-3-dead-letter-topics-dlt">3. Dead Letter Topics (DLT)</a>    <ul>
      <li><a href="#31-publishing-failed-records-to-dlt" id="markdown-toc-31-publishing-failed-records-to-dlt">3.1. Publishing Failed Records to DLT</a></li>
      <li><a href="#32-custom-dlt-routing" id="markdown-toc-32-custom-dlt-routing">3.2. Custom DLT Routing</a></li>
      <li><a href="#33-dlt-headers" id="markdown-toc-33-dlt-headers">3.3. DLT Headers</a></li>
      <li><a href="#34-skipping-retries-for-specific-exceptions" id="markdown-toc-34-skipping-retries-for-specific-exceptions">3.4. Skipping Retries for Specific Exceptions</a></li>
    </ul>
  </li>
  <li><a href="#4-batch-listener-error-handling" id="markdown-toc-4-batch-listener-error-handling">4. Batch Listener Error Handling</a>    <ul>
      <li><a href="#41-using-batchlistenerfailedexception" id="markdown-toc-41-using-batchlistenerfailedexception">4.1. Using BatchListenerFailedException</a></li>
      <li><a href="#42-batch-error-handler-configuration" id="markdown-toc-42-batch-error-handler-configuration">4.2. Batch Error Handler Configuration</a></li>
      <li><a href="#43-how-batch-error-handling-works" id="markdown-toc-43-how-batch-error-handling-works">4.3. How Batch Error Handling Works</a></li>
      <li><a href="#44-batch-processing-with-thread-pools" id="markdown-toc-44-batch-processing-with-thread-pools">4.4. Batch Processing with Thread Pools</a>        <ul>
          <li><a href="#441-the-challenge" id="markdown-toc-441-the-challenge">4.4.1. The Challenge</a></li>
          <li><a href="#442-reliable-async-batch-processing" id="markdown-toc-442-reliable-async-batch-processing">4.4.2. Reliable Async Batch Processing</a></li>
          <li><a href="#443-per-record-acknowledgment-with-async-processing" id="markdown-toc-443-per-record-acknowledgment-with-async-processing">4.4.3. Per-Record Acknowledgment with Async Processing</a></li>
          <li><a href="#444-retry-strategy-for-async-batch-processing" id="markdown-toc-444-retry-strategy-for-async-batch-processing">4.4.4. Retry Strategy for Async Batch Processing</a></li>
          <li><a href="#445-trade-offs-analysis" id="markdown-toc-445-trade-offs-analysis">4.4.5. Trade-offs Analysis</a></li>
          <li><a href="#446-monitoring-and-observability" id="markdown-toc-446-monitoring-and-observability">4.4.6. Monitoring and Observability</a></li>
        </ul>
      </li>
    </ul>
  </li>
  <li><a href="#5-deserialization-error-handling" id="markdown-toc-5-deserialization-error-handling">5. Deserialization Error Handling</a>    <ul>
      <li><a href="#51-using-errorhandlingdeserializer" id="markdown-toc-51-using-errorhandlingdeserializer">5.1. Using ErrorHandlingDeserializer</a></li>
      <li><a href="#52-handling-deserialization-failures" id="markdown-toc-52-handling-deserialization-failures">5.2. Handling Deserialization Failures</a></li>
      <li><a href="#53-conversion-errors" id="markdown-toc-53-conversion-errors">5.3. Conversion Errors</a></li>
    </ul>
  </li>
  <li><a href="#6-backoff-strategies" id="markdown-toc-6-backoff-strategies">6. Backoff Strategies</a>    <ul>
      <li><a href="#61-fixed-backoff" id="markdown-toc-61-fixed-backoff">6.1. Fixed Backoff</a></li>
      <li><a href="#62-exponential-backoff" id="markdown-toc-62-exponential-backoff">6.2. Exponential Backoff</a></li>
      <li><a href="#63-custom-backoff-based-on-exception" id="markdown-toc-63-custom-backoff-based-on-exception">6.3. Custom Backoff Based on Exception</a></li>
    </ul>
  </li>
  <li><a href="#7-common-pitfalls-and-best-practices" id="markdown-toc-7-common-pitfalls-and-best-practices">7. Common Pitfalls and Best Practices</a>    <ul>
      <li><a href="#71-losing-messages-with-async-processing" id="markdown-toc-71-losing-messages-with-async-processing">7.1. Losing Messages with Async Processing</a></li>
      <li><a href="#72-message-duplicates-after-restart" id="markdown-toc-72-message-duplicates-after-restart">7.2. Message Duplicates After Restart</a></li>
      <li><a href="#73-forgetting-to-configure-dlt-topics" id="markdown-toc-73-forgetting-to-configure-dlt-topics">7.3. Forgetting to Configure DLT Topics</a></li>
      <li><a href="#74-not-setting-immediate-stop-for-long-processing" id="markdown-toc-74-not-setting-immediate-stop-for-long-processing">7.4. Not Setting Immediate Stop for Long Processing</a></li>
      <li><a href="#75-batch-listener-without-batchlistenerfailedexception" id="markdown-toc-75-batch-listener-without-batchlistenerfailedexception">7.5. Batch Listener without BatchListenerFailedException</a></li>
    </ul>
  </li>
  <li><a href="#8-production-configuration-example" id="markdown-toc-8-production-configuration-example">8. Production Configuration Example</a></li>
  <li><a href="#9-final-thoughts" id="markdown-toc-9-final-thoughts">9. Final Thoughts</a></li>
  <li><a href="#10-references" id="markdown-toc-10-references">10. References</a></li>
</ul>

  </nav>
</aside>

<h2 id="1-understanding-error-handlers">1. Understanding Error Handlers</h2>

<h3 id="11-the-basics">1.1. The Basics</h3>

<p>Spring Kafka provides container-level error handlers that catch exceptions thrown by your <code class="language-plaintext highlighter-rouge">@KafkaListener</code> methods. These handlers determine what happens when message processing fails.</p>

<p>Starting with version 2.8, Spring Kafka introduced <code class="language-plaintext highlighter-rouge">CommonErrorHandler</code> to replace the legacy <code class="language-plaintext highlighter-rouge">ErrorHandler</code> and <code class="language-plaintext highlighter-rouge">BatchErrorHandler</code> interfaces. This unified approach handles both record and batch listeners with a single configuration.</p>

<p><strong>Key points:</strong></p>

<ul>
  <li>The error handler runs after your listener throws an exception</li>
  <li>By default, <code class="language-plaintext highlighter-rouge">DefaultErrorHandler</code> is used with 10 retry attempts</li>
  <li>Error handlers can seek back to failed offsets or skip records entirely</li>
  <li>Works for both transactional and non-transactional listeners</li>
</ul>

<h3 id="12-defaulterrorhandler-overview">1.2. DefaultErrorHandler Overview</h3>

<p>The <code class="language-plaintext highlighter-rouge">DefaultErrorHandler</code> replaced <code class="language-plaintext highlighter-rouge">SeekToCurrentErrorHandler</code> and <code class="language-plaintext highlighter-rouge">RecoveringBatchErrorHandler</code>. It provides retry logic with configurable backoff strategies.</p>

<p><strong>Default behavior:</strong></p>

<ul>
  <li>10 retry attempts with no delay between attempts</li>
  <li>After retries exhausted → logs the failed record at ERROR level</li>
  <li>By default, seeks back to the failed offset for redelivery</li>
  <li>Can be configured with a custom recoverer (like publishing to DLT)</li>
</ul>

<p><strong>Basic configuration example:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Bean</span>
<span class="kd">public</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">kafkaListenerContainerFactory</span><span class="o">(</span>
        <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">consumerFactory</span><span class="o">)</span> <span class="o">{</span>
    
    <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">factory</span> <span class="o">=</span> 
        <span class="k">new</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;&gt;();</span>
    <span class="n">factory</span><span class="o">.</span><span class="na">setConsumerFactory</span><span class="o">(</span><span class="n">consumerFactory</span><span class="o">);</span>
    
    <span class="c1">// Configure error handler with 3 retry attempts, 1 second between retries</span>
    <span class="nc">DefaultErrorHandler</span> <span class="n">errorHandler</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DefaultErrorHandler</span><span class="o">(</span>
        <span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">1000L</span><span class="o">,</span> <span class="mi">2L</span><span class="o">)</span>  <span class="c1">// 1s delay, 2 retries = 3 total attempts</span>
    <span class="o">);</span>
    
    <span class="n">factory</span><span class="o">.</span><span class="na">setCommonErrorHandler</span><span class="o">(</span><span class="n">errorHandler</span><span class="o">);</span>
    <span class="k">return</span> <span class="n">factory</span><span class="o">;</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Fatal exceptions</strong> — these skip retries entirely:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">DeserializationException</code></li>
  <li><code class="language-plaintext highlighter-rouge">MessageConversionException</code></li>
  <li><code class="language-plaintext highlighter-rouge">ConversionException</code></li>
  <li><code class="language-plaintext highlighter-rouge">MethodArgumentResolutionException</code></li>
  <li><code class="language-plaintext highlighter-rouge">NoSuchMethodException</code></li>
  <li><code class="language-plaintext highlighter-rouge">ClassCastException</code></li>
</ul>

<p>These are considered fatal because retrying won’t fix the issue. The recoverer is invoked immediately.</p>

<h2 id="2-offset-commit-strategies">2. Offset Commit Strategies</h2>

<h3 id="21-understanding-ackmode">2.1. Understanding AckMode</h3>

<p>Spring Kafka provides different acknowledgment modes that control when offsets are committed. This is critical for understanding message delivery guarantees.</p>

<p><strong>Important:</strong> By default, Spring Kafka sets <code class="language-plaintext highlighter-rouge">enable.auto.commit=false</code>. The framework manages offset commits, not Kafka itself.</p>

<p><strong>Available AckMode values:</strong></p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">BATCH</code> (default) — Commits offset when all records from the poll are processed</li>
  <li><code class="language-plaintext highlighter-rouge">RECORD</code> — Commits offset after each record is processed</li>
  <li><code class="language-plaintext highlighter-rouge">MANUAL</code> — Application calls <code class="language-plaintext highlighter-rouge">Acknowledgment.acknowledge()</code>, commit happens when the whole batch completes</li>
  <li><code class="language-plaintext highlighter-rouge">MANUAL_IMMEDIATE</code> — Application calls <code class="language-plaintext highlighter-rouge">Acknowledgment.acknowledge()</code>, commit happens immediately</li>
</ul>

<h3 id="22-batch-mode-default">2.2. BATCH Mode (Default)</h3>

<p>With <code class="language-plaintext highlighter-rouge">BATCH</code> mode, Spring Kafka processes messages one by one but only commits the offset after the entire batch from the poll completes.</p>

<p><strong>Use case:</strong></p>

<ul>
  <li>Best for throughput</li>
  <li>Acceptable to reprocess some messages after failures</li>
  <li>Handles most standard scenarios</li>
</ul>

<p><strong>Properties:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">listener</span><span class="pi">:</span>
      <span class="na">ack-mode</span><span class="pi">:</span> <span class="s">BATCH</span>  <span class="c1"># This is the default</span>
</code></pre></div></div>

<p><strong>Behavior:</strong></p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Poll returns: [msg1, msg2, msg3, msg4, msg5]
Process msg1 → success
Process msg2 → success
Process msg3 → FAILURE
</code></pre></div></div>

<p>What happens:</p>

<ol>
  <li>Container commits offsets for msg1 and msg2</li>
  <li>Error handler seeks back to offset for msg3</li>
  <li>Next poll returns [msg3, msg4, msg5] again</li>
  <li>If app crashes before commit → msg1 and msg2 will be reprocessed</li>
</ol>

<p><strong>Trade-off:</strong> Higher throughput, but potential for duplicate processing if the consumer crashes between processing and commit.</p>

<h3 id="23-record-mode">2.3. RECORD Mode</h3>

<p>With <code class="language-plaintext highlighter-rouge">RECORD</code> mode, the offset is committed immediately after each message is processed successfully.</p>

<p><strong>Use case:</strong></p>

<ul>
  <li>Minimize duplicate processing after restarts</li>
  <li>Each message is expensive to process</li>
  <li>You can tolerate lower throughput</li>
</ul>

<p><strong>Properties:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">listener</span><span class="pi">:</span>
      <span class="na">ack-mode</span><span class="pi">:</span> <span class="s">RECORD</span>
</code></pre></div></div>

<p><strong>Behavior:</strong></p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Process msg1 → commit offset for msg1
Process msg2 → commit offset for msg2
Process msg3 → FAILURE → error handling
</code></pre></div></div>

<p><strong>Trade-off:</strong> Lower throughput (more commits), but fewer duplicates after failures.</p>

<h3 id="24-manual_immediate-mode">2.4. MANUAL_IMMEDIATE Mode</h3>

<p>This gives you full control. You decide exactly when to commit offsets by calling <code class="language-plaintext highlighter-rouge">Acknowledgment.acknowledge()</code>.</p>

<p><strong>Use case:</strong></p>

<ul>
  <li>Processing messages asynchronously with custom thread pools</li>
  <li>Need precise control over commit timing</li>
  <li>Building exactly-once semantics with external state</li>
</ul>

<p><strong>Properties:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">listener</span><span class="pi">:</span>
      <span class="na">ack-mode</span><span class="pi">:</span> <span class="s">MANUAL_IMMEDIATE</span>
</code></pre></div></div>

<p><strong>Example code:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span> <span class="n">groupId</span> <span class="o">=</span> <span class="s">"order-processor"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">listen</span><span class="o">(</span><span class="nd">@Payload</span> <span class="nc">Order</span> <span class="n">order</span><span class="o">,</span>
                   <span class="nc">Acknowledgment</span> <span class="n">acknowledgment</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">try</span> <span class="o">{</span>
        <span class="n">processOrder</span><span class="o">(</span><span class="n">order</span><span class="o">);</span>
        <span class="c1">// Only commit if processing succeeds</span>
        <span class="n">acknowledgment</span><span class="o">.</span><span class="na">acknowledge</span><span class="o">();</span>
    <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Failed to process order: {}"</span><span class="o">,</span> <span class="n">order</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
        <span class="c1">// Don't acknowledge → message will be redelivered</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Async processing example:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Service</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">AsyncListener</span> <span class="o">{</span>

    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">ExecutorService</span> <span class="n">executorService</span> <span class="o">=</span> 
        <span class="nc">Executors</span><span class="o">.</span><span class="na">newFixedThreadPool</span><span class="o">(</span><span class="mi">20</span><span class="o">);</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">OrderProcessor</span> <span class="n">processor</span><span class="o">;</span>
    
    <span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">)</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">listenAsync</span><span class="o">(</span><span class="nd">@Payload</span> <span class="nc">Order</span> <span class="n">order</span><span class="o">,</span>
                           <span class="nc">Acknowledgment</span> <span class="n">acknowledgment</span><span class="o">)</span> <span class="o">{</span>
        <span class="c1">// Submit to thread pool</span>
        <span class="n">executorService</span><span class="o">.</span><span class="na">submit</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
            <span class="k">try</span> <span class="o">{</span>
                <span class="n">processor</span><span class="o">.</span><span class="na">process</span><span class="o">(</span><span class="n">order</span><span class="o">);</span>
                <span class="c1">// Acknowledge after async processing completes</span>
                <span class="n">acknowledgment</span><span class="o">.</span><span class="na">acknowledge</span><span class="o">();</span>
            <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Async processing failed"</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
                <span class="c1">// Don't acknowledge</span>
            <span class="o">}</span>
        <span class="o">});</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="25-async-acknowledgments-async-acks">2.5. Async Acknowledgments (async-acks)</h3>

<p>By default, out-of-order acknowledgments are disabled. If you’re using <code class="language-plaintext highlighter-rouge">MANUAL</code> or <code class="language-plaintext highlighter-rouge">MANUAL_IMMEDIATE</code> with async processing, you might want to enable this.</p>

<p><strong>Properties:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">listener</span><span class="pi">:</span>
      <span class="na">ack-mode</span><span class="pi">:</span> <span class="s">MANUAL_IMMEDIATE</span>
      <span class="na">async-acks</span><span class="pi">:</span> <span class="no">true</span>  <span class="c1"># Allow out-of-order commits</span>
</code></pre></div></div>

<p><strong>When to use:</strong></p>

<ul>
  <li>Processing messages with a custom thread pool</li>
  <li>Messages can complete in different order than received</li>
  <li>High-throughput scenarios where ordering isn’t critical</li>
</ul>

<p><strong>Warning:</strong> Enabling <code class="language-plaintext highlighter-rouge">async-acks</code> means offsets might be committed out of order. If message 5 finishes before message 3, offset 5 gets committed first. If the app crashes, message 3 and 4 might not be redelivered.</p>

<h2 id="3-dead-letter-topics-dlt">3. Dead Letter Topics (DLT)</h2>

<h3 id="31-publishing-failed-records-to-dlt">3.1. Publishing Failed Records to DLT</h3>

<p>After retries are exhausted, you typically want to send failed messages somewhere for later analysis rather than just logging them.</p>

<p><code class="language-plaintext highlighter-rouge">DeadLetterPublishingRecoverer</code> publishes failed records to a dead letter topic.</p>

<p><strong>Basic setup:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Bean</span>
<span class="kd">public</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">kafkaListenerContainerFactory</span><span class="o">(</span>
        <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">consumerFactory</span><span class="o">,</span>
        <span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">kafkaTemplate</span><span class="o">)</span> <span class="o">{</span>
    
    <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">factory</span> <span class="o">=</span> 
        <span class="k">new</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;&gt;();</span>
    <span class="n">factory</span><span class="o">.</span><span class="na">setConsumerFactory</span><span class="o">(</span><span class="n">consumerFactory</span><span class="o">);</span>
    
    <span class="c1">// Create recoverer that sends to DLT</span>
    <span class="nc">DeadLetterPublishingRecoverer</span> <span class="n">recoverer</span> <span class="o">=</span> 
        <span class="k">new</span> <span class="nf">DeadLetterPublishingRecoverer</span><span class="o">(</span><span class="n">kafkaTemplate</span><span class="o">);</span>
    
    <span class="c1">// Create error handler with recoverer</span>
    <span class="nc">DefaultErrorHandler</span> <span class="n">errorHandler</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DefaultErrorHandler</span><span class="o">(</span>
        <span class="n">recoverer</span><span class="o">,</span>
        <span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">1000L</span><span class="o">,</span> <span class="mi">2L</span><span class="o">)</span>  <span class="c1">// 3 attempts: initial + 2 retries</span>
    <span class="o">);</span>
    
    <span class="n">factory</span><span class="o">.</span><span class="na">setCommonErrorHandler</span><span class="o">(</span><span class="n">errorHandler</span><span class="o">);</span>
    <span class="k">return</span> <span class="n">factory</span><span class="o">;</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Default behavior:</strong></p>

<ul>
  <li>Failed records are sent to <code class="language-plaintext highlighter-rouge">&lt;originalTopic&gt;.DLT</code></li>
  <li>Same partition as original record</li>
  <li>DLT topic must have at least as many partitions as original topic</li>
</ul>

<h3 id="32-custom-dlt-routing">3.2. Custom DLT Routing</h3>

<p>You can customize which DLT to use based on the exception type or record content.</p>

<p><strong>Example:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">DeadLetterPublishingRecoverer</span> <span class="n">recoverer</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DeadLetterPublishingRecoverer</span><span class="o">(</span>
    <span class="n">kafkaTemplate</span><span class="o">,</span>
    <span class="o">(</span><span class="n">record</span><span class="o">,</span> <span class="n">exception</span><span class="o">)</span> <span class="o">-&gt;</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">exception</span><span class="o">.</span><span class="na">getCause</span><span class="o">()</span> <span class="k">instanceof</span> <span class="nc">ValidationException</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">return</span> <span class="k">new</span> <span class="nf">TopicPartition</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">()</span> <span class="o">+</span> <span class="s">".validation.DLT"</span><span class="o">,</span> <span class="n">record</span><span class="o">.</span><span class="na">partition</span><span class="o">());</span>
        <span class="o">}</span> <span class="k">else</span> <span class="k">if</span> <span class="o">(</span><span class="n">exception</span><span class="o">.</span><span class="na">getCause</span><span class="o">()</span> <span class="k">instanceof</span> <span class="nc">DatabaseException</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">return</span> <span class="k">new</span> <span class="nf">TopicPartition</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">()</span> <span class="o">+</span> <span class="s">".database.DLT"</span><span class="o">,</span> <span class="n">record</span><span class="o">.</span><span class="na">partition</span><span class="o">());</span>
        <span class="o">}</span> <span class="k">else</span> <span class="o">{</span>
            <span class="k">return</span> <span class="k">new</span> <span class="nf">TopicPartition</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">()</span> <span class="o">+</span> <span class="s">".DLT"</span><span class="o">,</span> <span class="n">record</span><span class="o">.</span><span class="na">partition</span><span class="o">());</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">);</span>
</code></pre></div></div>

<h3 id="33-dlt-headers">3.3. DLT Headers</h3>

<p>The recoverer adds several headers to the DLT record for debugging:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-exception-fqcn</code> — Exception class name</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-exception-cause-fqcn</code> — Root cause class name</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-exception-message</code> — Exception message</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-exception-stacktrace</code> — Full stack trace</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-original-topic</code> — Original topic name</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-original-partition</code> — Original partition</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-original-offset</code> — Original offset</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-original-timestamp</code> — Original timestamp</li>
  <li><code class="language-plaintext highlighter-rouge">kafka_dlt-original-consumer-group</code> — Consumer group</li>
</ul>

<p><strong>These headers help you:</strong></p>

<ul>
  <li>Debug what went wrong</li>
  <li>Know where the message came from</li>
  <li>Implement retry logic from the DLT later</li>
</ul>

<h3 id="34-skipping-retries-for-specific-exceptions">3.4. Skipping Retries for Specific Exceptions</h3>

<p>The <code class="language-plaintext highlighter-rouge">DefaultErrorHandler</code> considers certain exceptions fatal by default. You can add your own.</p>

<p><strong>Example:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Bean</span>
<span class="kd">public</span> <span class="nc">DefaultErrorHandler</span> <span class="nf">errorHandler</span><span class="o">(</span>
        <span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">kafkaTemplate</span><span class="o">)</span> <span class="o">{</span>
    
    <span class="nc">DeadLetterPublishingRecoverer</span> <span class="n">recoverer</span> <span class="o">=</span> 
        <span class="k">new</span> <span class="nf">DeadLetterPublishingRecoverer</span><span class="o">(</span><span class="n">kafkaTemplate</span><span class="o">);</span>
    
    <span class="nc">DefaultErrorHandler</span> <span class="n">handler</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DefaultErrorHandler</span><span class="o">(</span>
        <span class="n">recoverer</span><span class="o">,</span>
        <span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">1000L</span><span class="o">,</span> <span class="mi">2L</span><span class="o">)</span>
    <span class="o">);</span>
    
    <span class="c1">// Add custom non-retryable exceptions</span>
    <span class="n">handler</span><span class="o">.</span><span class="na">addNotRetryableExceptions</span><span class="o">(</span>
        <span class="nc">IllegalArgumentException</span><span class="o">.</span><span class="na">class</span><span class="o">,</span>
        <span class="nc">ValidationException</span><span class="o">.</span><span class="na">class</span><span class="o">,</span>
        <span class="nc">BadRequestException</span><span class="o">.</span><span class="na">class</span>
    <span class="o">);</span>
    
    <span class="k">return</span> <span class="n">handler</span><span class="o">;</span>
<span class="o">}</span>
</code></pre></div></div>

<p>Now these exceptions skip retries and go straight to the DLT on first failure.</p>

<h2 id="4-batch-listener-error-handling">4. Batch Listener Error Handling</h2>

<h3 id="41-using-batchlistenerfailedexception">4.1. Using BatchListenerFailedException</h3>

<p>For batch listeners, you must throw <code class="language-plaintext highlighter-rouge">BatchListenerFailedException</code> to indicate which specific record in the batch failed.</p>

<p><strong>Basic batch listener:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span>
    <span class="n">id</span> <span class="o">=</span> <span class="s">"order-batch-processor"</span><span class="o">,</span>
    <span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span>
    <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchFactory"</span>
<span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span><span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">records</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">for</span> <span class="o">(</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span> <span class="o">:</span> <span class="n">records</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="n">processOrder</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">());</span>
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="c1">// Identify the failed record</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">BatchListenerFailedException</span><span class="o">(</span><span class="s">"Failed to process"</span><span class="o">,</span> <span class="n">e</span><span class="o">,</span> <span class="n">record</span><span class="o">);</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>For POJO batch listeners</strong> (no <code class="language-plaintext highlighter-rouge">ConsumerRecord</code>):</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span> <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchFactory"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span><span class="nc">List</span><span class="o">&lt;</span><span class="nc">Order</span><span class="o">&gt;</span> <span class="n">orders</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">orders</span><span class="o">.</span><span class="na">size</span><span class="o">();</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="n">processOrder</span><span class="o">(</span><span class="n">orders</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">));</span>
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="c1">// Use index instead of record</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">BatchListenerFailedException</span><span class="o">(</span><span class="s">"Failed to process"</span><span class="o">,</span> <span class="n">e</span><span class="o">,</span> <span class="n">i</span><span class="o">);</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="42-batch-error-handler-configuration">4.2. Batch Error Handler Configuration</h3>

<p>Configure the batch factory with error handling:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Bean</span>
<span class="kd">public</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">batchFactory</span><span class="o">(</span>
        <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">consumerFactory</span><span class="o">,</span>
        <span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">kafkaTemplate</span><span class="o">)</span> <span class="o">{</span>
    
    <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">factory</span> <span class="o">=</span> 
        <span class="k">new</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;&gt;();</span>
    <span class="n">factory</span><span class="o">.</span><span class="na">setConsumerFactory</span><span class="o">(</span><span class="n">consumerFactory</span><span class="o">);</span>
    <span class="n">factory</span><span class="o">.</span><span class="na">setBatchListener</span><span class="o">(</span><span class="kc">true</span><span class="o">);</span>  <span class="c1">// Enable batch mode</span>
    
    <span class="nc">DeadLetterPublishingRecoverer</span> <span class="n">recoverer</span> <span class="o">=</span> 
        <span class="k">new</span> <span class="nf">DeadLetterPublishingRecoverer</span><span class="o">(</span><span class="n">kafkaTemplate</span><span class="o">);</span>
    
    <span class="nc">DefaultErrorHandler</span> <span class="n">errorHandler</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DefaultErrorHandler</span><span class="o">(</span>
        <span class="n">recoverer</span><span class="o">,</span>
        <span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">1000L</span><span class="o">,</span> <span class="mi">2L</span><span class="o">)</span>
    <span class="o">);</span>
    
    <span class="n">factory</span><span class="o">.</span><span class="na">setCommonErrorHandler</span><span class="o">(</span><span class="n">errorHandler</span><span class="o">);</span>
    <span class="k">return</span> <span class="n">factory</span><span class="o">;</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="43-how-batch-error-handling-works">4.3. How Batch Error Handling Works</h3>

<p>When a record in a batch fails:</p>

<ol>
  <li>Offsets for records before the failed record are committed</li>
  <li>Failed record (and remaining records) are retried according to BackOff</li>
  <li>After retries exhausted → only the failed record goes to DLT</li>
  <li>Failed record’s offset is committed</li>
  <li>Remaining records are redelivered for processing</li>
</ol>

<p><strong>Example flow:</strong></p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Batch: [msg1, msg2, msg3, msg4, msg5]
Process msg1 → success
Process msg2 → success
Process msg3 → FAILURE
</code></pre></div></div>

<p>What happens:</p>

<ol>
  <li>Commit offsets for msg1, msg2</li>
  <li>Retry attempt 1: [msg3, msg4, msg5] → still fails on msg3</li>
  <li>Retry attempt 2: [msg3, msg4, msg5] → still fails on msg3</li>
  <li>Retry attempt 3: [msg3, msg4, msg5] → still fails on msg3</li>
  <li>Send msg3 to DLT, commit offset for msg3</li>
  <li>Continue with [msg4, msg5]</li>
</ol>

<h3 id="44-batch-processing-with-thread-pools">4.4. Batch Processing with Thread Pools</h3>

<p>Processing batch messages asynchronously with a thread pool is a common pattern for maximizing throughput. However, it requires careful error handling to ensure no message loss.</p>

<h4 id="441-the-challenge">4.4.1. The Challenge</h4>

<p>When you submit batch records to a thread pool, the <code class="language-plaintext highlighter-rouge">@KafkaListener</code> method returns immediately. If you’re not careful, offsets get committed before async processing completes → messages can be lost if processing fails.</p>

<p><strong>Basic setup (naive approach):</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Configuration</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">BatchAsyncConfig</span> <span class="o">{</span>
    
    <span class="nd">@Bean</span>
    <span class="kd">public</span> <span class="nc">ExecutorService</span> <span class="nf">kafkaProcessorPool</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="k">new</span> <span class="nf">ThreadPoolExecutor</span><span class="o">(</span>
            <span class="mi">10</span><span class="o">,</span>  <span class="c1">// core threads</span>
            <span class="mi">50</span><span class="o">,</span>  <span class="c1">// max threads</span>
            <span class="mi">60L</span><span class="o">,</span> <span class="nc">TimeUnit</span><span class="o">.</span><span class="na">SECONDS</span><span class="o">,</span>
            <span class="k">new</span> <span class="nc">LinkedBlockingQueue</span><span class="o">&lt;&gt;(</span><span class="mi">1000</span><span class="o">)</span>
        <span class="o">);</span>
    <span class="o">}</span>
    
    <span class="nd">@Bean</span>
    <span class="kd">public</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">batchFactory</span><span class="o">(</span>
            <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">consumerFactory</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">factory</span> <span class="o">=</span> 
            <span class="k">new</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;&gt;();</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">setConsumerFactory</span><span class="o">(</span><span class="n">consumerFactory</span><span class="o">);</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">setBatchListener</span><span class="o">(</span><span class="kc">true</span><span class="o">);</span>
        
        <span class="c1">// CRITICAL: Use MANUAL_IMMEDIATE for async processing</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">getContainerProperties</span><span class="o">().</span><span class="na">setAckMode</span><span class="o">(</span>
            <span class="nc">ContainerProperties</span><span class="o">.</span><span class="na">AckMode</span><span class="o">.</span><span class="na">MANUAL_IMMEDIATE</span>
        <span class="o">);</span>
        
        <span class="k">return</span> <span class="n">factory</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h4 id="442-reliable-async-batch-processing">4.4.2. Reliable Async Batch Processing</h4>

<p>Use <code class="language-plaintext highlighter-rouge">CompletableFuture</code> to track all async tasks and only acknowledge after all complete successfully.</p>

<p><strong>Complete implementation:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Service</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">AsyncBatchListener</span> <span class="o">{</span>
    
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="nc">Logger</span> <span class="n">log</span> <span class="o">=</span> <span class="nc">LoggerFactory</span><span class="o">.</span><span class="na">getLogger</span><span class="o">(</span><span class="nc">AsyncBatchListener</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">ExecutorService</span> <span class="n">kafkaProcessorPool</span><span class="o">;</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">OrderProcessor</span> <span class="n">orderProcessor</span><span class="o">;</span>
    
    <span class="nd">@KafkaListener</span><span class="o">(</span>
        <span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span>
        <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchAsyncFactory"</span>
    <span class="o">)</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span>
            <span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">records</span><span class="o">,</span>
            <span class="nc">Acknowledgment</span> <span class="n">acknowledgment</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Received batch of {} records"</span><span class="o">,</span> <span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">());</span>
        
        <span class="c1">// Create a future for each record</span>
        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">CompletableFuture</span><span class="o">&lt;</span><span class="nc">Void</span><span class="o">&gt;&gt;</span> <span class="n">futures</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ArrayList</span><span class="o">&lt;&gt;();</span>
        
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">();</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="kd">final</span> <span class="kt">int</span> <span class="n">index</span> <span class="o">=</span> <span class="n">i</span><span class="o">;</span>
            <span class="kd">final</span> <span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span> <span class="o">=</span> <span class="n">records</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">);</span>
            
            <span class="nc">CompletableFuture</span><span class="o">&lt;</span><span class="nc">Void</span><span class="o">&gt;</span> <span class="n">future</span> <span class="o">=</span> <span class="nc">CompletableFuture</span><span class="o">.</span><span class="na">runAsync</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
                <span class="k">try</span> <span class="o">{</span>
                    <span class="n">orderProcessor</span><span class="o">.</span><span class="na">process</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">());</span>
                    <span class="n">log</span><span class="o">.</span><span class="na">debug</span><span class="o">(</span><span class="s">"Successfully processed record at index {}"</span><span class="o">,</span> <span class="n">index</span><span class="o">);</span>
                <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
                    <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Failed to process record at index {}"</span><span class="o">,</span> <span class="n">index</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
                    <span class="k">throw</span> <span class="k">new</span> <span class="nf">CompletionException</span><span class="o">(</span><span class="n">e</span><span class="o">);</span>
                <span class="o">}</span>
            <span class="o">},</span> <span class="n">kafkaProcessorPool</span><span class="o">);</span>
            
            <span class="n">futures</span><span class="o">.</span><span class="na">add</span><span class="o">(</span><span class="n">future</span><span class="o">);</span>
        <span class="o">}</span>
        
        <span class="c1">// Wait for all futures to complete</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="nc">CompletableFuture</span><span class="o">.</span><span class="na">allOf</span><span class="o">(</span><span class="n">futures</span><span class="o">.</span><span class="na">toArray</span><span class="o">(</span><span class="k">new</span> <span class="nc">CompletableFuture</span><span class="o">[</span><span class="mi">0</span><span class="o">]))</span>
                <span class="o">.</span><span class="na">join</span><span class="o">();</span>  <span class="c1">// Blocks until all complete</span>
            
            <span class="c1">// All succeeded → commit offset</span>
            <span class="n">acknowledgment</span><span class="o">.</span><span class="na">acknowledge</span><span class="o">();</span>
            <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Batch processed successfully, offset committed"</span><span class="o">);</span>
            
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">CompletionException</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Batch processing failed, offset NOT committed"</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
            <span class="c1">// Don't acknowledge → entire batch will be redelivered</span>
            <span class="c1">// This ensures no message loss but can cause duplicates</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Key points:</strong></p>

<ul>
  <li>Uses <code class="language-plaintext highlighter-rouge">MANUAL_IMMEDIATE</code> ack mode</li>
  <li><code class="language-plaintext highlighter-rouge">CompletableFuture.allOf()</code> waits for all tasks to complete</li>
  <li>Only calls <code class="language-plaintext highlighter-rouge">acknowledge()</code> if all tasks succeed</li>
  <li>If any task fails → batch is redelivered</li>
</ul>

<p><strong>Trade-off:</strong> This approach guarantees no message loss but means the entire batch is reprocessed if any single message fails.</p>

<h4 id="443-per-record-acknowledgment-with-async-processing">4.4.3. Per-Record Acknowledgment with Async Processing</h4>

<p>For finer-grained control, acknowledge successful records individually while handling failures separately.</p>

<p><strong>Advanced implementation:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Service</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">FinegrainedAsyncBatchListener</span> <span class="o">{</span>
    
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="nc">Logger</span> <span class="n">log</span> <span class="o">=</span> <span class="nc">LoggerFactory</span><span class="o">.</span><span class="na">getLogger</span><span class="o">(</span><span class="nc">FinegrainedAsyncBatchListener</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">ExecutorService</span> <span class="n">kafkaProcessorPool</span><span class="o">;</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">OrderProcessor</span> <span class="n">orderProcessor</span><span class="o">;</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">kafkaTemplate</span><span class="o">;</span>
    
    <span class="nd">@KafkaListener</span><span class="o">(</span>
        <span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span>
        <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchAsyncFactory"</span>
    <span class="o">)</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span>
            <span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">records</span><span class="o">,</span>
            <span class="nc">Acknowledgment</span> <span class="n">acknowledgment</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Processing batch of {} records"</span><span class="o">,</span> <span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">());</span>
        
        <span class="c1">// Track failed records</span>
        <span class="nc">ConcurrentHashMap</span><span class="o">&lt;</span><span class="nc">Integer</span><span class="o">,</span> <span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">failedRecords</span> <span class="o">=</span> 
            <span class="k">new</span> <span class="nc">ConcurrentHashMap</span><span class="o">&lt;&gt;();</span>
        
        <span class="nc">CountDownLatch</span> <span class="n">latch</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">CountDownLatch</span><span class="o">(</span><span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">());</span>
        
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">();</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="kd">final</span> <span class="kt">int</span> <span class="n">index</span> <span class="o">=</span> <span class="n">i</span><span class="o">;</span>
            <span class="kd">final</span> <span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span> <span class="o">=</span> <span class="n">records</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">);</span>
            
            <span class="n">kafkaProcessorPool</span><span class="o">.</span><span class="na">submit</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
                <span class="k">try</span> <span class="o">{</span>
                    <span class="n">orderProcessor</span><span class="o">.</span><span class="na">process</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">());</span>
                    <span class="n">log</span><span class="o">.</span><span class="na">debug</span><span class="o">(</span><span class="s">"Successfully processed record at index {}"</span><span class="o">,</span> <span class="n">index</span><span class="o">);</span>
                <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
                    <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Failed to process record at index {}: {}"</span><span class="o">,</span> 
                        <span class="n">index</span><span class="o">,</span> <span class="n">e</span><span class="o">.</span><span class="na">getMessage</span><span class="o">());</span>
                    <span class="n">failedRecords</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="n">index</span><span class="o">,</span> <span class="n">record</span><span class="o">);</span>
                <span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
                    <span class="n">latch</span><span class="o">.</span><span class="na">countDown</span><span class="o">();</span>
                <span class="o">}</span>
            <span class="o">});</span>
        <span class="o">}</span>
        
        <span class="c1">// Wait for all tasks to complete</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="k">if</span> <span class="o">(!</span><span class="n">latch</span><span class="o">.</span><span class="na">await</span><span class="o">(</span><span class="mi">60</span><span class="o">,</span> <span class="nc">TimeUnit</span><span class="o">.</span><span class="na">SECONDS</span><span class="o">))</span> <span class="o">{</span>
                <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Batch processing timed out after 60 seconds"</span><span class="o">);</span>
                <span class="c1">// Don't acknowledge → entire batch redelivered</span>
                <span class="k">return</span><span class="o">;</span>
            <span class="o">}</span>
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">InterruptedException</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="nc">Thread</span><span class="o">.</span><span class="na">currentThread</span><span class="o">().</span><span class="na">interrupt</span><span class="o">();</span>
            <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Batch processing interrupted"</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
            <span class="k">return</span><span class="o">;</span>
        <span class="o">}</span>
        
        <span class="c1">// Handle failures</span>
        <span class="k">if</span> <span class="o">(!</span><span class="n">failedRecords</span><span class="o">.</span><span class="na">isEmpty</span><span class="o">())</span> <span class="o">{</span>
            <span class="n">log</span><span class="o">.</span><span class="na">warn</span><span class="o">(</span><span class="s">"Batch had {} failures"</span><span class="o">,</span> <span class="n">failedRecords</span><span class="o">.</span><span class="na">size</span><span class="o">());</span>
            
            <span class="c1">// Send failed records to DLT</span>
            <span class="n">failedRecords</span><span class="o">.</span><span class="na">values</span><span class="o">().</span><span class="na">forEach</span><span class="o">(</span><span class="n">record</span> <span class="o">-&gt;</span> <span class="o">{</span>
                <span class="k">try</span> <span class="o">{</span>
                    <span class="n">kafkaTemplate</span><span class="o">.</span><span class="na">send</span><span class="o">(</span>
                        <span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">()</span> <span class="o">+</span> <span class="s">".DLT"</span><span class="o">,</span>
                        <span class="n">record</span><span class="o">.</span><span class="na">key</span><span class="o">(),</span>
                        <span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">()</span>
                    <span class="o">);</span>
                <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
                    <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Failed to send to DLT: {}"</span><span class="o">,</span> <span class="n">record</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
                <span class="o">}</span>
            <span class="o">});</span>
        <span class="o">}</span>
        
        <span class="c1">// Acknowledge the batch (successful records committed, failed sent to DLT)</span>
        <span class="n">acknowledgment</span><span class="o">.</span><span class="na">acknowledge</span><span class="o">();</span>
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Batch processing complete. Success: {}, Failed: {}"</span><span class="o">,</span> 
            <span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">()</span> <span class="o">-</span> <span class="n">failedRecords</span><span class="o">.</span><span class="na">size</span><span class="o">(),</span> <span class="n">failedRecords</span><span class="o">.</span><span class="na">size</span><span class="o">());</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>This approach:</strong></p>

<ul>
  <li>Processes all records concurrently</li>
  <li>Tracks failures individually</li>
  <li>Sends failed records to DLT</li>
  <li>Acknowledges the batch once all processing attempts complete</li>
</ul>

<p><strong>Trade-off:</strong> More complex but provides better throughput. Failed messages go to DLT instead of reprocessing entire batch.</p>

<h4 id="444-retry-strategy-for-async-batch-processing">4.4.4. Retry Strategy for Async Batch Processing</h4>

<p>Implement retry logic before sending to DLT to handle transient failures.</p>

<p><strong>With retry mechanism:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Service</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">RetryingAsyncBatchListener</span> <span class="o">{</span>
    
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="nc">Logger</span> <span class="n">log</span> <span class="o">=</span> <span class="nc">LoggerFactory</span><span class="o">.</span><span class="na">getLogger</span><span class="o">(</span><span class="nc">RetryingAsyncBatchListener</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">int</span> <span class="no">MAX_RETRY_ATTEMPTS</span> <span class="o">=</span> <span class="mi">3</span><span class="o">;</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">ExecutorService</span> <span class="n">kafkaProcessorPool</span><span class="o">;</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">OrderProcessor</span> <span class="n">orderProcessor</span><span class="o">;</span>
    
    <span class="nd">@Autowired</span>
    <span class="kd">private</span> <span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">kafkaTemplate</span><span class="o">;</span>
    
    <span class="nd">@KafkaListener</span><span class="o">(</span>
        <span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span>
        <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchAsyncFactory"</span>
    <span class="o">)</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span>
            <span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">records</span><span class="o">,</span>
            <span class="nc">Acknowledgment</span> <span class="n">acknowledgment</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Processing batch of {} records"</span><span class="o">,</span> <span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">());</span>
        
        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">CompletableFuture</span><span class="o">&lt;</span><span class="nc">RecordResult</span><span class="o">&gt;&gt;</span> <span class="n">futures</span> <span class="o">=</span> <span class="n">records</span><span class="o">.</span><span class="na">stream</span><span class="o">()</span>
            <span class="o">.</span><span class="na">map</span><span class="o">(</span><span class="n">record</span> <span class="o">-&gt;</span> <span class="n">processWithRetry</span><span class="o">(</span><span class="n">record</span><span class="o">))</span>
            <span class="o">.</span><span class="na">collect</span><span class="o">(</span><span class="nc">Collectors</span><span class="o">.</span><span class="na">toList</span><span class="o">());</span>
        
        <span class="c1">// Wait for all to complete</span>
        <span class="nc">CompletableFuture</span><span class="o">&lt;</span><span class="nc">Void</span><span class="o">&gt;</span> <span class="n">allOf</span> <span class="o">=</span> <span class="nc">CompletableFuture</span><span class="o">.</span><span class="na">allOf</span><span class="o">(</span>
            <span class="n">futures</span><span class="o">.</span><span class="na">toArray</span><span class="o">(</span><span class="k">new</span> <span class="nc">CompletableFuture</span><span class="o">[</span><span class="mi">0</span><span class="o">])</span>
        <span class="o">);</span>
        
        <span class="k">try</span> <span class="o">{</span>
            <span class="n">allOf</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="mi">120</span><span class="o">,</span> <span class="nc">TimeUnit</span><span class="o">.</span><span class="na">SECONDS</span><span class="o">);</span>
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Batch processing failed"</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
            <span class="c1">// Don't acknowledge → batch redelivered</span>
            <span class="k">return</span><span class="o">;</span>
        <span class="o">}</span>
        
        <span class="c1">// Process results</span>
        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">RecordResult</span><span class="o">&gt;</span> <span class="n">results</span> <span class="o">=</span> <span class="n">futures</span><span class="o">.</span><span class="na">stream</span><span class="o">()</span>
            <span class="o">.</span><span class="na">map</span><span class="o">(</span><span class="nl">CompletableFuture:</span><span class="o">:</span><span class="n">join</span><span class="o">)</span>
            <span class="o">.</span><span class="na">collect</span><span class="o">(</span><span class="nc">Collectors</span><span class="o">.</span><span class="na">toList</span><span class="o">());</span>
        
        <span class="c1">// Send failed records to DLT after retries exhausted</span>
        <span class="n">results</span><span class="o">.</span><span class="na">stream</span><span class="o">()</span>
            <span class="o">.</span><span class="na">filter</span><span class="o">(</span><span class="n">result</span> <span class="o">-&gt;</span> <span class="o">!</span><span class="n">result</span><span class="o">.</span><span class="na">isSuccess</span><span class="o">())</span>
            <span class="o">.</span><span class="na">forEach</span><span class="o">(</span><span class="n">result</span> <span class="o">-&gt;</span> <span class="n">sendToDlt</span><span class="o">(</span><span class="n">result</span><span class="o">.</span><span class="na">getRecord</span><span class="o">(),</span> <span class="n">result</span><span class="o">.</span><span class="na">getException</span><span class="o">()));</span>
        
        <span class="c1">// Acknowledge batch</span>
        <span class="n">acknowledgment</span><span class="o">.</span><span class="na">acknowledge</span><span class="o">();</span>
        
        <span class="kt">long</span> <span class="n">successCount</span> <span class="o">=</span> <span class="n">results</span><span class="o">.</span><span class="na">stream</span><span class="o">().</span><span class="na">filter</span><span class="o">(</span><span class="nl">RecordResult:</span><span class="o">:</span><span class="n">isSuccess</span><span class="o">).</span><span class="na">count</span><span class="o">();</span>
        <span class="kt">long</span> <span class="n">failureCount</span> <span class="o">=</span> <span class="n">results</span><span class="o">.</span><span class="na">size</span><span class="o">()</span> <span class="o">-</span> <span class="n">successCount</span><span class="o">;</span>
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Batch complete. Success: {}, Failed: {}"</span><span class="o">,</span> <span class="n">successCount</span><span class="o">,</span> <span class="n">failureCount</span><span class="o">);</span>
    <span class="o">}</span>
    
    <span class="kd">private</span> <span class="nc">CompletableFuture</span><span class="o">&lt;</span><span class="nc">RecordResult</span><span class="o">&gt;</span> <span class="nf">processWithRetry</span><span class="o">(</span>
            <span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="k">return</span> <span class="nc">CompletableFuture</span><span class="o">.</span><span class="na">supplyAsync</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
            <span class="nc">Exception</span> <span class="n">lastException</span> <span class="o">=</span> <span class="kc">null</span><span class="o">;</span>
            
            <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">attempt</span> <span class="o">=</span> <span class="mi">1</span><span class="o">;</span> <span class="n">attempt</span> <span class="o">&lt;=</span> <span class="no">MAX_RETRY_ATTEMPTS</span><span class="o">;</span> <span class="n">attempt</span><span class="o">++)</span> <span class="o">{</span>
                <span class="k">try</span> <span class="o">{</span>
                    <span class="n">orderProcessor</span><span class="o">.</span><span class="na">process</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">());</span>
                    <span class="k">return</span> <span class="k">new</span> <span class="nf">RecordResult</span><span class="o">(</span><span class="n">record</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="kc">null</span><span class="o">);</span>
                <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
                    <span class="n">lastException</span> <span class="o">=</span> <span class="n">e</span><span class="o">;</span>
                    <span class="n">log</span><span class="o">.</span><span class="na">warn</span><span class="o">(</span><span class="s">"Attempt {}/{} failed for record offset {}: {}"</span><span class="o">,</span> 
                        <span class="n">attempt</span><span class="o">,</span> <span class="no">MAX_RETRY_ATTEMPTS</span><span class="o">,</span> <span class="n">record</span><span class="o">.</span><span class="na">offset</span><span class="o">(),</span> <span class="n">e</span><span class="o">.</span><span class="na">getMessage</span><span class="o">());</span>
                    
                    <span class="k">if</span> <span class="o">(</span><span class="n">attempt</span> <span class="o">&lt;</span> <span class="no">MAX_RETRY_ATTEMPTS</span><span class="o">)</span> <span class="o">{</span>
                        <span class="c1">// Exponential backoff</span>
                        <span class="k">try</span> <span class="o">{</span>
                            <span class="nc">Thread</span><span class="o">.</span><span class="na">sleep</span><span class="o">((</span><span class="kt">long</span><span class="o">)</span> <span class="nc">Math</span><span class="o">.</span><span class="na">pow</span><span class="o">(</span><span class="mi">2</span><span class="o">,</span> <span class="n">attempt</span><span class="o">)</span> <span class="o">*</span> <span class="mi">1000</span><span class="o">);</span>
                        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">InterruptedException</span> <span class="n">ie</span><span class="o">)</span> <span class="o">{</span>
                            <span class="nc">Thread</span><span class="o">.</span><span class="na">currentThread</span><span class="o">().</span><span class="na">interrupt</span><span class="o">();</span>
                            <span class="k">return</span> <span class="k">new</span> <span class="nf">RecordResult</span><span class="o">(</span><span class="n">record</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="n">ie</span><span class="o">);</span>
                        <span class="o">}</span>
                    <span class="o">}</span>
                <span class="o">}</span>
            <span class="o">}</span>
            
            <span class="c1">// All retries exhausted</span>
            <span class="k">return</span> <span class="k">new</span> <span class="nf">RecordResult</span><span class="o">(</span><span class="n">record</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="n">lastException</span><span class="o">);</span>
            
        <span class="o">},</span> <span class="n">kafkaProcessorPool</span><span class="o">);</span>
    <span class="o">}</span>
    
    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">sendToDlt</span><span class="o">(</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span><span class="o">,</span> <span class="nc">Exception</span> <span class="n">exception</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="nc">ProducerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">dltRecord</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ProducerRecord</span><span class="o">&lt;&gt;(</span>
                <span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">()</span> <span class="o">+</span> <span class="s">".DLT"</span><span class="o">,</span>
                <span class="n">record</span><span class="o">.</span><span class="na">partition</span><span class="o">(),</span>
                <span class="n">record</span><span class="o">.</span><span class="na">key</span><span class="o">(),</span>
                <span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">()</span>
            <span class="o">);</span>
            
            <span class="c1">// Add error headers</span>
            <span class="n">dltRecord</span><span class="o">.</span><span class="na">headers</span><span class="o">().</span><span class="na">add</span><span class="o">(</span><span class="s">"original-topic"</span><span class="o">,</span> <span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">().</span><span class="na">getBytes</span><span class="o">());</span>
            <span class="n">dltRecord</span><span class="o">.</span><span class="na">headers</span><span class="o">().</span><span class="na">add</span><span class="o">(</span><span class="s">"original-offset"</span><span class="o">,</span> 
                <span class="nc">String</span><span class="o">.</span><span class="na">valueOf</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">offset</span><span class="o">()).</span><span class="na">getBytes</span><span class="o">());</span>
            <span class="n">dltRecord</span><span class="o">.</span><span class="na">headers</span><span class="o">().</span><span class="na">add</span><span class="o">(</span><span class="s">"error-message"</span><span class="o">,</span> 
                <span class="n">exception</span><span class="o">.</span><span class="na">getMessage</span><span class="o">().</span><span class="na">getBytes</span><span class="o">());</span>
            <span class="n">dltRecord</span><span class="o">.</span><span class="na">headers</span><span class="o">().</span><span class="na">add</span><span class="o">(</span><span class="s">"error-class"</span><span class="o">,</span> 
                <span class="n">exception</span><span class="o">.</span><span class="na">getClass</span><span class="o">().</span><span class="na">getName</span><span class="o">().</span><span class="na">getBytes</span><span class="o">());</span>
            
            <span class="n">kafkaTemplate</span><span class="o">.</span><span class="na">send</span><span class="o">(</span><span class="n">dltRecord</span><span class="o">);</span>
            <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Sent to DLT: offset={}"</span><span class="o">,</span> <span class="n">record</span><span class="o">.</span><span class="na">offset</span><span class="o">());</span>
            
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Failed to send to DLT"</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
        <span class="o">}</span>
    <span class="o">}</span>
    
    <span class="nd">@Data</span>
    <span class="nd">@AllArgsConstructor</span>
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">class</span> <span class="nc">RecordResult</span> <span class="o">{</span>
        <span class="kd">private</span> <span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span><span class="o">;</span>
        <span class="kd">private</span> <span class="kt">boolean</span> <span class="n">success</span><span class="o">;</span>
        <span class="kd">private</span> <span class="nc">Exception</span> <span class="n">exception</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>This implementation:</strong></p>

<ul>
  <li>Retries each record up to 3 times with exponential backoff</li>
  <li>Processes all records concurrently in thread pool</li>
  <li>Only sends to DLT after all retries exhausted</li>
  <li>Acknowledges batch after all processing complete</li>
</ul>

<h4 id="445-trade-offs-analysis">4.4.5. Trade-offs Analysis</h4>

<p><strong>Approach 1: All-or-Nothing (Section 4.4.2)</strong></p>

<p>✅ <strong>Pros:</strong></p>
<ul>
  <li>Simple to implement</li>
  <li>No message loss guaranteed</li>
  <li>Maintains batch ordering</li>
</ul>

<p>❌ <strong>Cons:</strong></p>
<ul>
  <li>One failure reprocesses entire batch</li>
  <li>Lower throughput with frequent failures</li>
  <li>Can cause duplicate processing of successful messages</li>
</ul>

<p><strong>Best for:</strong> Low failure rates, strict ordering requirements</p>

<hr />

<p><strong>Approach 2: Finegrained with DLT (Section 4.4.3)</strong></p>

<p>✅ <strong>Pros:</strong></p>
<ul>
  <li>Higher throughput (no reprocessing successful messages)</li>
  <li>Failed messages isolated to DLT</li>
  <li>Better resource utilization</li>
</ul>

<p>❌ <strong>Cons:</strong></p>
<ul>
  <li>More complex code</li>
  <li>Potential ordering issues if replaying from DLT</li>
  <li>Need to monitor and replay DLT messages</li>
</ul>

<p><strong>Best for:</strong> High throughput requirements, acceptable to lose ordering for failed messages</p>

<hr />

<p><strong>Approach 3: Retry with DLT (Section 4.4.4)</strong></p>

<p>✅ <strong>Pros:</strong></p>
<ul>
  <li>Handles transient failures automatically</li>
  <li>Best throughput/reliability balance</li>
  <li>Reduces DLT volume</li>
</ul>

<p>❌ <strong>Cons:</strong></p>
<ul>
  <li>Most complex implementation</li>
  <li>Increased processing latency during retries</li>
  <li>Thread pool can get saturated during failures</li>
</ul>

<p><strong>Best for:</strong> Production systems with transient failures (database timeouts, rate limits)</p>

<hr />

<p><strong>Throughput Comparison:</strong></p>

<table>
  <thead>
    <tr>
      <th>Approach</th>
      <th>Throughput</th>
      <th>Latency</th>
      <th>Complexity</th>
      <th>Data Loss Risk</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Sync Batch (no thread pool)</td>
      <td>Low</td>
      <td>Low</td>
      <td>Low</td>
      <td>None</td>
    </tr>
    <tr>
      <td>All-or-Nothing Async</td>
      <td>Medium-High</td>
      <td>Medium</td>
      <td>Medium</td>
      <td>None</td>
    </tr>
    <tr>
      <td>Finegrained Async</td>
      <td>High</td>
      <td>Low</td>
      <td>High</td>
      <td>None (with proper DLT)</td>
    </tr>
    <tr>
      <td>Retry + Async</td>
      <td>High</td>
      <td>Medium</td>
      <td>High</td>
      <td>None</td>
    </tr>
  </tbody>
</table>

<p><strong>Configuration recommendations:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># For high throughput with async processing</span>
<span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">consumer</span><span class="pi">:</span>
      <span class="na">max-poll-records</span><span class="pi">:</span> <span class="m">500</span>  <span class="c1"># Larger batches</span>
      <span class="na">fetch-min-size</span><span class="pi">:</span> <span class="m">1024</span>   <span class="c1"># Wait for more data</span>
      <span class="na">fetch-max-wait</span><span class="pi">:</span> <span class="m">500</span>    <span class="c1"># But don't wait too long</span>
    <span class="na">listener</span><span class="pi">:</span>
      <span class="na">ack-mode</span><span class="pi">:</span> <span class="s">manual_immediate</span>
      <span class="na">concurrency</span><span class="pi">:</span> <span class="m">3</span>  <span class="c1"># Multiple container threads</span>

<span class="c1"># Thread pool sizing</span>
<span class="na">kafka</span><span class="pi">:</span>
  <span class="na">processor</span><span class="pi">:</span>
    <span class="na">core-threads</span><span class="pi">:</span> <span class="m">20</span>
    <span class="na">max-threads</span><span class="pi">:</span> <span class="m">100</span>
    <span class="na">queue-capacity</span><span class="pi">:</span> <span class="m">2000</span>
</code></pre></div></div>

<p><strong>Thread pool sizing guidelines:</strong></p>

<ul>
  <li><strong>Core threads:</strong> 2-3x number of Kafka consumer threads</li>
  <li><strong>Max threads:</strong> Based on downstream service capacity</li>
  <li><strong>Queue capacity:</strong> <code class="language-plaintext highlighter-rouge">max-poll-records</code> × <code class="language-plaintext highlighter-rouge">concurrency</code> × 2</li>
</ul>

<p>Example: If <code class="language-plaintext highlighter-rouge">max-poll-records=500</code>, <code class="language-plaintext highlighter-rouge">concurrency=3</code>, queue should be ~3000.</p>

<h4 id="446-monitoring-and-observability">4.4.6. Monitoring and Observability</h4>

<p>When using async batch processing, add metrics to track:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Service</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">MonitoredAsyncBatchListener</span> <span class="o">{</span>
    
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">MeterRegistry</span> <span class="n">meterRegistry</span><span class="o">;</span>
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">Counter</span> <span class="n">processedCounter</span><span class="o">;</span>
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">Counter</span> <span class="n">failedCounter</span><span class="o">;</span>
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">Timer</span> <span class="n">processingTimer</span><span class="o">;</span>
    
    <span class="kd">public</span> <span class="nf">MonitoredAsyncBatchListener</span><span class="o">(</span><span class="nc">MeterRegistry</span> <span class="n">meterRegistry</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">meterRegistry</span> <span class="o">=</span> <span class="n">meterRegistry</span><span class="o">;</span>
        <span class="k">this</span><span class="o">.</span><span class="na">processedCounter</span> <span class="o">=</span> <span class="nc">Counter</span><span class="o">.</span><span class="na">builder</span><span class="o">(</span><span class="s">"kafka.messages.processed"</span><span class="o">)</span>
            <span class="o">.</span><span class="na">tag</span><span class="o">(</span><span class="s">"type"</span><span class="o">,</span> <span class="s">"batch-async"</span><span class="o">)</span>
            <span class="o">.</span><span class="na">register</span><span class="o">(</span><span class="n">meterRegistry</span><span class="o">);</span>
        <span class="k">this</span><span class="o">.</span><span class="na">failedCounter</span> <span class="o">=</span> <span class="nc">Counter</span><span class="o">.</span><span class="na">builder</span><span class="o">(</span><span class="s">"kafka.messages.failed"</span><span class="o">)</span>
            <span class="o">.</span><span class="na">tag</span><span class="o">(</span><span class="s">"type"</span><span class="o">,</span> <span class="s">"batch-async"</span><span class="o">)</span>
            <span class="o">.</span><span class="na">register</span><span class="o">(</span><span class="n">meterRegistry</span><span class="o">);</span>
        <span class="k">this</span><span class="o">.</span><span class="na">processingTimer</span> <span class="o">=</span> <span class="nc">Timer</span><span class="o">.</span><span class="na">builder</span><span class="o">(</span><span class="s">"kafka.batch.processing.time"</span><span class="o">)</span>
            <span class="o">.</span><span class="na">register</span><span class="o">(</span><span class="n">meterRegistry</span><span class="o">);</span>
    <span class="o">}</span>
    
    <span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span> <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchAsyncFactory"</span><span class="o">)</span>
    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span>
            <span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">records</span><span class="o">,</span>
            <span class="nc">Acknowledgment</span> <span class="n">acknowledgment</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="n">processingTimer</span><span class="o">.</span><span class="na">record</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
            <span class="c1">// Your processing logic here</span>
            <span class="n">processBatchInternal</span><span class="o">(</span><span class="n">records</span><span class="o">,</span> <span class="n">acknowledgment</span><span class="o">);</span>
        <span class="o">});</span>
    <span class="o">}</span>
    
    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">processBatchInternal</span><span class="o">(</span>
            <span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">records</span><span class="o">,</span>
            <span class="nc">Acknowledgment</span> <span class="n">acknowledgment</span><span class="o">)</span> <span class="o">{</span>
        <span class="c1">// Track batch size</span>
        <span class="n">meterRegistry</span><span class="o">.</span><span class="na">gauge</span><span class="o">(</span><span class="s">"kafka.batch.size"</span><span class="o">,</span> <span class="n">records</span><span class="o">.</span><span class="na">size</span><span class="o">());</span>
        
        <span class="c1">// Process batch...</span>
        <span class="c1">// Update counters based on results</span>
        <span class="n">processedCounter</span><span class="o">.</span><span class="na">increment</span><span class="o">(</span><span class="n">successCount</span><span class="o">);</span>
        <span class="n">failedCounter</span><span class="o">.</span><span class="na">increment</span><span class="o">(</span><span class="n">failureCount</span><span class="o">);</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Key metrics to monitor:</strong></p>

<ul>
  <li>Batch processing time</li>
  <li>Success/failure rates</li>
  <li>Thread pool utilization</li>
  <li>DLT message count</li>
  <li>Consumer lag</li>
</ul>

<h2 id="5-deserialization-error-handling">5. Deserialization Error Handling</h2>

<h3 id="51-using-errorhandlingdeserializer">5.1. Using ErrorHandlingDeserializer</h3>

<p>Deserialization errors are tricky because they happen before your <code class="language-plaintext highlighter-rouge">@KafkaListener</code> method is invoked. Without special handling, a single bad message stops the entire consumer.</p>

<p><strong>Solution:</strong> Wrap your deserializer with <code class="language-plaintext highlighter-rouge">ErrorHandlingDeserializer</code>.</p>

<p><strong>Configuration:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Bean</span>
<span class="kd">public</span> <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">consumerFactory</span><span class="o">()</span> <span class="o">{</span>
    <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Object</span><span class="o">&gt;</span> <span class="n">props</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">HashMap</span><span class="o">&lt;&gt;();</span>
    <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">BOOTSTRAP_SERVERS_CONFIG</span><span class="o">,</span> <span class="s">"localhost:9092"</span><span class="o">);</span>
    <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">KEY_DESERIALIZER_CLASS_CONFIG</span><span class="o">,</span> <span class="nc">StringDeserializer</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
    
    <span class="c1">// Wrap the actual deserializer</span>
    <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">VALUE_DESERIALIZER_CLASS_CONFIG</span><span class="o">,</span> <span class="nc">ErrorHandlingDeserializer</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
    <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ErrorHandlingDeserializer</span><span class="o">.</span><span class="na">VALUE_DESERIALIZER_CLASS</span><span class="o">,</span> <span class="nc">JsonDeserializer</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
    <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">JsonDeserializer</span><span class="o">.</span><span class="na">TRUSTED_PACKAGES</span><span class="o">,</span> <span class="s">"*"</span><span class="o">);</span>
    
    <span class="k">return</span> <span class="k">new</span> <span class="nc">DefaultKafkaConsumerFactory</span><span class="o">&lt;&gt;(</span><span class="n">props</span><span class="o">);</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Or with properties:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">consumer</span><span class="pi">:</span>
      <span class="na">key-deserializer</span><span class="pi">:</span> <span class="s">org.apache.kafka.common.serialization.StringDeserializer</span>
      <span class="na">value-deserializer</span><span class="pi">:</span> <span class="s">org.springframework.kafka.support.serializer.ErrorHandlingDeserializer</span>
      <span class="na">properties</span><span class="pi">:</span>
        <span class="na">spring.deserializer.value.delegate.class</span><span class="pi">:</span> <span class="s">org.springframework.kafka.support.serializer.JsonDeserializer</span>
        <span class="na">spring.json.trusted.packages</span><span class="pi">:</span> <span class="s2">"</span><span class="s">*"</span>
</code></pre></div></div>

<h3 id="52-handling-deserialization-failures">5.2. Handling Deserialization Failures</h3>

<p>With <code class="language-plaintext highlighter-rouge">ErrorHandlingDeserializer</code>, failed records arrive with <code class="language-plaintext highlighter-rouge">null</code> value and exception details in headers.</p>

<p><strong>Record listener:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">listen</span><span class="o">(</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">if</span> <span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">()</span> <span class="o">==</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span>
        <span class="c1">// Deserialization failed</span>
        <span class="k">throw</span> <span class="k">new</span> <span class="nf">DeserializationException</span><span class="o">(</span><span class="s">"Cannot deserialize"</span><span class="o">,</span> <span class="kc">null</span><span class="o">,</span> <span class="kc">null</span><span class="o">);</span>
    <span class="o">}</span>
    
    <span class="n">processOrder</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">());</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Batch listener:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span> <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchFactory"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">listenBatch</span><span class="o">(</span><span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;&gt;</span> <span class="n">records</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">for</span> <span class="o">(</span><span class="nc">ConsumerRecord</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">record</span> <span class="o">:</span> <span class="n">records</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">()</span> <span class="o">==</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span>
            <span class="c1">// Deserialization failed → send to DLT</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">BatchListenerFailedException</span><span class="o">(</span>
                <span class="s">"Deserialization failed"</span><span class="o">,</span> 
                <span class="n">record</span>
            <span class="o">);</span>
        <span class="o">}</span>
        <span class="n">processOrder</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">value</span><span class="o">());</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Important:</strong> For batch listeners, you must manually check for <code class="language-plaintext highlighter-rouge">null</code> values. There’s no automatic detection like with record listeners.</p>

<h3 id="53-conversion-errors">5.3. Conversion Errors</h3>

<p>Starting with version 2.8, batch listeners can handle conversion errors when using a <code class="language-plaintext highlighter-rouge">MessageConverter</code>.</p>

<p><strong>Example:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">listen</span><span class="o">(</span>
        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Order</span><span class="o">&gt;</span> <span class="n">orders</span><span class="o">,</span>
        <span class="nd">@Header</span><span class="o">(</span><span class="nc">KafkaHeaders</span><span class="o">.</span><span class="na">CONVERSION_FAILURES</span><span class="o">)</span> <span class="nc">List</span><span class="o">&lt;</span><span class="nc">ConversionException</span><span class="o">&gt;</span> <span class="n">exceptions</span><span class="o">)</span> <span class="o">{</span>
    
    <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">orders</span><span class="o">.</span><span class="na">size</span><span class="o">();</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">orders</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">)</span> <span class="o">==</span> <span class="kc">null</span> <span class="o">&amp;&amp;</span> <span class="n">exceptions</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">)</span> <span class="o">!=</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">BatchListenerFailedException</span><span class="o">(</span>
                <span class="s">"Conversion error"</span><span class="o">,</span> 
                <span class="n">exceptions</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">),</span> 
                <span class="n">i</span>
            <span class="o">);</span>
        <span class="o">}</span>
        <span class="n">processOrder</span><span class="o">(</span><span class="n">orders</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">));</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h2 id="6-backoff-strategies">6. Backoff Strategies</h2>

<h3 id="61-fixed-backoff">6.1. Fixed Backoff</h3>

<p>Retries at fixed intervals.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// 3 retries with 1 second between each</span>
<span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">1000L</span><span class="o">,</span> <span class="mi">2L</span><span class="o">)</span>
</code></pre></div></div>

<h3 id="62-exponential-backoff">6.2. Exponential Backoff</h3>

<p>Retries with exponentially increasing delays.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Bean</span>
<span class="kd">public</span> <span class="nc">DefaultErrorHandler</span> <span class="nf">errorHandler</span><span class="o">(</span><span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">template</span><span class="o">)</span> <span class="o">{</span>
    <span class="nc">ExponentialBackOffWithMaxRetries</span> <span class="n">backOff</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ExponentialBackOffWithMaxRetries</span><span class="o">(</span><span class="mi">6</span><span class="o">);</span>
    <span class="n">backOff</span><span class="o">.</span><span class="na">setInitialInterval</span><span class="o">(</span><span class="mi">1000L</span><span class="o">);</span>    <span class="c1">// Start with 1 second</span>
    <span class="n">backOff</span><span class="o">.</span><span class="na">setMultiplier</span><span class="o">(</span><span class="mf">2.0</span><span class="o">);</span>           <span class="c1">// Double each time</span>
    <span class="n">backOff</span><span class="o">.</span><span class="na">setMaxInterval</span><span class="o">(</span><span class="mi">10000L</span><span class="o">);</span>       <span class="c1">// Cap at 10 seconds</span>
    
    <span class="c1">// Retry after: 1s, 2s, 4s, 8s, 10s, 10s</span>
    
    <span class="nc">DeadLetterPublishingRecoverer</span> <span class="n">recoverer</span> <span class="o">=</span> 
        <span class="k">new</span> <span class="nf">DeadLetterPublishingRecoverer</span><span class="o">(</span><span class="n">template</span><span class="o">);</span>
    
    <span class="k">return</span> <span class="k">new</span> <span class="nf">DefaultErrorHandler</span><span class="o">(</span><span class="n">recoverer</span><span class="o">,</span> <span class="n">backOff</span><span class="o">);</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="63-custom-backoff-based-on-exception">6.3. Custom Backoff Based on Exception</h3>

<p>Different backoff strategies for different errors:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">DefaultErrorHandler</span> <span class="n">handler</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DefaultErrorHandler</span><span class="o">(</span><span class="n">recoverer</span><span class="o">,</span> <span class="n">defaultBackOff</span><span class="o">);</span>

<span class="n">handler</span><span class="o">.</span><span class="na">setBackOffFunction</span><span class="o">((</span><span class="n">record</span><span class="o">,</span> <span class="n">exception</span><span class="o">)</span> <span class="o">-&gt;</span> <span class="o">{</span>
    <span class="k">if</span> <span class="o">(</span><span class="n">exception</span><span class="o">.</span><span class="na">getCause</span><span class="o">()</span> <span class="k">instanceof</span> <span class="nc">TransientException</span><span class="o">)</span> <span class="o">{</span>
        <span class="c1">// Retry quickly for transient errors</span>
        <span class="k">return</span> <span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">500L</span><span class="o">,</span> <span class="mi">5L</span><span class="o">);</span>
    <span class="o">}</span> <span class="k">else</span> <span class="k">if</span> <span class="o">(</span><span class="n">exception</span><span class="o">.</span><span class="na">getCause</span><span class="o">()</span> <span class="k">instanceof</span> <span class="nc">RateLimitException</span><span class="o">)</span> <span class="o">{</span>
        <span class="c1">// Wait longer for rate limit errors</span>
        <span class="k">return</span> <span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">5000L</span><span class="o">,</span> <span class="mi">3L</span><span class="o">);</span>
    <span class="o">}</span>
    <span class="c1">// Use default backoff for other cases</span>
    <span class="k">return</span> <span class="kc">null</span><span class="o">;</span>
<span class="o">});</span>
</code></pre></div></div>

<h2 id="7-common-pitfalls-and-best-practices">7. Common Pitfalls and Best Practices</h2>

<h3 id="71-losing-messages-with-async-processing">7.1. Losing Messages with Async Processing</h3>

<p><strong>Problem:</strong> When processing messages asynchronously with a custom thread pool, the <code class="language-plaintext highlighter-rouge">@KafkaListener</code> method returns immediately. If using <code class="language-plaintext highlighter-rouge">BATCH</code> or <code class="language-plaintext highlighter-rouge">RECORD</code> ack mode, the offset is committed before async processing completes.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// DON'T DO THIS</span>
<span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">listen</span><span class="o">(</span><span class="nc">Order</span> <span class="n">order</span><span class="o">)</span> <span class="o">{</span>
    <span class="n">executorService</span><span class="o">.</span><span class="na">submit</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
        <span class="c1">// Process asynchronously</span>
        <span class="n">processOrder</span><span class="o">(</span><span class="n">order</span><span class="o">);</span>  <span class="c1">// If this fails, message is lost</span>
    <span class="o">});</span>
    <span class="c1">// Method returns → offset committed before processing!</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Solution:</strong> Use <code class="language-plaintext highlighter-rouge">MANUAL_IMMEDIATE</code> ack mode:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span>
    <span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span>
    <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"manualFactory"</span>
<span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">listen</span><span class="o">(</span><span class="nc">Order</span> <span class="n">order</span><span class="o">,</span> <span class="nc">Acknowledgment</span> <span class="n">ack</span><span class="o">)</span> <span class="o">{</span>
    <span class="n">executorService</span><span class="o">.</span><span class="na">submit</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="n">processOrder</span><span class="o">(</span><span class="n">order</span><span class="o">);</span>
            <span class="n">ack</span><span class="o">.</span><span class="na">acknowledge</span><span class="o">();</span>  <span class="c1">// Commit only after success</span>
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">log</span><span class="o">.</span><span class="na">error</span><span class="o">(</span><span class="s">"Failed"</span><span class="o">,</span> <span class="n">e</span><span class="o">);</span>
            <span class="c1">// Don't acknowledge → message will be redelivered</span>
        <span class="o">}</span>
    <span class="o">});</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="72-message-duplicates-after-restart">7.2. Message Duplicates After Restart</h3>

<p><strong>Problem:</strong> Consumer crashes after processing but before committing offset → message gets reprocessed.</p>

<p>This is normal with at-least-once delivery. Your processing logic should be <strong>idempotent</strong>.</p>

<p><strong>Solution — Idempotent processing:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">listen</span><span class="o">(</span><span class="nc">Order</span> <span class="n">order</span><span class="o">)</span> <span class="o">{</span>
    <span class="c1">// Use database constraints or unique checks</span>
    <span class="k">try</span> <span class="o">{</span>
        <span class="n">orderRepository</span><span class="o">.</span><span class="na">insertIfNotExists</span><span class="o">(</span><span class="n">order</span><span class="o">);</span>
    <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">DuplicateKeyException</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Order {} already processed, skipping"</span><span class="o">,</span> <span class="n">order</span><span class="o">.</span><span class="na">getId</span><span class="o">());</span>
        <span class="c1">// Don't throw exception → acknowledge and move on</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>Or track processed message IDs in a separate table:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Transactional</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">processOrder</span><span class="o">(</span><span class="nc">Order</span> <span class="n">order</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">if</span> <span class="o">(</span><span class="n">processedMessageRepository</span><span class="o">.</span><span class="na">exists</span><span class="o">(</span><span class="n">order</span><span class="o">.</span><span class="na">getMessageId</span><span class="o">()))</span> <span class="o">{</span>
        <span class="n">log</span><span class="o">.</span><span class="na">info</span><span class="o">(</span><span class="s">"Already processed message {}"</span><span class="o">,</span> <span class="n">order</span><span class="o">.</span><span class="na">getMessageId</span><span class="o">());</span>
        <span class="k">return</span><span class="o">;</span>
    <span class="o">}</span>
    
    <span class="c1">// Process the order</span>
    <span class="n">orderService</span><span class="o">.</span><span class="na">createOrder</span><span class="o">(</span><span class="n">order</span><span class="o">);</span>
    
    <span class="c1">// Mark as processed</span>
    <span class="n">processedMessageRepository</span><span class="o">.</span><span class="na">save</span><span class="o">(</span><span class="k">new</span> <span class="nc">ProcessedMessage</span><span class="o">(</span><span class="n">order</span><span class="o">.</span><span class="na">getMessageId</span><span class="o">()));</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="73-forgetting-to-configure-dlt-topics">7.3. Forgetting to Configure DLT Topics</h3>

<p><strong>Problem:</strong> DefaultErrorHandler tries to send to DLT, but topic doesn’t exist → error on error.</p>

<p><strong>Solution:</strong> Create DLT topics ahead of time with appropriate partition count:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># Original topic has 10 partitions</span>
kafka-topics.sh <span class="nt">--create</span> <span class="se">\</span>
  <span class="nt">--topic</span> orders.DLT <span class="se">\</span>
  <span class="nt">--partitions</span> 10 <span class="se">\</span>
  <span class="nt">--replication-factor</span> 3
</code></pre></div></div>

<p>Or configure to create dynamically:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Bean</span>
<span class="kd">public</span> <span class="nc">NewTopic</span> <span class="nf">ordersDlt</span><span class="o">()</span> <span class="o">{</span>
    <span class="k">return</span> <span class="nc">TopicBuilder</span>
        <span class="o">.</span><span class="na">name</span><span class="o">(</span><span class="s">"orders.DLT"</span><span class="o">)</span>
        <span class="o">.</span><span class="na">partitions</span><span class="o">(</span><span class="mi">10</span><span class="o">)</span>
        <span class="o">.</span><span class="na">replicas</span><span class="o">(</span><span class="mi">3</span><span class="o">)</span>
        <span class="o">.</span><span class="na">build</span><span class="o">();</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="74-not-setting-immediate-stop-for-long-processing">7.4. Not Setting Immediate Stop for Long Processing</h3>

<p><strong>Problem:</strong> Graceful shutdown waits for entire batch to complete. If each message takes 30 seconds, shutdown can take minutes.</p>

<p><strong>Solution:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">listener</span><span class="pi">:</span>
      <span class="na">ack-mode</span><span class="pi">:</span> <span class="s">RECORD</span>
      <span class="na">immediate-stop</span><span class="pi">:</span> <span class="no">true</span>  <span class="c1"># Stop after current record</span>
</code></pre></div></div>

<h3 id="75-batch-listener-without-batchlistenerfailedexception">7.5. Batch Listener without BatchListenerFailedException</h3>

<p><strong>Problem:</strong> Throwing generic exception from batch listener retries the entire batch, can’t identify which record failed.</p>

<p><strong>Bad:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span> <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchFactory"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span><span class="nc">List</span><span class="o">&lt;</span><span class="nc">Order</span><span class="o">&gt;</span> <span class="n">orders</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">for</span> <span class="o">(</span><span class="nc">Order</span> <span class="n">order</span> <span class="o">:</span> <span class="n">orders</span><span class="o">)</span> <span class="o">{</span>
        <span class="n">processOrder</span><span class="o">(</span><span class="n">order</span><span class="o">);</span>  <span class="c1">// Exception loses context</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>Good:</strong></p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@KafkaListener</span><span class="o">(</span><span class="n">topics</span> <span class="o">=</span> <span class="s">"orders"</span><span class="o">,</span> <span class="n">containerFactory</span> <span class="o">=</span> <span class="s">"batchFactory"</span><span class="o">)</span>
<span class="kd">public</span> <span class="kt">void</span> <span class="nf">processBatch</span><span class="o">(</span><span class="nc">List</span><span class="o">&lt;</span><span class="nc">Order</span><span class="o">&gt;</span> <span class="n">orders</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">orders</span><span class="o">.</span><span class="na">size</span><span class="o">();</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="n">processOrder</span><span class="o">(</span><span class="n">orders</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">i</span><span class="o">));</span>
        <span class="o">}</span> <span class="k">catch</span> <span class="o">(</span><span class="nc">Exception</span> <span class="n">e</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">BatchListenerFailedException</span><span class="o">(</span><span class="s">"Failed"</span><span class="o">,</span> <span class="n">e</span><span class="o">,</span> <span class="n">i</span><span class="o">);</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h2 id="8-production-configuration-example">8. Production Configuration Example</h2>

<p>Here’s a solid production-ready configuration combining everything:</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nd">@Configuration</span>
<span class="kd">public</span> <span class="kd">class</span> <span class="nc">KafkaErrorHandlingConfig</span> <span class="o">{</span>
    
    <span class="nd">@Bean</span>
    <span class="kd">public</span> <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">consumerFactory</span><span class="o">()</span> <span class="o">{</span>
        <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Object</span><span class="o">&gt;</span> <span class="n">props</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">HashMap</span><span class="o">&lt;&gt;();</span>
        <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">BOOTSTRAP_SERVERS_CONFIG</span><span class="o">,</span> <span class="s">"localhost:9092"</span><span class="o">);</span>
        <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">GROUP_ID_CONFIG</span><span class="o">,</span> <span class="s">"order-service"</span><span class="o">);</span>
        <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">KEY_DESERIALIZER_CLASS_CONFIG</span><span class="o">,</span> <span class="nc">StringDeserializer</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
        
        <span class="c1">// Wrap deserializer for error handling</span>
        <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">VALUE_DESERIALIZER_CLASS_CONFIG</span><span class="o">,</span> <span class="nc">ErrorHandlingDeserializer</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
        <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ErrorHandlingDeserializer</span><span class="o">.</span><span class="na">VALUE_DESERIALIZER_CLASS</span><span class="o">,</span> <span class="nc">JsonDeserializer</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
        <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">JsonDeserializer</span><span class="o">.</span><span class="na">TRUSTED_PACKAGES</span><span class="o">,</span> <span class="s">"com.example.model"</span><span class="o">);</span>
        
        <span class="c1">// Disable auto-commit (Spring Kafka manages it)</span>
        <span class="n">props</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="nc">ConsumerConfig</span><span class="o">.</span><span class="na">ENABLE_AUTO_COMMIT_CONFIG</span><span class="o">,</span> <span class="kc">false</span><span class="o">);</span>
        
        <span class="k">return</span> <span class="k">new</span> <span class="nc">DefaultKafkaConsumerFactory</span><span class="o">&lt;&gt;(</span><span class="n">props</span><span class="o">);</span>
    <span class="o">}</span>
    
    <span class="nd">@Bean</span>
    <span class="kd">public</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">kafkaListenerContainerFactory</span><span class="o">(</span>
            <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">consumerFactory</span><span class="o">,</span>
            <span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">kafkaTemplate</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">factory</span> <span class="o">=</span> 
            <span class="k">new</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;&gt;();</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">setConsumerFactory</span><span class="o">(</span><span class="n">consumerFactory</span><span class="o">);</span>
        
        <span class="c1">// Commit after each record for minimal duplicates</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">getContainerProperties</span><span class="o">().</span><span class="na">setAckMode</span><span class="o">(</span><span class="nc">ContainerProperties</span><span class="o">.</span><span class="na">AckMode</span><span class="o">.</span><span class="na">RECORD</span><span class="o">);</span>
        
        <span class="c1">// Stop immediately on shutdown</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">getContainerProperties</span><span class="o">().</span><span class="na">setStopImmediate</span><span class="o">(</span><span class="kc">true</span><span class="o">);</span>
        
        <span class="c1">// Configure DLT error handler</span>
        <span class="nc">DeadLetterPublishingRecoverer</span> <span class="n">recoverer</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DeadLetterPublishingRecoverer</span><span class="o">(</span>
            <span class="n">kafkaTemplate</span><span class="o">,</span>
            <span class="o">(</span><span class="n">record</span><span class="o">,</span> <span class="n">ex</span><span class="o">)</span> <span class="o">-&gt;</span> <span class="o">{</span>
                <span class="c1">// Custom DLT routing based on exception</span>
                <span class="k">if</span> <span class="o">(</span><span class="n">ex</span><span class="o">.</span><span class="na">getCause</span><span class="o">()</span> <span class="k">instanceof</span> <span class="nc">ValidationException</span><span class="o">)</span> <span class="o">{</span>
                    <span class="k">return</span> <span class="k">new</span> <span class="nf">TopicPartition</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">()</span> <span class="o">+</span> <span class="s">".validation.DLT"</span><span class="o">,</span> <span class="o">-</span><span class="mi">1</span><span class="o">);</span>
                <span class="o">}</span>
                <span class="k">return</span> <span class="k">new</span> <span class="nf">TopicPartition</span><span class="o">(</span><span class="n">record</span><span class="o">.</span><span class="na">topic</span><span class="o">()</span> <span class="o">+</span> <span class="s">".DLT"</span><span class="o">,</span> <span class="n">record</span><span class="o">.</span><span class="na">partition</span><span class="o">());</span>
            <span class="o">}</span>
        <span class="o">);</span>
        
        <span class="c1">// Exponential backoff with max retries</span>
        <span class="nc">ExponentialBackOffWithMaxRetries</span> <span class="n">backOff</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ExponentialBackOffWithMaxRetries</span><span class="o">(</span><span class="mi">5</span><span class="o">);</span>
        <span class="n">backOff</span><span class="o">.</span><span class="na">setInitialInterval</span><span class="o">(</span><span class="mi">1000L</span><span class="o">);</span>
        <span class="n">backOff</span><span class="o">.</span><span class="na">setMultiplier</span><span class="o">(</span><span class="mf">2.0</span><span class="o">);</span>
        <span class="n">backOff</span><span class="o">.</span><span class="na">setMaxInterval</span><span class="o">(</span><span class="mi">30000L</span><span class="o">);</span>
        
        <span class="nc">DefaultErrorHandler</span> <span class="n">errorHandler</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DefaultErrorHandler</span><span class="o">(</span><span class="n">recoverer</span><span class="o">,</span> <span class="n">backOff</span><span class="o">);</span>
        
        <span class="c1">// Don't retry validation errors</span>
        <span class="n">errorHandler</span><span class="o">.</span><span class="na">addNotRetryableExceptions</span><span class="o">(</span><span class="nc">ValidationException</span><span class="o">.</span><span class="na">class</span><span class="o">);</span>
        
        <span class="c1">// Reset retry state if exception type changes</span>
        <span class="n">errorHandler</span><span class="o">.</span><span class="na">setResetStateOnExceptionChange</span><span class="o">(</span><span class="kc">true</span><span class="o">);</span>
        
        <span class="n">factory</span><span class="o">.</span><span class="na">setCommonErrorHandler</span><span class="o">(</span><span class="n">errorHandler</span><span class="o">);</span>
        
        <span class="k">return</span> <span class="n">factory</span><span class="o">;</span>
    <span class="o">}</span>
    
    <span class="nd">@Bean</span>
    <span class="kd">public</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="nf">batchFactory</span><span class="o">(</span>
            <span class="nc">ConsumerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">consumerFactory</span><span class="o">,</span>
            <span class="nc">KafkaTemplate</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">kafkaTemplate</span><span class="o">)</span> <span class="o">{</span>
        
        <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Order</span><span class="o">&gt;</span> <span class="n">factory</span> <span class="o">=</span> 
            <span class="k">new</span> <span class="nc">ConcurrentKafkaListenerContainerFactory</span><span class="o">&lt;&gt;();</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">setConsumerFactory</span><span class="o">(</span><span class="n">consumerFactory</span><span class="o">);</span>
        <span class="n">factory</span><span class="o">.</span><span class="na">setBatchListener</span><span class="o">(</span><span class="kc">true</span><span class="o">);</span>
        
        <span class="c1">// Similar error handler for batch processing</span>
        <span class="nc">DeadLetterPublishingRecoverer</span> <span class="n">recoverer</span> <span class="o">=</span> 
            <span class="k">new</span> <span class="nf">DeadLetterPublishingRecoverer</span><span class="o">(</span><span class="n">kafkaTemplate</span><span class="o">);</span>
        
        <span class="nc">DefaultErrorHandler</span> <span class="n">errorHandler</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">DefaultErrorHandler</span><span class="o">(</span>
            <span class="n">recoverer</span><span class="o">,</span>
            <span class="k">new</span> <span class="nf">FixedBackOff</span><span class="o">(</span><span class="mi">1000L</span><span class="o">,</span> <span class="mi">3L</span><span class="o">)</span>
        <span class="o">);</span>
        
        <span class="n">factory</span><span class="o">.</span><span class="na">setCommonErrorHandler</span><span class="o">(</span><span class="n">errorHandler</span><span class="o">);</span>
        
        <span class="k">return</span> <span class="n">factory</span><span class="o">;</span>
    <span class="o">}</span>
    
    <span class="c1">// Create DLT topics automatically</span>
    <span class="nd">@Bean</span>
    <span class="kd">public</span> <span class="nc">NewTopic</span> <span class="nf">ordersDlt</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="nc">TopicBuilder</span>
            <span class="o">.</span><span class="na">name</span><span class="o">(</span><span class="s">"orders.DLT"</span><span class="o">)</span>
            <span class="o">.</span><span class="na">partitions</span><span class="o">(</span><span class="mi">10</span><span class="o">)</span>
            <span class="o">.</span><span class="na">replicas</span><span class="o">(</span><span class="mi">3</span><span class="o">)</span>
            <span class="o">.</span><span class="na">build</span><span class="o">();</span>
    <span class="o">}</span>
    
    <span class="nd">@Bean</span>
    <span class="kd">public</span> <span class="nc">NewTopic</span> <span class="nf">ordersValidationDlt</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="nc">TopicBuilder</span>
            <span class="o">.</span><span class="na">name</span><span class="o">(</span><span class="s">"orders.validation.DLT"</span><span class="o">)</span>
            <span class="o">.</span><span class="na">partitions</span><span class="o">(</span><span class="mi">10</span><span class="o">)</span>
            <span class="o">.</span><span class="na">replicas</span><span class="o">(</span><span class="mi">3</span><span class="o">)</span>
            <span class="o">.</span><span class="na">build</span><span class="o">();</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p><strong>application.yml:</strong></p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">spring</span><span class="pi">:</span>
  <span class="na">kafka</span><span class="pi">:</span>
    <span class="na">bootstrap-servers</span><span class="pi">:</span> <span class="s">localhost:9092</span>
    <span class="na">consumer</span><span class="pi">:</span>
      <span class="na">group-id</span><span class="pi">:</span> <span class="s">order-service</span>
      <span class="na">enable-auto-commit</span><span class="pi">:</span> <span class="no">false</span>
      <span class="na">key-deserializer</span><span class="pi">:</span> <span class="s">org.apache.kafka.common.serialization.StringDeserializer</span>
      <span class="na">value-deserializer</span><span class="pi">:</span> <span class="s">org.springframework.kafka.support.serializer.ErrorHandlingDeserializer</span>
      <span class="na">properties</span><span class="pi">:</span>
        <span class="na">spring.deserializer.value.delegate.class</span><span class="pi">:</span> <span class="s">org.springframework.kafka.support.serializer.JsonDeserializer</span>
        <span class="na">spring.json.trusted.packages</span><span class="pi">:</span> <span class="s">com.example.model</span>
    <span class="na">listener</span><span class="pi">:</span>
      <span class="na">ack-mode</span><span class="pi">:</span> <span class="s">record</span>
      <span class="na">immediate-stop</span><span class="pi">:</span> <span class="no">true</span>

<span class="na">logging</span><span class="pi">:</span>
  <span class="na">level</span><span class="pi">:</span>
    <span class="na">org.springframework.kafka</span><span class="pi">:</span> <span class="s">DEBUG</span>
</code></pre></div></div>

<h2 id="9-final-thoughts">9. Final Thoughts</h2>

<p>Error handling in Spring Kafka requires understanding how offsets, acknowledgments, retries, and dead letter topics work together.</p>

<p><strong>Key takeaways:</strong></p>

<ul>
  <li>Use <code class="language-plaintext highlighter-rouge">RECORD</code> ack mode for minimal duplicates, <code class="language-plaintext highlighter-rouge">BATCH</code> for higher throughput</li>
  <li>Always configure <code class="language-plaintext highlighter-rouge">DeadLetterPublishingRecoverer</code> for production</li>
  <li>Make your processing logic idempotent to handle duplicates</li>
  <li>Use <code class="language-plaintext highlighter-rouge">ErrorHandlingDeserializer</code> to prevent deserialization errors from blocking consumers</li>
  <li>For batch listeners, always throw <code class="language-plaintext highlighter-rouge">BatchListenerFailedException</code> with the failed record</li>
  <li>Use <code class="language-plaintext highlighter-rouge">MANUAL_IMMEDIATE</code> ack mode for async processing with custom thread pools</li>
  <li>For maximum throughput, process batches asynchronously with <code class="language-plaintext highlighter-rouge">CompletableFuture</code> — track all tasks before acknowledging</li>
  <li>Choose async batch processing strategy based on requirements: all-or-nothing (simple), finegrained (high throughput), or retry-based (best balance)</li>
  <li>Configure appropriate backoff strategies based on your error types</li>
  <li>Create DLT topics ahead of time with correct partition counts</li>
  <li>Size thread pools based on consumer concurrency: core threads = 2-3x consumer threads, queue = max-poll-records × concurrency × 2</li>
  <li>Monitor async processing metrics: processing time, success/failure rates, thread pool utilization, consumer lag</li>
</ul>

<p>Spring Kafka’s error handling is flexible enough to handle most real-world scenarios. The key is understanding the trade-offs between throughput, latency, and message delivery guarantees. When pushing for maximum throughput with async batch processing, carefully balance implementation complexity against reliability requirements.</p>

<h2 id="10-references">10. References</h2>

<ul>
  <li><a href="https://docs.spring.io/spring-kafka/reference/kafka/annotation-error-handling.html">https://docs.spring.io/spring-kafka/reference/kafka/annotation-error-handling.html</a></li>
  <li><a href="https://piotrminkowski.com/2024/03/11/kafka-offset-with-spring-boot/">https://piotrminkowski.com/2024/03/11/kafka-offset-with-spring-boot/</a></li>
  <li><a href="https://runebook.dev/en/docs/spring_boot/application-properties/application-properties.integration.spring.kafka.listener.async-acks">https://runebook.dev/en/docs/spring_boot/application-properties/application-properties.integration.spring.kafka.listener.async-acks</a></li>
</ul>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Kafka" /><category term="Spring Boot" /><category term="Java" /><category term="Best Practices" /><summary type="html"><![CDATA[This article covers error handling strategies in Spring Kafka, including offset management, retry mechanisms, dead letter topics, batch error handling, and common pitfalls to avoid when building resilient Kafka consumers.]]></summary></entry><entry><title type="html">Build a Boolean Expression Evaluator in Java</title><link href="https://hoangtl.site/posts/boolean-expression-evaluator/" rel="alternate" type="text/html" title="Build a Boolean Expression Evaluator in Java" /><published>2025-08-22T00:00:00+00:00</published><updated>2025-08-22T00:00:00+00:00</updated><id>https://hoangtl.site/posts/boolean-expression-evaluator</id><content type="html" xml:base="https://hoangtl.site/posts/boolean-expression-evaluator/"><![CDATA[<p>Business rules often start as simple <code class="language-plaintext highlighter-rouge">if</code> statements. That is usually fine, because hardcoded logic is fast, easy to debug, and checked by the compiler. The problem starts when the rule changes more often than the codebase, or when different customers, cohorts, regions, or experiments need different versions of the same decision logic.</p>

<p>At that point, every rule change becomes a deployment. A product manager asks to add a region, marketing wants to test a different eligibility path, sales needs an enterprise override, and engineering ends up threading feature flags through a method that was supposed to be a clean predicate. The code still runs, but it no longer represents a stable algorithm. It represents mutable business policy trapped inside compiled Java.</p>

<p>A Boolean expression evaluator moves that policy into data. The application still controls which variables are available and how those variables are computed, but the rule itself can be stored, validated, versioned, cached, and evaluated at runtime.</p>

<p>This post builds a small Boolean expression evaluator in Java. It supports variables, <code class="language-plaintext highlighter-rouge">AND</code>, <code class="language-plaintext highlighter-rouge">OR</code>, <code class="language-plaintext highlighter-rouge">NOT</code>, and parentheses. The implementation uses a tokenizer, a recursive descent parser, an abstract syntax tree, and an evaluator with real short-circuit behavior.</p>

<h2 id="1-the-problem-with-hardcoded-rules">1. The Problem with Hardcoded Rules</h2>

<p>A simple eligibility check is a good fit for normal Java code.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kt">boolean</span> <span class="nf">checkEligibility</span><span class="o">(</span><span class="nc">User</span> <span class="n">user</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">return</span> <span class="n">user</span><span class="o">.</span><span class="na">isActive</span><span class="o">()</span> <span class="o">&amp;&amp;</span> <span class="n">user</span><span class="o">.</span><span class="na">getAge</span><span class="o">()</span> <span class="o">&gt;=</span> <span class="mi">18</span><span class="o">;</span>
<span class="o">}</span>
</code></pre></div></div>

<p>This is readable, fast, and hard to misuse. The rule is close to the domain model, the compiler checks the method, and tests can cover the few branches that exist.</p>

<p>Now consider a more realistic rule.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kt">boolean</span> <span class="nf">checkEligibility</span><span class="o">(</span><span class="nc">User</span> <span class="n">user</span><span class="o">)</span> <span class="o">{</span>
    <span class="k">return</span> <span class="n">user</span><span class="o">.</span><span class="na">isActive</span><span class="o">()</span>
            <span class="o">&amp;&amp;</span> <span class="o">((</span><span class="n">user</span><span class="o">.</span><span class="na">getAge</span><span class="o">()</span> <span class="o">&gt;=</span> <span class="mi">18</span> <span class="o">&amp;&amp;</span> <span class="n">user</span><span class="o">.</span><span class="na">hasVerifiedEmail</span><span class="o">())</span>
                <span class="o">||</span> <span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">getAge</span><span class="o">()</span> <span class="o">&gt;=</span> <span class="mi">13</span> <span class="o">&amp;&amp;</span> <span class="n">user</span><span class="o">.</span><span class="na">hasParentConsent</span><span class="o">()))</span>
            <span class="o">&amp;&amp;</span> <span class="o">(</span><span class="s">"US"</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">getRegion</span><span class="o">())</span>
                <span class="o">||</span> <span class="s">"CA"</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">getRegion</span><span class="o">())</span>
                <span class="o">||</span> <span class="s">"UK"</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">getRegion</span><span class="o">()))</span>
            <span class="o">&amp;&amp;</span> <span class="o">!</span><span class="n">user</span><span class="o">.</span><span class="na">isBlacklisted</span><span class="o">()</span>
            <span class="o">&amp;&amp;</span> <span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">isPremium</span><span class="o">()</span>
                <span class="o">||</span> <span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">isTrial</span><span class="o">()</span> <span class="o">&amp;&amp;</span> <span class="n">user</span><span class="o">.</span><span class="na">getDaysActive</span><span class="o">()</span> <span class="o">&lt;=</span> <span class="mi">30</span><span class="o">));</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The method is still correct, but it now combines several concerns:</p>

<ul>
  <li>extracting facts from <code class="language-plaintext highlighter-rouge">User</code></li>
  <li>encoding business policy</li>
  <li>controlling Boolean operator precedence</li>
  <li>handling future rule variants through code changes</li>
</ul>

<p>The immediate cost is readability. The larger cost is operational. Adding a new region, changing the trial window, removing email verification for an experiment, or introducing a tenant-specific override requires a code change, a review, a test cycle, and a deployment. If the system serves multiple tenants, this pattern usually turns into duplicated methods, nested feature flags, or rule-specific branches scattered across services.</p>

<p>A runtime evaluator separates the stable part from the volatile part. Java code computes named facts, while a stored expression decides how those facts are combined.</p>

<h2 id="2-rules-as-runtime-data">2. Rules as Runtime Data</h2>

<p>Instead of compiling the whole rule into Java, store the Boolean expression as a string.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">String</span> <span class="n">eligibilityRule</span> <span class="o">=</span>
        <span class="s">"isActive AND "</span>
      <span class="o">+</span> <span class="s">"((age_gte_18 AND hasVerifiedEmail) OR (age_gte_13 AND hasParentConsent)) AND "</span>
      <span class="o">+</span> <span class="s">"(region_US OR region_CA OR region_UK) AND "</span>
      <span class="o">+</span> <span class="s">"NOT isBlacklisted AND "</span>
      <span class="o">+</span> <span class="s">"(isPremium OR (isTrial AND daysActive_lte_30))"</span><span class="o">;</span>
</code></pre></div></div>

<p>The application builds a context map from the domain object.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Boolean</span><span class="o">&gt;</span> <span class="nf">buildContext</span><span class="o">(</span><span class="nc">User</span> <span class="n">user</span><span class="o">)</span> <span class="o">{</span>
    <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Boolean</span><span class="o">&gt;</span> <span class="n">context</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">HashMap</span><span class="o">&lt;&gt;();</span>

    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"isActive"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">isActive</span><span class="o">());</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"age_gte_18"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">getAge</span><span class="o">()</span> <span class="o">&gt;=</span> <span class="mi">18</span><span class="o">);</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"age_gte_13"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">getAge</span><span class="o">()</span> <span class="o">&gt;=</span> <span class="mi">13</span><span class="o">);</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"hasVerifiedEmail"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">hasVerifiedEmail</span><span class="o">());</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"hasParentConsent"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">hasParentConsent</span><span class="o">());</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"region_US"</span><span class="o">,</span> <span class="s">"US"</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">getRegion</span><span class="o">()));</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"region_CA"</span><span class="o">,</span> <span class="s">"CA"</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">getRegion</span><span class="o">()));</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"region_UK"</span><span class="o">,</span> <span class="s">"UK"</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">user</span><span class="o">.</span><span class="na">getRegion</span><span class="o">()));</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"isBlacklisted"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">isBlacklisted</span><span class="o">());</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"isPremium"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">isPremium</span><span class="o">());</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"isTrial"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">isTrial</span><span class="o">());</span>
    <span class="n">context</span><span class="o">.</span><span class="na">put</span><span class="o">(</span><span class="s">"daysActive_lte_30"</span><span class="o">,</span> <span class="n">user</span><span class="o">.</span><span class="na">getDaysActive</span><span class="o">()</span> <span class="o">&lt;=</span> <span class="mi">30</span><span class="o">);</span>

    <span class="k">return</span> <span class="n">context</span><span class="o">;</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The service method becomes small again.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kt">boolean</span> <span class="nf">checkEligibility</span><span class="o">(</span><span class="nc">User</span> <span class="n">user</span><span class="o">,</span> <span class="nc">String</span> <span class="n">expression</span><span class="o">)</span> <span class="o">{</span>
    <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Boolean</span><span class="o">&gt;</span> <span class="n">context</span> <span class="o">=</span> <span class="n">buildContext</span><span class="o">(</span><span class="n">user</span><span class="o">);</span>
    <span class="k">return</span> <span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span><span class="n">expression</span><span class="o">,</span> <span class="n">context</span><span class="o">);</span>
<span class="o">}</span>
</code></pre></div></div>

<p>This design makes one boundary explicit: the evaluator does not know about <code class="language-plaintext highlighter-rouge">User</code>, regions, subscriptions, trials, or blacklists. It only knows how to evaluate a Boolean expression against named Boolean values. That constraint keeps the evaluator reusable and reduces the risk of turning it into an unbounded scripting layer.</p>

<p>The trade-off is also clear. You lose compile-time validation for the expression string, so you must replace it with save-time validation, good error messages, safe rollout, and monitoring. Runtime rules are useful when policy changes frequently, but they need guardrails because bad rules fail at runtime unless you catch them earlier.</p>

<h2 id="3-use-cases">3. Use Cases</h2>

<p>Boolean expression evaluators are useful when a system needs configurable decision logic but does not need a full rule engine.</p>

<p>Feature flags are a common example.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">String</span> <span class="n">rule</span> <span class="o">=</span> <span class="s">"isEmployee AND country_US AND NOT blockedUser"</span><span class="o">;</span>

<span class="k">if</span> <span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span><span class="n">rule</span><span class="o">,</span> <span class="n">context</span><span class="o">))</span> <span class="o">{</span>
    <span class="n">showFeature</span><span class="o">();</span>
<span class="o">}</span>
</code></pre></div></div>

<p>Authorization checks are another natural fit, especially when policies differ between tenants or environments.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">String</span> <span class="n">rule</span> <span class="o">=</span> <span class="s">"hasRole_admin OR (hasRole_manager AND department_engineering)"</span><span class="o">;</span>

<span class="k">if</span> <span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span><span class="n">rule</span><span class="o">,</span> <span class="n">context</span><span class="o">))</span> <span class="o">{</span>
    <span class="n">allowAccess</span><span class="o">();</span>
<span class="o">}</span>
</code></pre></div></div>

<p>Notification systems can use the same pattern to decide whether an event should trigger a message.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nc">String</span> <span class="n">rule</span> <span class="o">=</span> <span class="s">"order_total_gt_1000 AND (vipCustomer OR firstPurchase)"</span><span class="o">;</span>

<span class="k">if</span> <span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span><span class="n">rule</span><span class="o">,</span> <span class="n">context</span><span class="o">))</span> <span class="o">{</span>
    <span class="n">sendOffer</span><span class="o">();</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The evaluator should remain narrow. If the business needs numeric comparison, string matching, list membership, date arithmetic, or custom functions, those features can be added, but each one expands the language surface and increases the cost of validation, testing, and abuse prevention.</p>

<h2 id="4-evaluator-architecture">4. Evaluator Architecture</h2>

<p>The evaluator has three stages.</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Input:
  "NOT (A AND B) OR C"

Tokenizer:
  [NOT, LPAREN, A, AND, B, RPAREN, OR, C, EOF]

Parser:
  builds an abstract syntax tree

AST:
        OR
       /  \
     NOT   C
      |
     AND
    /   \
   A     B

Evaluator:
  walks the tree and reads values from the context map
</code></pre></div></div>

<p>The tokenizer turns raw characters into tokens. The parser turns tokens into an abstract syntax tree, usually called an AST. The evaluator walks that tree and computes the final Boolean result.</p>

<p>This architecture gives each component one job. Tokenization errors are about invalid characters. Parser errors are about invalid grammar. Evaluation errors are about missing variables or unsupported operators. That separation matters in production because different failures need different responses: invalid syntax should block rule activation, while missing variables usually indicate a mismatch between the rule catalog and the application’s context builder.</p>

<p>The grammar is small.</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>expression    := orExpression
orExpression  := andExpression ("OR" andExpression)*
andExpression := notExpression ("AND" notExpression)*
notExpression := "NOT" notExpression | primary
primary       := VARIABLE | "(" expression ")"
</code></pre></div></div>

<p>This gives <code class="language-plaintext highlighter-rouge">NOT</code> the highest precedence, followed by <code class="language-plaintext highlighter-rouge">AND</code>, then <code class="language-plaintext highlighter-rouge">OR</code>. Parentheses override that order.</p>

<h2 id="5-implementation">5. Implementation</h2>

<p>The implementation below uses a hand-written recursive descent parser. For this grammar, that is simpler than introducing a parser generator, and it makes precedence easy to inspect in code.</p>

<h3 id="51-token-model">5.1. Token Model</h3>

<p>Each token has a type, value, and source position. Position is not needed for evaluation, but it is useful for error messages.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">enum</span> <span class="nc">TokenType</span> <span class="o">{</span>
    <span class="no">VARIABLE</span><span class="o">,</span>
    <span class="no">AND</span><span class="o">,</span>
    <span class="no">OR</span><span class="o">,</span>
    <span class="no">NOT</span><span class="o">,</span>
    <span class="no">LPAREN</span><span class="o">,</span>
    <span class="no">RPAREN</span><span class="o">,</span>
    <span class="no">EOF</span>
<span class="o">}</span>

<span class="kd">final</span> <span class="kd">class</span> <span class="nc">Token</span> <span class="o">{</span>
    <span class="kd">final</span> <span class="nc">TokenType</span> <span class="n">type</span><span class="o">;</span>
    <span class="kd">final</span> <span class="nc">String</span> <span class="n">value</span><span class="o">;</span>
    <span class="kd">final</span> <span class="kt">int</span> <span class="n">position</span><span class="o">;</span>

    <span class="nc">Token</span><span class="o">(</span><span class="nc">TokenType</span> <span class="n">type</span><span class="o">,</span> <span class="nc">String</span> <span class="n">value</span><span class="o">,</span> <span class="kt">int</span> <span class="n">position</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">type</span> <span class="o">=</span> <span class="n">type</span><span class="o">;</span>
        <span class="k">this</span><span class="o">.</span><span class="na">value</span> <span class="o">=</span> <span class="n">value</span><span class="o">;</span>
        <span class="k">this</span><span class="o">.</span><span class="na">position</span> <span class="o">=</span> <span class="n">position</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="nd">@Override</span>
    <span class="kd">public</span> <span class="nc">String</span> <span class="nf">toString</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">value</span> <span class="o">==</span> <span class="kc">null</span> <span class="o">?</span> <span class="n">type</span><span class="o">.</span><span class="na">name</span><span class="o">()</span> <span class="o">:</span> <span class="n">type</span> <span class="o">+</span> <span class="s">"("</span> <span class="o">+</span> <span class="n">value</span> <span class="o">+</span> <span class="s">")"</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The language reserves <code class="language-plaintext highlighter-rouge">AND</code>, <code class="language-plaintext highlighter-rouge">OR</code>, and <code class="language-plaintext highlighter-rouge">NOT</code>. Variable names are case-sensitive in this implementation, while keywords are case-insensitive.</p>

<h3 id="52-parse-exception">5.2. Parse Exception</h3>

<p>A runtime expression language needs precise errors. Returning only <code class="language-plaintext highlighter-rouge">Invalid expression</code> is cheap for the implementation, but expensive for whoever has to debug a rejected rule.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">final</span> <span class="kd">class</span> <span class="nc">ExpressionParseException</span> <span class="kd">extends</span> <span class="nc">RuntimeException</span> <span class="o">{</span>
    <span class="nc">ExpressionParseException</span><span class="o">(</span><span class="nc">String</span> <span class="n">message</span><span class="o">,</span> <span class="kt">int</span> <span class="n">position</span><span class="o">,</span> <span class="nc">String</span> <span class="n">expression</span><span class="o">)</span> <span class="o">{</span>
        <span class="kd">super</span><span class="o">(</span><span class="n">format</span><span class="o">(</span><span class="n">message</span><span class="o">,</span> <span class="n">position</span><span class="o">,</span> <span class="n">expression</span><span class="o">));</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kd">static</span> <span class="nc">String</span> <span class="nf">format</span><span class="o">(</span><span class="nc">String</span> <span class="n">message</span><span class="o">,</span> <span class="kt">int</span> <span class="n">position</span><span class="o">,</span> <span class="nc">String</span> <span class="n">expression</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">message</span> <span class="o">+</span> <span class="s">" at position "</span> <span class="o">+</span> <span class="n">position</span>
                <span class="o">+</span> <span class="nc">System</span><span class="o">.</span><span class="na">lineSeparator</span><span class="o">()</span>
                <span class="o">+</span> <span class="n">expression</span>
                <span class="o">+</span> <span class="nc">System</span><span class="o">.</span><span class="na">lineSeparator</span><span class="o">()</span>
                <span class="o">+</span> <span class="s">" "</span><span class="o">.</span><span class="na">repeat</span><span class="o">(</span><span class="nc">Math</span><span class="o">.</span><span class="na">max</span><span class="o">(</span><span class="mi">0</span><span class="o">,</span> <span class="n">position</span><span class="o">))</span> <span class="o">+</span> <span class="s">"^"</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>For example, <code class="language-plaintext highlighter-rouge">A AND (B OR)</code> can point directly to the token position where another operand was expected.</p>

<h3 id="53-tokenizer">5.3. Tokenizer</h3>

<p>The tokenizer scans the input once. It skips whitespace, emits parentheses, reads identifiers, and maps reserved keywords to operator tokens.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">java.util.ArrayList</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.List</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.Locale</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.Map</span><span class="o">;</span>

<span class="kd">final</span> <span class="kd">class</span> <span class="nc">Tokenizer</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">TokenType</span><span class="o">&gt;</span> <span class="no">KEYWORDS</span> <span class="o">=</span> <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span>
            <span class="s">"AND"</span><span class="o">,</span> <span class="nc">TokenType</span><span class="o">.</span><span class="na">AND</span><span class="o">,</span>
            <span class="s">"OR"</span><span class="o">,</span> <span class="nc">TokenType</span><span class="o">.</span><span class="na">OR</span><span class="o">,</span>
            <span class="s">"NOT"</span><span class="o">,</span> <span class="nc">TokenType</span><span class="o">.</span><span class="na">NOT</span>
    <span class="o">);</span>

    <span class="kd">private</span> <span class="nf">Tokenizer</span><span class="o">()</span> <span class="o">{</span>
    <span class="o">}</span>

    <span class="kd">static</span> <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Token</span><span class="o">&gt;</span> <span class="nf">tokenize</span><span class="o">(</span><span class="nc">String</span> <span class="n">input</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">input</span> <span class="o">==</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Expression must not be null"</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Token</span><span class="o">&gt;</span> <span class="n">tokens</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ArrayList</span><span class="o">&lt;&gt;();</span>
        <span class="kt">int</span> <span class="n">pos</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span>

        <span class="k">while</span> <span class="o">(</span><span class="n">pos</span> <span class="o">&lt;</span> <span class="n">input</span><span class="o">.</span><span class="na">length</span><span class="o">())</span> <span class="o">{</span>
            <span class="kt">char</span> <span class="n">ch</span> <span class="o">=</span> <span class="n">input</span><span class="o">.</span><span class="na">charAt</span><span class="o">(</span><span class="n">pos</span><span class="o">);</span>

            <span class="k">if</span> <span class="o">(</span><span class="nc">Character</span><span class="o">.</span><span class="na">isWhitespace</span><span class="o">(</span><span class="n">ch</span><span class="o">))</span> <span class="o">{</span>
                <span class="n">pos</span><span class="o">++;</span>
                <span class="k">continue</span><span class="o">;</span>
            <span class="o">}</span>

            <span class="k">if</span> <span class="o">(</span><span class="n">ch</span> <span class="o">==</span> <span class="sc">'('</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">tokens</span><span class="o">.</span><span class="na">add</span><span class="o">(</span><span class="k">new</span> <span class="nc">Token</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">LPAREN</span><span class="o">,</span> <span class="s">"("</span><span class="o">,</span> <span class="n">pos</span><span class="o">));</span>
                <span class="n">pos</span><span class="o">++;</span>
                <span class="k">continue</span><span class="o">;</span>
            <span class="o">}</span>

            <span class="k">if</span> <span class="o">(</span><span class="n">ch</span> <span class="o">==</span> <span class="sc">')'</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">tokens</span><span class="o">.</span><span class="na">add</span><span class="o">(</span><span class="k">new</span> <span class="nc">Token</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">RPAREN</span><span class="o">,</span> <span class="s">")"</span><span class="o">,</span> <span class="n">pos</span><span class="o">));</span>
                <span class="n">pos</span><span class="o">++;</span>
                <span class="k">continue</span><span class="o">;</span>
            <span class="o">}</span>

            <span class="k">if</span> <span class="o">(</span><span class="nc">Character</span><span class="o">.</span><span class="na">isLetter</span><span class="o">(</span><span class="n">ch</span><span class="o">))</span> <span class="o">{</span>
                <span class="kt">int</span> <span class="n">start</span> <span class="o">=</span> <span class="n">pos</span><span class="o">;</span>
                <span class="nc">StringBuilder</span> <span class="n">builder</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">StringBuilder</span><span class="o">();</span>

                <span class="k">while</span> <span class="o">(</span><span class="n">pos</span> <span class="o">&lt;</span> <span class="n">input</span><span class="o">.</span><span class="na">length</span><span class="o">())</span> <span class="o">{</span>
                    <span class="kt">char</span> <span class="n">current</span> <span class="o">=</span> <span class="n">input</span><span class="o">.</span><span class="na">charAt</span><span class="o">(</span><span class="n">pos</span><span class="o">);</span>

                    <span class="k">if</span> <span class="o">(</span><span class="nc">Character</span><span class="o">.</span><span class="na">isLetterOrDigit</span><span class="o">(</span><span class="n">current</span><span class="o">)</span> <span class="o">||</span> <span class="n">current</span> <span class="o">==</span> <span class="sc">'_'</span><span class="o">)</span> <span class="o">{</span>
                        <span class="n">builder</span><span class="o">.</span><span class="na">append</span><span class="o">(</span><span class="n">current</span><span class="o">);</span>
                        <span class="n">pos</span><span class="o">++;</span>
                    <span class="o">}</span> <span class="k">else</span> <span class="o">{</span>
                        <span class="k">break</span><span class="o">;</span>
                    <span class="o">}</span>
                <span class="o">}</span>

                <span class="nc">String</span> <span class="n">rawValue</span> <span class="o">=</span> <span class="n">builder</span><span class="o">.</span><span class="na">toString</span><span class="o">();</span>
                <span class="nc">String</span> <span class="n">upperValue</span> <span class="o">=</span> <span class="n">rawValue</span><span class="o">.</span><span class="na">toUpperCase</span><span class="o">(</span><span class="nc">Locale</span><span class="o">.</span><span class="na">ROOT</span><span class="o">);</span>
                <span class="nc">TokenType</span> <span class="n">type</span> <span class="o">=</span> <span class="no">KEYWORDS</span><span class="o">.</span><span class="na">getOrDefault</span><span class="o">(</span><span class="n">upperValue</span><span class="o">,</span> <span class="nc">TokenType</span><span class="o">.</span><span class="na">VARIABLE</span><span class="o">);</span>
                <span class="nc">String</span> <span class="n">tokenValue</span> <span class="o">=</span> <span class="n">type</span> <span class="o">==</span> <span class="nc">TokenType</span><span class="o">.</span><span class="na">VARIABLE</span> <span class="o">?</span> <span class="n">rawValue</span> <span class="o">:</span> <span class="n">upperValue</span><span class="o">;</span>

                <span class="n">tokens</span><span class="o">.</span><span class="na">add</span><span class="o">(</span><span class="k">new</span> <span class="nc">Token</span><span class="o">(</span><span class="n">type</span><span class="o">,</span> <span class="n">tokenValue</span><span class="o">,</span> <span class="n">start</span><span class="o">));</span>
                <span class="k">continue</span><span class="o">;</span>
            <span class="o">}</span>

            <span class="k">throw</span> <span class="k">new</span> <span class="nf">ExpressionParseException</span><span class="o">(</span>
                    <span class="s">"Unexpected character '"</span> <span class="o">+</span> <span class="n">ch</span> <span class="o">+</span> <span class="s">"'"</span><span class="o">,</span>
                    <span class="n">pos</span><span class="o">,</span>
                    <span class="n">input</span>
            <span class="o">);</span>
        <span class="o">}</span>

        <span class="n">tokens</span><span class="o">.</span><span class="na">add</span><span class="o">(</span><span class="k">new</span> <span class="nc">Token</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">EOF</span><span class="o">,</span> <span class="kc">null</span><span class="o">,</span> <span class="n">input</span><span class="o">.</span><span class="na">length</span><span class="o">()));</span>
        <span class="k">return</span> <span class="n">tokens</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>This version intentionally rejects Java-style operators such as <code class="language-plaintext highlighter-rouge">&amp;&amp;</code>, <code class="language-plaintext highlighter-rouge">||</code>, and <code class="language-plaintext highlighter-rouge">!</code>. Supporting aliases is easy, but doing so often makes rule authoring less consistent. A small language is easier to validate, document, and expose through a UI.</p>

<h3 id="54-ast-nodes">5.4. AST Nodes</h3>

<p>The AST has three node types.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">abstract</span> <span class="kd">class</span> <span class="nc">Node</span> <span class="o">{</span>
<span class="o">}</span>

<span class="kd">final</span> <span class="kd">class</span> <span class="nc">VariableNode</span> <span class="kd">extends</span> <span class="nc">Node</span> <span class="o">{</span>
    <span class="kd">final</span> <span class="nc">String</span> <span class="n">name</span><span class="o">;</span>

    <span class="nc">VariableNode</span><span class="o">(</span><span class="nc">String</span> <span class="n">name</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">name</span> <span class="o">=</span> <span class="n">name</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

<span class="kd">final</span> <span class="kd">class</span> <span class="nc">UnaryOpNode</span> <span class="kd">extends</span> <span class="nc">Node</span> <span class="o">{</span>
    <span class="kd">final</span> <span class="nc">String</span> <span class="n">operator</span><span class="o">;</span>
    <span class="kd">final</span> <span class="nc">Node</span> <span class="n">operand</span><span class="o">;</span>

    <span class="nc">UnaryOpNode</span><span class="o">(</span><span class="nc">String</span> <span class="n">operator</span><span class="o">,</span> <span class="nc">Node</span> <span class="n">operand</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">operator</span> <span class="o">=</span> <span class="n">operator</span><span class="o">;</span>
        <span class="k">this</span><span class="o">.</span><span class="na">operand</span> <span class="o">=</span> <span class="n">operand</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>

<span class="kd">final</span> <span class="kd">class</span> <span class="nc">BinaryOpNode</span> <span class="kd">extends</span> <span class="nc">Node</span> <span class="o">{</span>
    <span class="kd">final</span> <span class="nc">String</span> <span class="n">operator</span><span class="o">;</span>
    <span class="kd">final</span> <span class="nc">Node</span> <span class="n">left</span><span class="o">;</span>
    <span class="kd">final</span> <span class="nc">Node</span> <span class="n">right</span><span class="o">;</span>

    <span class="nc">BinaryOpNode</span><span class="o">(</span><span class="nc">String</span> <span class="n">operator</span><span class="o">,</span> <span class="nc">Node</span> <span class="n">left</span><span class="o">,</span> <span class="nc">Node</span> <span class="n">right</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">operator</span> <span class="o">=</span> <span class="n">operator</span><span class="o">;</span>
        <span class="k">this</span><span class="o">.</span><span class="na">left</span> <span class="o">=</span> <span class="n">left</span><span class="o">;</span>
        <span class="k">this</span><span class="o">.</span><span class="na">right</span> <span class="o">=</span> <span class="n">right</span><span class="o">;</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The nodes are immutable, which makes them safe to cache and share across threads. That property becomes important once parsed expressions are reused across requests.</p>

<h3 id="55-parser">5.5. Parser</h3>

<p>The parser implements operator precedence by splitting the grammar into methods. <code class="language-plaintext highlighter-rouge">parseOr</code> handles the lowest-precedence operator, <code class="language-plaintext highlighter-rouge">parseAnd</code> handles the next level, <code class="language-plaintext highlighter-rouge">parseNot</code> handles unary negation, and <code class="language-plaintext highlighter-rouge">parsePrimary</code> handles variables and parentheses.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">java.util.List</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.function.Supplier</span><span class="o">;</span>

<span class="kd">final</span> <span class="kd">class</span> <span class="nc">Parser</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Token</span><span class="o">&gt;</span> <span class="n">tokens</span><span class="o">;</span>
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">String</span> <span class="n">expression</span><span class="o">;</span>
    <span class="kd">private</span> <span class="kt">int</span> <span class="n">pos</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span>

    <span class="nc">Parser</span><span class="o">(</span><span class="nc">List</span><span class="o">&lt;</span><span class="nc">Token</span><span class="o">&gt;</span> <span class="n">tokens</span><span class="o">,</span> <span class="nc">String</span> <span class="n">expression</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">tokens</span> <span class="o">=</span> <span class="n">tokens</span><span class="o">;</span>
        <span class="k">this</span><span class="o">.</span><span class="na">expression</span> <span class="o">=</span> <span class="n">expression</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="nc">Node</span> <span class="nf">parse</span><span class="o">()</span> <span class="o">{</span>
        <span class="nc">Node</span> <span class="n">ast</span> <span class="o">=</span> <span class="n">parseOr</span><span class="o">();</span>
        <span class="n">expect</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">EOF</span><span class="o">);</span>
        <span class="k">return</span> <span class="n">ast</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="nc">Node</span> <span class="nf">parseOr</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="nf">parseBinary</span><span class="o">(</span><span class="k">this</span><span class="o">::</span><span class="n">parseAnd</span><span class="o">,</span> <span class="nc">TokenType</span><span class="o">.</span><span class="na">OR</span><span class="o">);</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="nc">Node</span> <span class="nf">parseAnd</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="nf">parseBinary</span><span class="o">(</span><span class="k">this</span><span class="o">::</span><span class="n">parseNot</span><span class="o">,</span> <span class="nc">TokenType</span><span class="o">.</span><span class="na">AND</span><span class="o">);</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="nc">Node</span> <span class="nf">parseNot</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">match</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">NOT</span><span class="o">))</span> <span class="o">{</span>
            <span class="nc">Token</span> <span class="n">token</span> <span class="o">=</span> <span class="n">current</span><span class="o">();</span>
            <span class="n">advance</span><span class="o">();</span>
            <span class="k">return</span> <span class="k">new</span> <span class="nf">UnaryOpNode</span><span class="o">(</span><span class="n">token</span><span class="o">.</span><span class="na">value</span><span class="o">,</span> <span class="n">parseNot</span><span class="o">());</span>
        <span class="o">}</span>

        <span class="k">return</span> <span class="nf">parsePrimary</span><span class="o">();</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="nc">Node</span> <span class="nf">parsePrimary</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">match</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">VARIABLE</span><span class="o">))</span> <span class="o">{</span>
            <span class="nc">String</span> <span class="n">name</span> <span class="o">=</span> <span class="n">current</span><span class="o">().</span><span class="na">value</span><span class="o">;</span>
            <span class="n">advance</span><span class="o">();</span>
            <span class="k">return</span> <span class="k">new</span> <span class="nf">VariableNode</span><span class="o">(</span><span class="n">name</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">match</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">LPAREN</span><span class="o">))</span> <span class="o">{</span>
            <span class="n">advance</span><span class="o">();</span>
            <span class="nc">Node</span> <span class="n">node</span> <span class="o">=</span> <span class="n">parseOr</span><span class="o">();</span>
            <span class="n">expect</span><span class="o">(</span><span class="nc">TokenType</span><span class="o">.</span><span class="na">RPAREN</span><span class="o">);</span>
            <span class="k">return</span> <span class="n">node</span><span class="o">;</span>
        <span class="o">}</span>

        <span class="nc">Token</span> <span class="n">token</span> <span class="o">=</span> <span class="n">current</span><span class="o">();</span>
        <span class="k">throw</span> <span class="k">new</span> <span class="nf">ExpressionParseException</span><span class="o">(</span>
                <span class="s">"Expected variable or '(' but found "</span> <span class="o">+</span> <span class="n">token</span><span class="o">.</span><span class="na">type</span><span class="o">,</span>
                <span class="n">token</span><span class="o">.</span><span class="na">position</span><span class="o">,</span>
                <span class="n">expression</span>
        <span class="o">);</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="nc">Node</span> <span class="nf">parseBinary</span><span class="o">(</span><span class="nc">Supplier</span><span class="o">&lt;</span><span class="nc">Node</span><span class="o">&gt;</span> <span class="n">nextPrecedence</span><span class="o">,</span> <span class="nc">TokenType</span> <span class="n">operatorType</span><span class="o">)</span> <span class="o">{</span>
        <span class="nc">Node</span> <span class="n">left</span> <span class="o">=</span> <span class="n">nextPrecedence</span><span class="o">.</span><span class="na">get</span><span class="o">();</span>

        <span class="k">while</span> <span class="o">(</span><span class="n">match</span><span class="o">(</span><span class="n">operatorType</span><span class="o">))</span> <span class="o">{</span>
            <span class="nc">String</span> <span class="n">operator</span> <span class="o">=</span> <span class="n">current</span><span class="o">().</span><span class="na">value</span><span class="o">;</span>
            <span class="n">advance</span><span class="o">();</span>

            <span class="nc">Node</span> <span class="n">right</span> <span class="o">=</span> <span class="n">nextPrecedence</span><span class="o">.</span><span class="na">get</span><span class="o">();</span>
            <span class="n">left</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">BinaryOpNode</span><span class="o">(</span><span class="n">operator</span><span class="o">,</span> <span class="n">left</span><span class="o">,</span> <span class="n">right</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="k">return</span> <span class="n">left</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="nc">Token</span> <span class="nf">current</span><span class="o">()</span> <span class="o">{</span>
        <span class="k">return</span> <span class="n">tokens</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">pos</span><span class="o">);</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kt">boolean</span> <span class="nf">match</span><span class="o">(</span><span class="nc">TokenType</span> <span class="n">type</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">return</span> <span class="nf">current</span><span class="o">().</span><span class="na">type</span> <span class="o">==</span> <span class="n">type</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">advance</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">pos</span><span class="o">++;</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">expect</span><span class="o">(</span><span class="nc">TokenType</span> <span class="n">type</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(!</span><span class="n">match</span><span class="o">(</span><span class="n">type</span><span class="o">))</span> <span class="o">{</span>
            <span class="nc">Token</span> <span class="n">token</span> <span class="o">=</span> <span class="n">current</span><span class="o">();</span>

            <span class="k">throw</span> <span class="k">new</span> <span class="nf">ExpressionParseException</span><span class="o">(</span>
                    <span class="s">"Expected "</span> <span class="o">+</span> <span class="n">type</span> <span class="o">+</span> <span class="s">" but found "</span> <span class="o">+</span> <span class="n">token</span><span class="o">.</span><span class="na">type</span><span class="o">,</span>
                    <span class="n">token</span><span class="o">.</span><span class="na">position</span><span class="o">,</span>
                    <span class="n">expression</span>
            <span class="o">);</span>
        <span class="o">}</span>

        <span class="n">advance</span><span class="o">();</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The final <code class="language-plaintext highlighter-rouge">expect(TokenType.EOF)</code> is important. Without it, the parser might accept a valid prefix and ignore trailing junk. For example, <code class="language-plaintext highlighter-rouge">A AND B C</code> should fail, not silently evaluate as <code class="language-plaintext highlighter-rouge">A AND B</code>.</p>

<h3 id="56-evaluator">5.6. Evaluator</h3>

<p>The evaluator walks the AST recursively and reads variable values from the provided map.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">java.util.Map</span><span class="o">;</span>

<span class="kd">final</span> <span class="kd">class</span> <span class="nc">Evaluator</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="nf">Evaluator</span><span class="o">()</span> <span class="o">{</span>
    <span class="o">}</span>

    <span class="kd">static</span> <span class="kt">boolean</span> <span class="nf">evaluateAST</span><span class="o">(</span><span class="nc">Node</span> <span class="n">node</span><span class="o">,</span> <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Boolean</span><span class="o">&gt;</span> <span class="n">values</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">node</span> <span class="k">instanceof</span> <span class="nc">VariableNode</span> <span class="n">variable</span><span class="o">)</span> <span class="o">{</span>
            <span class="nc">Boolean</span> <span class="n">value</span> <span class="o">=</span> <span class="n">values</span><span class="o">.</span><span class="na">get</span><span class="o">(</span><span class="n">variable</span><span class="o">.</span><span class="na">name</span><span class="o">);</span>

            <span class="k">if</span> <span class="o">(</span><span class="n">value</span> <span class="o">==</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span>
                <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Undefined variable: "</span> <span class="o">+</span> <span class="n">variable</span><span class="o">.</span><span class="na">name</span><span class="o">);</span>
            <span class="o">}</span>

            <span class="k">return</span> <span class="n">value</span><span class="o">;</span>
        <span class="o">}</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">node</span> <span class="k">instanceof</span> <span class="nc">UnaryOpNode</span> <span class="n">unary</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">if</span> <span class="o">(</span><span class="s">"NOT"</span><span class="o">.</span><span class="na">equals</span><span class="o">(</span><span class="n">unary</span><span class="o">.</span><span class="na">operator</span><span class="o">))</span> <span class="o">{</span>
                <span class="k">return</span> <span class="o">!</span><span class="n">evaluateAST</span><span class="o">(</span><span class="n">unary</span><span class="o">.</span><span class="na">operand</span><span class="o">,</span> <span class="n">values</span><span class="o">);</span>
            <span class="o">}</span>

            <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Unknown unary operator: "</span> <span class="o">+</span> <span class="n">unary</span><span class="o">.</span><span class="na">operator</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">node</span> <span class="k">instanceof</span> <span class="nc">BinaryOpNode</span> <span class="n">binary</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">return</span> <span class="nf">switch</span> <span class="o">(</span><span class="n">binary</span><span class="o">.</span><span class="na">operator</span><span class="o">)</span> <span class="o">{</span>
                <span class="k">case</span> <span class="s">"AND"</span> <span class="o">-&gt;</span> <span class="n">evaluateAST</span><span class="o">(</span><span class="n">binary</span><span class="o">.</span><span class="na">left</span><span class="o">,</span> <span class="n">values</span><span class="o">)</span>
                        <span class="o">&amp;&amp;</span> <span class="n">evaluateAST</span><span class="o">(</span><span class="n">binary</span><span class="o">.</span><span class="na">right</span><span class="o">,</span> <span class="n">values</span><span class="o">);</span>

                <span class="k">case</span> <span class="s">"OR"</span> <span class="o">-&gt;</span> <span class="n">evaluateAST</span><span class="o">(</span><span class="n">binary</span><span class="o">.</span><span class="na">left</span><span class="o">,</span> <span class="n">values</span><span class="o">)</span>
                        <span class="o">||</span> <span class="n">evaluateAST</span><span class="o">(</span><span class="n">binary</span><span class="o">.</span><span class="na">right</span><span class="o">,</span> <span class="n">values</span><span class="o">);</span>

                <span class="k">default</span> <span class="o">-&gt;</span> <span class="k">throw</span> <span class="k">new</span> <span class="nc">IllegalArgumentException</span><span class="o">(</span>
                        <span class="s">"Unknown binary operator: "</span> <span class="o">+</span> <span class="n">binary</span><span class="o">.</span><span class="na">operator</span>
                <span class="o">);</span>
            <span class="o">};</span>
        <span class="o">}</span>

        <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Unknown AST node: "</span> <span class="o">+</span> <span class="n">node</span><span class="o">.</span><span class="na">getClass</span><span class="o">().</span><span class="na">getName</span><span class="o">());</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The placement of the recursive calls matters. This implementation short-circuits correctly because the right-hand side is evaluated inside Java’s <code class="language-plaintext highlighter-rouge">&amp;&amp;</code> or <code class="language-plaintext highlighter-rouge">||</code> expression.</p>

<p>This means:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>false AND missingVariable -&gt; false
true OR missingVariable   -&gt; true
</code></pre></div></div>

<p>The evaluator does not read <code class="language-plaintext highlighter-rouge">missingVariable</code> in either case. If the code first evaluated both sides into local variables, short-circuiting would be lost, and these expressions would throw.</p>

<p>Whether this behavior is desirable depends on the system. Java developers usually expect short-circuit semantics, but a rule-management platform should still validate all referenced variables when a rule is created. That catches bad expressions before they enter production traffic.</p>

<h3 id="57-public-api">5.7. Public API</h3>

<p>The public API combines tokenization, parsing, and evaluation.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">java.util.List</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.Map</span><span class="o">;</span>

<span class="kd">public</span> <span class="kd">final</span> <span class="kd">class</span> <span class="nc">BooleanEvaluator</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="nf">BooleanEvaluator</span><span class="o">()</span> <span class="o">{</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kd">static</span> <span class="kt">boolean</span> <span class="nf">evaluate</span><span class="o">(</span><span class="nc">String</span> <span class="n">expression</span><span class="o">,</span> <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Boolean</span><span class="o">&gt;</span> <span class="n">values</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">values</span> <span class="o">==</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Values map must not be null"</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Token</span><span class="o">&gt;</span> <span class="n">tokens</span> <span class="o">=</span> <span class="nc">Tokenizer</span><span class="o">.</span><span class="na">tokenize</span><span class="o">(</span><span class="n">expression</span><span class="o">);</span>
        <span class="nc">Node</span> <span class="n">ast</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">Parser</span><span class="o">(</span><span class="n">tokens</span><span class="o">,</span> <span class="n">expression</span><span class="o">).</span><span class="na">parse</span><span class="o">();</span>

        <span class="k">return</span> <span class="nc">Evaluator</span><span class="o">.</span><span class="na">evaluateAST</span><span class="o">(</span><span class="n">ast</span><span class="o">,</span> <span class="n">values</span><span class="o">);</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kd">static</span> <span class="kt">void</span> <span class="nf">main</span><span class="o">(</span><span class="nc">String</span><span class="o">[]</span> <span class="n">args</span><span class="o">)</span> <span class="o">{</span>
        <span class="nc">String</span> <span class="n">expression</span> <span class="o">=</span> <span class="s">"NOT (A AND B) OR C"</span><span class="o">;</span>

        <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Boolean</span><span class="o">&gt;</span> <span class="n">values</span> <span class="o">=</span> <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span>
                <span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span>
                <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span>
                <span class="s">"C"</span><span class="o">,</span> <span class="kc">false</span>
        <span class="o">);</span>

        <span class="kt">boolean</span> <span class="n">result</span> <span class="o">=</span> <span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span><span class="n">expression</span><span class="o">,</span> <span class="n">values</span><span class="o">);</span>
        <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="n">result</span><span class="o">);</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>For <code class="language-plaintext highlighter-rouge">NOT (A AND B) OR C</code>, the result is <code class="language-plaintext highlighter-rouge">true</code> when <code class="language-plaintext highlighter-rouge">A = true</code>, <code class="language-plaintext highlighter-rouge">B = false</code>, and <code class="language-plaintext highlighter-rouge">C = false</code>.</p>

<h2 id="6-testing">6. Testing</h2>

<p>The tests should cover operator behavior, precedence, parentheses, malformed expressions, undefined variables, and short-circuit behavior. The short-circuit tests are worth keeping because they prevent a common refactor bug.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">org.junit.jupiter.api.Test</span><span class="o">;</span>

<span class="kn">import</span> <span class="nn">java.util.Map</span><span class="o">;</span>

<span class="kn">import</span> <span class="nn">static</span> <span class="n">org</span><span class="o">.</span><span class="na">junit</span><span class="o">.</span><span class="na">jupiter</span><span class="o">.</span><span class="na">api</span><span class="o">.</span><span class="na">Assertions</span><span class="o">.*;</span>

<span class="kd">class</span> <span class="nc">BooleanEvaluatorTest</span> <span class="o">{</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">evaluatesAnd</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">assertTrue</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A AND B"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">true</span><span class="o">)</span>
        <span class="o">));</span>

        <span class="n">assertFalse</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A AND B"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">evaluatesOr</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">assertTrue</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A OR B"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">true</span><span class="o">)</span>
        <span class="o">));</span>

        <span class="n">assertFalse</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A OR B"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">evaluatesNot</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">assertTrue</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"NOT A"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">false</span><span class="o">)</span>
        <span class="o">));</span>

        <span class="n">assertFalse</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"NOT A"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">respectsPrecedence</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">assertTrue</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A OR B AND C"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="s">"C"</span><span class="o">,</span> <span class="kc">false</span><span class="o">)</span>
        <span class="o">));</span>

        <span class="n">assertFalse</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A AND B OR C"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="s">"C"</span><span class="o">,</span> <span class="kc">false</span><span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">respectsParentheses</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">assertFalse</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A AND (B OR C)"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="s">"C"</span><span class="o">,</span> <span class="kc">false</span><span class="o">)</span>
        <span class="o">));</span>

        <span class="n">assertTrue</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"(A AND B) OR C"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="s">"C"</span><span class="o">,</span> <span class="kc">true</span><span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">evaluatesNestedExpression</span><span class="o">()</span> <span class="o">{</span>
        <span class="nc">String</span> <span class="n">expression</span> <span class="o">=</span> <span class="s">"(A AND (NOT B)) OR (C AND (NOT (D OR E)))"</span><span class="o">;</span>

        <span class="n">assertTrue</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="n">expression</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span>
                        <span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span>
                        <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span>
                        <span class="s">"C"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span>
                        <span class="s">"D"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span>
                        <span class="s">"E"</span><span class="o">,</span> <span class="kc">false</span>
                <span class="o">)</span>
        <span class="o">));</span>

        <span class="n">assertFalse</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="n">expression</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span>
                        <span class="s">"A"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span>
                        <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span>
                        <span class="s">"C"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span>
                        <span class="s">"D"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span>
                        <span class="s">"E"</span><span class="o">,</span> <span class="kc">false</span>
                <span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">shortCircuitsAnd</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">assertFalse</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A AND missing"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">false</span><span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">shortCircuitsOr</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">assertTrue</span><span class="o">(</span><span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                <span class="s">"A OR missing"</span><span class="o">,</span>
                <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">)</span>
        <span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">throwsForUndefinedVariableWhenEvaluated</span><span class="o">()</span> <span class="o">{</span>
        <span class="nc">IllegalArgumentException</span> <span class="n">exception</span> <span class="o">=</span> <span class="n">assertThrows</span><span class="o">(</span>
                <span class="nc">IllegalArgumentException</span><span class="o">.</span><span class="na">class</span><span class="o">,</span>
                <span class="o">()</span> <span class="o">-&gt;</span> <span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span><span class="s">"A AND B"</span><span class="o">,</span> <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">))</span>
        <span class="o">);</span>

        <span class="n">assertTrue</span><span class="o">(</span><span class="n">exception</span><span class="o">.</span><span class="na">getMessage</span><span class="o">().</span><span class="na">contains</span><span class="o">(</span><span class="s">"Undefined variable: B"</span><span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">throwsForInvalidCharacter</span><span class="o">()</span> <span class="o">{</span>
        <span class="nc">ExpressionParseException</span> <span class="n">exception</span> <span class="o">=</span> <span class="n">assertThrows</span><span class="o">(</span>
                <span class="nc">ExpressionParseException</span><span class="o">.</span><span class="na">class</span><span class="o">,</span>
                <span class="o">()</span> <span class="o">-&gt;</span> <span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span><span class="s">"A &amp; B"</span><span class="o">,</span> <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">))</span>
        <span class="o">);</span>

        <span class="n">assertTrue</span><span class="o">(</span><span class="n">exception</span><span class="o">.</span><span class="na">getMessage</span><span class="o">().</span><span class="na">contains</span><span class="o">(</span><span class="s">"Unexpected character"</span><span class="o">));</span>
    <span class="o">}</span>

    <span class="nd">@Test</span>
    <span class="kt">void</span> <span class="nf">throwsForUnclosedParenthesis</span><span class="o">()</span> <span class="o">{</span>
        <span class="nc">ExpressionParseException</span> <span class="n">exception</span> <span class="o">=</span> <span class="n">assertThrows</span><span class="o">(</span>
                <span class="nc">ExpressionParseException</span><span class="o">.</span><span class="na">class</span><span class="o">,</span>
                <span class="o">()</span> <span class="o">-&gt;</span> <span class="nc">BooleanEvaluator</span><span class="o">.</span><span class="na">evaluate</span><span class="o">(</span>
                        <span class="s">"A AND (B OR C"</span><span class="o">,</span>
                        <span class="nc">Map</span><span class="o">.</span><span class="na">of</span><span class="o">(</span><span class="s">"A"</span><span class="o">,</span> <span class="kc">true</span><span class="o">,</span> <span class="s">"B"</span><span class="o">,</span> <span class="kc">false</span><span class="o">,</span> <span class="s">"C"</span><span class="o">,</span> <span class="kc">true</span><span class="o">)</span>
                <span class="o">)</span>
        <span class="o">);</span>

        <span class="n">assertTrue</span><span class="o">(</span><span class="n">exception</span><span class="o">.</span><span class="na">getMessage</span><span class="o">().</span><span class="na">contains</span><span class="o">(</span><span class="s">"Expected RPAREN"</span><span class="o">));</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>These tests are not exhaustive, but they cover the areas most likely to break during maintenance. If this evaluator becomes part of a critical path, add randomized tests that generate expression trees, render them into strings, parse them back, and compare parsed evaluation against direct tree evaluation.</p>

<h2 id="7-performance">7. Performance</h2>

<p>The evaluator has predictable complexity.</p>

<table>
  <thead>
    <tr>
      <th>Stage</th>
      <th style="text-align: right">Complexity</th>
      <th>Notes</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Tokenization</td>
      <td style="text-align: right"><code class="language-plaintext highlighter-rouge">O(n)</code></td>
      <td>Scans each character once</td>
    </tr>
    <tr>
      <td>Parsing</td>
      <td style="text-align: right"><code class="language-plaintext highlighter-rouge">O(t)</code></td>
      <td>Consumes each token once</td>
    </tr>
    <tr>
      <td>Evaluation</td>
      <td style="text-align: right"><code class="language-plaintext highlighter-rouge">O(k)</code></td>
      <td>Visits evaluated AST nodes</td>
    </tr>
    <tr>
      <td>Cached evaluation</td>
      <td style="text-align: right"><code class="language-plaintext highlighter-rouge">O(k)</code></td>
      <td>Skips tokenization and parsing</td>
    </tr>
  </tbody>
</table>

<p>For typical business expressions, parsing usually costs more than evaluation. Evaluation is just a tree walk plus map lookups, and with short-circuiting it may visit only part of the tree.</p>

<p>If the same expression runs many times, cache the parsed AST.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">java.util.List</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.Map</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.concurrent.ConcurrentHashMap</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.concurrent.ConcurrentMap</span><span class="o">;</span>

<span class="kd">public</span> <span class="kd">final</span> <span class="kd">class</span> <span class="nc">CachedBooleanEvaluator</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="kd">final</span> <span class="nc">ConcurrentMap</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Node</span><span class="o">&gt;</span> <span class="n">astCache</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ConcurrentHashMap</span><span class="o">&lt;&gt;();</span>

    <span class="kd">public</span> <span class="kt">boolean</span> <span class="nf">evaluate</span><span class="o">(</span><span class="nc">String</span> <span class="n">expression</span><span class="o">,</span> <span class="nc">Map</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">,</span> <span class="nc">Boolean</span><span class="o">&gt;</span> <span class="n">values</span><span class="o">)</span> <span class="o">{</span>
        <span class="nc">Node</span> <span class="n">ast</span> <span class="o">=</span> <span class="n">astCache</span><span class="o">.</span><span class="na">computeIfAbsent</span><span class="o">(</span><span class="n">expression</span><span class="o">,</span> <span class="k">this</span><span class="o">::</span><span class="n">parse</span><span class="o">);</span>
        <span class="k">return</span> <span class="nc">Evaluator</span><span class="o">.</span><span class="na">evaluateAST</span><span class="o">(</span><span class="n">ast</span><span class="o">,</span> <span class="n">values</span><span class="o">);</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="nc">Node</span> <span class="nf">parse</span><span class="o">(</span><span class="nc">String</span> <span class="n">expression</span><span class="o">)</span> <span class="o">{</span>
        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Token</span><span class="o">&gt;</span> <span class="n">tokens</span> <span class="o">=</span> <span class="nc">Tokenizer</span><span class="o">.</span><span class="na">tokenize</span><span class="o">(</span><span class="n">expression</span><span class="o">);</span>
        <span class="k">return</span> <span class="k">new</span> <span class="nf">Parser</span><span class="o">(</span><span class="n">tokens</span><span class="o">,</span> <span class="n">expression</span><span class="o">).</span><span class="na">parse</span><span class="o">();</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>A raw <code class="language-plaintext highlighter-rouge">ConcurrentHashMap</code> is fine for a demo, but it is not enough for production. If expressions can be created dynamically, an unbounded cache can become a memory leak. Use a bounded cache, record hit rate and eviction count, and validate expressions before they reach the hot path.</p>

<p>Context construction can also dominate runtime. If building the map requires database calls, remote service calls, or expensive computation, optimizing the AST traversal will not fix latency. In that case, either precompute facts upstream or consider lazy variables through <code class="language-plaintext highlighter-rouge">Supplier&lt;Boolean&gt;</code>, with care around timeouts, retries, and side effects.</p>

<h2 id="8-production-guardrails">8. Production Guardrails</h2>

<p>A runtime expression evaluator should reject bad rules before they affect requests. The validator should enforce size limits, syntax validity, allowed variables, and any domain-specific restrictions.</p>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">java.util.List</span><span class="o">;</span>
<span class="kn">import</span> <span class="nn">java.util.Set</span><span class="o">;</span>

<span class="kd">public</span> <span class="kd">final</span> <span class="kd">class</span> <span class="nc">RuleValidator</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">int</span> <span class="no">MAX_EXPRESSION_LENGTH</span> <span class="o">=</span> <span class="mi">1_000</span><span class="o">;</span>
    <span class="kd">private</span> <span class="kd">static</span> <span class="kd">final</span> <span class="kt">int</span> <span class="no">MAX_TOKEN_COUNT</span> <span class="o">=</span> <span class="mi">200</span><span class="o">;</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">validate</span><span class="o">(</span><span class="nc">String</span> <span class="n">expression</span><span class="o">,</span> <span class="nc">Set</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">&gt;</span> <span class="n">allowedVariables</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">expression</span> <span class="o">==</span> <span class="kc">null</span> <span class="o">||</span> <span class="n">expression</span><span class="o">.</span><span class="na">isBlank</span><span class="o">())</span> <span class="o">{</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Expression must not be blank"</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">expression</span><span class="o">.</span><span class="na">length</span><span class="o">()</span> <span class="o">&gt;</span> <span class="no">MAX_EXPRESSION_LENGTH</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Expression is too long"</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Token</span><span class="o">&gt;</span> <span class="n">tokens</span> <span class="o">=</span> <span class="nc">Tokenizer</span><span class="o">.</span><span class="na">tokenize</span><span class="o">(</span><span class="n">expression</span><span class="o">);</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">tokens</span><span class="o">.</span><span class="na">size</span><span class="o">()</span> <span class="o">&gt;</span> <span class="no">MAX_TOKEN_COUNT</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Expression has too many tokens"</span><span class="o">);</span>
        <span class="o">}</span>

        <span class="nc">Node</span> <span class="n">ast</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">Parser</span><span class="o">(</span><span class="n">tokens</span><span class="o">,</span> <span class="n">expression</span><span class="o">).</span><span class="na">parse</span><span class="o">();</span>
        <span class="n">validateVariables</span><span class="o">(</span><span class="n">ast</span><span class="o">,</span> <span class="n">allowedVariables</span><span class="o">);</span>
    <span class="o">}</span>

    <span class="kd">private</span> <span class="kt">void</span> <span class="nf">validateVariables</span><span class="o">(</span><span class="nc">Node</span> <span class="n">node</span><span class="o">,</span> <span class="nc">Set</span><span class="o">&lt;</span><span class="nc">String</span><span class="o">&gt;</span> <span class="n">allowedVariables</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">if</span> <span class="o">(</span><span class="n">node</span> <span class="k">instanceof</span> <span class="nc">VariableNode</span> <span class="n">variable</span><span class="o">)</span> <span class="o">{</span>
            <span class="k">if</span> <span class="o">(!</span><span class="n">allowedVariables</span><span class="o">.</span><span class="na">contains</span><span class="o">(</span><span class="n">variable</span><span class="o">.</span><span class="na">name</span><span class="o">))</span> <span class="o">{</span>
                <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Variable is not allowed: "</span> <span class="o">+</span> <span class="n">variable</span><span class="o">.</span><span class="na">name</span><span class="o">);</span>
            <span class="o">}</span>

            <span class="k">return</span><span class="o">;</span>
        <span class="o">}</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">node</span> <span class="k">instanceof</span> <span class="nc">UnaryOpNode</span> <span class="n">unary</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">validateVariables</span><span class="o">(</span><span class="n">unary</span><span class="o">.</span><span class="na">operand</span><span class="o">,</span> <span class="n">allowedVariables</span><span class="o">);</span>
            <span class="k">return</span><span class="o">;</span>
        <span class="o">}</span>

        <span class="k">if</span> <span class="o">(</span><span class="n">node</span> <span class="k">instanceof</span> <span class="nc">BinaryOpNode</span> <span class="n">binary</span><span class="o">)</span> <span class="o">{</span>
            <span class="n">validateVariables</span><span class="o">(</span><span class="n">binary</span><span class="o">.</span><span class="na">left</span><span class="o">,</span> <span class="n">allowedVariables</span><span class="o">);</span>
            <span class="n">validateVariables</span><span class="o">(</span><span class="n">binary</span><span class="o">.</span><span class="na">right</span><span class="o">,</span> <span class="n">allowedVariables</span><span class="o">);</span>
            <span class="k">return</span><span class="o">;</span>
        <span class="o">}</span>

        <span class="k">throw</span> <span class="k">new</span> <span class="nf">IllegalArgumentException</span><span class="o">(</span><span class="s">"Unknown AST node: "</span> <span class="o">+</span> <span class="n">node</span><span class="o">.</span><span class="na">getClass</span><span class="o">().</span><span class="na">getName</span><span class="o">());</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<p>The production concerns are mostly operational rather than algorithmic:</p>

<ul>
  <li>reject expressions that are too long or too deeply nested</li>
  <li>validate variable names against a rule-specific catalog</li>
  <li>store rule versions instead of mutating rules in place</li>
  <li>support rollback to the previous active version</li>
  <li>log rule ID, version, result, and correlation ID</li>
  <li>record evaluation latency, validation failures, and cache behavior</li>
  <li>test new rules against historical samples before activation</li>
</ul>

<p>For high-impact decisions, evaluate candidate rules in shadow mode before serving them. The active rule still controls the response, while the candidate rule runs in parallel and emits disagreement metrics. This catches accidental broadening or narrowing before a bad policy starts rejecting users, changing prices, or granting access.</p>

<h2 id="9-extending-the-language">9. Extending the Language</h2>

<p>The first common extension is comparison syntax.</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>age &gt;= 18 AND region == "US"
</code></pre></div></div>

<p>That looks small, but it changes the evaluator substantially. The tokenizer must support numbers, strings, and multi-character operators. The parser needs additional precedence levels. The evaluator needs typed values, not only Booleans. Error handling must distinguish syntax errors from type errors.</p>

<p>A larger grammar might look like this:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>expression    := orExpression
orExpression  := andExpression ("OR" andExpression)*
andExpression := notExpression ("AND" notExpression)*
notExpression := "NOT" notExpression | comparison
comparison    := value (("&gt;" | "&gt;=" | "&lt;" | "&lt;=" | "==" | "!=") value)?
value         := VARIABLE | NUMBER | STRING | "(" expression ")"
</code></pre></div></div>

<p>At that point, the implementation is becoming a small interpreter. That can still be the right path, especially when the domain requires a constrained language, but it should trigger a build-versus-adopt discussion. Mature expression languages already handle typed values, functions, better diagnostics, and optimization, although they also bring their own security and integration risks.</p>

<h2 id="10-when-to-use-this-pattern">10. When to Use This Pattern</h2>

<p>Use normal Java when the rule is simple, stable, and owned by engineers. Hardcoded logic gives strong tooling, compile-time feedback, and predictable performance.</p>

<p>Use a Boolean expression evaluator when the rule is complex enough to need configuration, when tenants need different policies, when rules must be audited, or when the organization needs to change policy faster than the application deployment cycle. The evaluator adds parsing and validation complexity, but it localizes that complexity in one component instead of spreading rule variants across the codebase.</p>

<p>The main design principle is to keep the language small for as long as possible. A Boolean evaluator with well-defined variables is easy to secure and reason about. A general-purpose scripting system embedded in a request path is much harder to operate safely.</p>

<h2 id="11-key-takeaways">11. Key Takeaways</h2>

<p>A Boolean expression evaluator is a focused interpreter. The tokenizer converts text into tokens, the parser builds an AST, and the evaluator computes a result from request-specific values.</p>

<p>The important implementation details are practical:</p>

<ul>
  <li>parse the entire expression, including the EOF marker</li>
  <li>preserve positions for useful error messages</li>
  <li>make operator precedence explicit in the parser</li>
  <li>keep AST nodes immutable if they are cached</li>
  <li>implement short-circuiting by evaluating the right side only inside <code class="language-plaintext highlighter-rouge">&amp;&amp;</code> or <code class="language-plaintext highlighter-rouge">||</code></li>
  <li>validate allowed variables before activating a rule</li>
  <li>bound caches and expression size in production</li>
</ul>

<p>This pattern does not remove business-rule complexity. It moves that complexity into a smaller, testable, observable layer where rule changes can be treated as data changes rather than application releases.</p>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Java" /><category term="Software Development" /><category term="Best Practices" /><summary type="html"><![CDATA[Business rules often start as simple if statements. That is usually fine, because hardcoded logic is fast, easy to debug, and checked by the compiler. The problem starts when the rule changes more often than the codebase, or when different customers, cohorts, regions, or experiments need different versions of the same decision logic.]]></summary></entry><entry><title type="html">Java Concurrency 101</title><link href="https://hoangtl.site/posts/java-concurrency-101/" rel="alternate" type="text/html" title="Java Concurrency 101" /><published>2025-03-20T00:00:00+00:00</published><updated>2025-03-20T00:00:00+00:00</updated><id>https://hoangtl.site/posts/JavaConcurrency</id><content type="html" xml:base="https://hoangtl.site/posts/java-concurrency-101/"><![CDATA[<p>This article provides understanding of Java Concurrency concepts, including threads, ExecutorService, synchronization, concurrent collections, threading problems, locks, conditions, semaphores, volatile variables, happens-before relationships, and barrier synchronization.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#1-introducing-threads" id="markdown-toc-1-introducing-threads">1. Introducing threads</a>    <ul>
      <li><a href="#some-definitions" id="markdown-toc-some-definitions">Some definitions</a></li>
      <li><a href="#thread-concurrency" id="markdown-toc-thread-concurrency">Thread concurrency</a></li>
    </ul>
  </li>
  <li><a href="#2-executorservice" id="markdown-toc-2-executorservice">2. ExecutorService</a>    <ul>
      <li><a href="#executorservice-life-cycle" id="markdown-toc-executorservice-life-cycle">ExecutorService life cycle</a></li>
      <li><a href="#executorservice-methods" id="markdown-toc-executorservice-methods">ExecutorService methods</a></li>
    </ul>
  </li>
  <li><a href="#3-synchronize-data-access" id="markdown-toc-3-synchronize-data-access">3. Synchronize Data access</a>    <ul>
      <li><a href="#atomic-classes" id="markdown-toc-atomic-classes">Atomic Classes</a></li>
      <li><a href="#synchronize-blocks" id="markdown-toc-synchronize-blocks">Synchronize blocks</a></li>
    </ul>
  </li>
  <li><a href="#4-concurrent-collections" id="markdown-toc-4-concurrent-collections">4. Concurrent collections</a>    <ul>
      <li><a href="#concurrenthashmap" id="markdown-toc-concurrenthashmap">ConcurrentHashMap</a></li>
      <li><a href="#collectionssynchronizedmap" id="markdown-toc-collectionssynchronizedmap">Collections.synchronizedMap()</a></li>
      <li><a href="#java-blocking-queue" id="markdown-toc-java-blocking-queue">Java Blocking Queue</a></li>
    </ul>
  </li>
  <li><a href="#5-threading-problems" id="markdown-toc-5-threading-problems">5. Threading problems</a>    <ul>
      <li><a href="#liveness" id="markdown-toc-liveness">Liveness</a></li>
    </ul>
  </li>
  <li><a href="#6-lock-framework" id="markdown-toc-6-lock-framework">6. Lock framework</a>    <ul>
      <li><a href="#trylocklong-time-timeunit-unit" id="markdown-toc-trylocklong-time-timeunit-unit">tryLock(long time, TimeUnit unit)</a></li>
      <li><a href="#reentrantlock" id="markdown-toc-reentrantlock">ReentrantLock()</a></li>
      <li><a href="#fair-lock-management" id="markdown-toc-fair-lock-management">Fair Lock Management</a></li>
      <li><a href="#readwrite-locks" id="markdown-toc-readwrite-locks">Read/Write Locks</a></li>
      <li><a href="#reentrantreadwritelock" id="markdown-toc-reentrantreadwritelock">ReentrantReadWriteLock</a></li>
      <li><a href="#stampedlock" id="markdown-toc-stampedlock">StampedLock</a></li>
    </ul>
  </li>
  <li><a href="#7-condition-interface" id="markdown-toc-7-condition-interface">7. Condition interface</a>    <ul>
      <li><a href="#conditionawait" id="markdown-toc-conditionawait">Condition.await()</a></li>
      <li><a href="#conditionsignal" id="markdown-toc-conditionsignal">Condition.signal()</a></li>
    </ul>
  </li>
  <li><a href="#8-semaphore" id="markdown-toc-8-semaphore">8. Semaphore</a>    <ul>
      <li><a href="#semaphore-types" id="markdown-toc-semaphore-types">Semaphore types</a></li>
      <li><a href="#java-semaphore" id="markdown-toc-java-semaphore">Java Semaphore</a></li>
      <li><a href="#binary-semaphore-vs-reentrant-lock-mutex" id="markdown-toc-binary-semaphore-vs-reentrant-lock-mutex">Binary Semaphore vs Reentrant Lock (mutex)</a></li>
    </ul>
  </li>
  <li><a href="#9-java-volatile-variables" id="markdown-toc-9-java-volatile-variables">9. Java Volatile Variables</a>    <ul>
      <li><a href="#piggybacking--volatile-variable-rule" id="markdown-toc-piggybacking--volatile-variable-rule">Piggybacking / volatile variable rule</a></li>
    </ul>
  </li>
  <li><a href="#10-java-happens-before-relationships" id="markdown-toc-10-java-happens-before-relationships">10. Java “Happens-Before” Relationships</a></li>
  <li><a href="#11-java-barrier-synchronization" id="markdown-toc-11-java-barrier-synchronization">11. Java Barrier Synchronization</a>    <ul>
      <li><a href="#introduction" id="markdown-toc-introduction">Introduction</a></li>
      <li><a href="#countdownlatch" id="markdown-toc-countdownlatch">CountDownLatch</a></li>
      <li><a href="#cyclicbarrier" id="markdown-toc-cyclicbarrier">CyclicBarrier</a></li>
      <li><a href="#phaser" id="markdown-toc-phaser">Phaser</a></li>
    </ul>
  </li>
  <li><a href="#references" id="markdown-toc-references">References</a></li>
</ul>

  </nav>
</aside>

<h2 id="1-introducing-threads">1. Introducing threads</h2>

<h3 id="some-definitions">Some definitions</h3>

<p><img src="/images/blogs/javaconcurrency/thread_process.jpg" alt="thread_process" /></p>

<ul>
  <li>A thread is the <strong>smallest unit of execution</strong> that can be scheduled by the operating system.</li>
  <li>A process = group of threads that execute in the same, shared environment.</li>
  <li>
    <p>Threads in the same process share the same memory space and can communicate directly with one another.</p>
  </li>
  <li>A <strong>system thread</strong> is created by the JVM and runs in the background of the application. ex: GC thread</li>
  <li>A <strong>user-defined thread</strong> is one created by the application to accomplish a specific task.</li>
  <li>A <strong>daemon thread</strong> are designed for tasks that run in the background and don’t prevent the JVM from exiting. ex: GC thread</li>
</ul>

<h3 id="thread-concurrency">Thread concurrency</h3>

<ul>
  <li>Operating systems use a <strong>thread scheduler</strong> to determine which threads should be currently executing. ex: round-robin scheduler
    <ul>
      <li>If there are 10 available threads, they might each get 100 milliseconds in which to execute.</li>
      <li>When a thread’s allotted time is complete but the thread has not finished processing, a context switch occurs</li>
      <li>Thread can have priority</li>
    </ul>
  </li>
</ul>

<h2 id="2-executorservice">2. ExecutorService</h2>

<ul>
  <li>Obtain <code class="language-plaintext highlighter-rouge">ExecutorService</code> instance and send tasks to be processed</li>
</ul>

<p><strong>Single-thread executor:</strong></p>

<ul>
  <li>Results are guaranteed to be executed in the order in which they are added to the executor service</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="nc">ExecutorService</span> <span class="n">service</span> <span class="o">=</span> <span class="kc">null</span><span class="o">;</span>
	<span class="k">try</span> <span class="o">{</span>
		<span class="n">service</span> <span class="o">=</span> <span class="nc">Executors</span><span class="o">.</span><span class="na">newSingleThreadExecutor</span><span class="o">();</span>
		<span class="n">service</span><span class="o">.</span><span class="na">execute</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"Printing zoo inventory"</span><span class="o">));</span>
	<span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
		<span class="k">if</span><span class="o">(</span><span class="n">service</span> <span class="o">!=</span> <span class="kc">null</span><span class="o">)</span> <span class="n">service</span><span class="o">.</span><span class="na">shutdown</span><span class="o">();</span>
	<span class="o">}</span>
</code></pre></div></div>

<h3 id="executorservice-life-cycle">ExecutorService life cycle</h3>

<p><img src="/images/blogs/javaconcurrency/executorservice_lifecycle.png" alt="life cycle" /></p>

<ul>
  <li>Note:
    <ul>
      <li><code class="language-plaintext highlighter-rouge">shutdown()</code> not actually stop any tasks having already been submitted</li>
      <li><code class="language-plaintext highlighter-rouge">shutdownNow()</code> <strong>attempts</strong> to stop all running tasks -&gt; return <code class="language-plaintext highlighter-rouge">List&lt;Runnable&gt;</code> of tasks were not started by the executor</li>
    </ul>
  </li>
</ul>

<h3 id="executorservice-methods">ExecutorService methods</h3>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="kt">void</span> <span class="nf">execute</span><span class="o">(</span><span class="nc">Runnable</span> <span class="n">command</span><span class="o">)</span>
	<span class="nc">Future</span><span class="o">&lt;?&gt;</span> <span class="n">submit</span><span class="o">(</span><span class="nc">Runnable</span> <span class="n">task</span><span class="o">)</span>
	<span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;</span> <span class="nc">Future</span><span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;</span> <span class="nf">submit</span><span class="o">(</span><span class="nc">Callable</span><span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;</span> <span class="n">task</span><span class="o">)</span>
	<span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;</span> <span class="nc">List</span><span class="o">&lt;</span><span class="nc">Future</span><span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;&gt;</span> <span class="nf">invokeAll</span><span class="o">(</span><span class="nc">Collection</span><span class="o">&lt;?</span> <span class="kd">extends</span> <span class="nc">Callable</span><span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;&gt;</span> <span class="n">tasks</span><span class="o">)</span>
	<span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;</span> <span class="no">T</span> <span class="nf">invokeAny</span><span class="o">(</span><span class="nc">Collection</span><span class="o">&lt;?</span> <span class="kd">extends</span> <span class="nc">Callable</span><span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;&gt;</span> <span class="n">tasks</span><span class="o">)</span>
</code></pre></div></div>

<ul>
  <li><strong>invokeAll()</strong> method will wait indefinitely until all tasks are complete, while the <strong>invokeAny()</strong> method will wait indefinitely until at least one task completes.</li>
</ul>

<p><strong>Waiting for all tasks to finish</strong></p>

<ul>
  <li>First shut down the thread executor using the <code class="language-plaintext highlighter-rouge">shutdown()</code> method.</li>
  <li>Then <code class="language-plaintext highlighter-rouge">awaitTermination()</code> to waits the specified time to complete all tasks</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="nc">ExecutorService</span> <span class="n">service</span> <span class="o">=</span> <span class="kc">null</span><span class="o">;</span>
	<span class="k">try</span> <span class="o">{</span>
		<span class="n">service</span> <span class="o">=</span> <span class="nc">Executors</span><span class="o">.</span><span class="na">newSingleThreadExecutor</span><span class="o">();</span>
		<span class="c1">// Add tasks to the thread executor</span>
		<span class="o">...</span>
	<span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
		<span class="k">if</span><span class="o">(</span><span class="n">service</span> <span class="o">!=</span> <span class="kc">null</span><span class="o">)</span> <span class="n">service</span><span class="o">.</span><span class="na">shutdown</span><span class="o">();</span>
	<span class="o">}</span>

	<span class="k">if</span><span class="o">(</span><span class="n">service</span> <span class="o">!=</span> <span class="kc">null</span><span class="o">)</span> <span class="o">{</span>
		<span class="n">service</span><span class="o">.</span><span class="na">awaitTermination</span><span class="o">(</span><span class="mi">1</span><span class="o">,</span> <span class="nc">TimeUnit</span><span class="o">.</span><span class="na">MINUTES</span><span class="o">);</span>
		<span class="c1">// Check whether all tasks are finished</span>

		<span class="k">if</span> <span class="o">(</span><span class="n">service</span><span class="o">.</span><span class="na">isTerminated</span><span class="o">())</span>
			<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"All tasks finished"</span><span class="o">);</span>
		<span class="k">else</span>
			<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"At least one task is still running"</span><span class="o">);</span>
	<span class="o">}</span>
</code></pre></div></div>

<h2 id="3-synchronize-data-access">3. Synchronize Data access</h2>

<ul>
  <li>Synchronization is about <code class="language-plaintext highlighter-rouge">protecting data consistency</code> at the cost of performance</li>
</ul>

<h3 id="atomic-classes">Atomic Classes</h3>

<ul>
  <li>Perform the read and write of the variable as a single operation, not allowing any other threads to access the variable during the operation.</li>
  <li>Any thread trying to access the variable while an atomic operation is in process <strong>will have to wait</strong> until the atomic operation on the variable is complete.</li>
  <li><code class="language-plaintext highlighter-rouge">Atomic operation = read + write</code></li>
</ul>

<p><img src="/images/blogs/javaconcurrency/atomic_ops.png" alt="atomic operations" /></p>

<h3 id="synchronize-blocks">Synchronize blocks</h3>

<ul>
  <li>A monitor is a structure that <strong>supports mutual exclusion</strong> or the property that at most one thread is executing a particular segment of code at a given time.</li>
  <li>In Java, any <code class="language-plaintext highlighter-rouge">Object</code> can be used as a monitor, along with the <code class="language-plaintext highlighter-rouge">synchronized</code> keyword</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code> 	<span class="kd">final</span> <span class="nc">Object</span> <span class="n">lock</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">Object</span><span class="o">();</span>

	<span class="kd">private</span> <span class="kt">void</span> <span class="nf">incrementAndReport</span><span class="o">()</span> <span class="o">{</span>
		<span class="kd">synchronized</span><span class="o">(</span><span class="n">lock</span><span class="o">)</span> <span class="o">{</span>  <span class="c1">// If lock is available, A thread acquires the lock and preventing other threads from entering</span>
			<span class="c1">// Work to be completed by one thread at a time</span>
		<span class="o">}</span>
	<span class="o">}</span>
</code></pre></div></div>

<ul>
  <li>We can add the synchronized modifier to any instance method to synchronize automatically on the object itself. For example, the following two method definitions are equivalent:</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="c1">// synchronize on this</span>

	<span class="kd">private</span> <span class="kt">void</span> <span class="nf">incrementAndReport</span><span class="o">()</span> <span class="o">{</span>
		<span class="kd">synchronized</span><span class="o">(</span><span class="k">this</span><span class="o">)</span> <span class="o">{</span>
			<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">print</span><span class="o">((++</span><span class="n">sheepCount</span><span class="o">)+</span><span class="s">" "</span><span class="o">);</span>
		<span class="o">}</span>
	<span class="o">}</span>

	<span class="kd">private</span> <span class="kd">synchronized</span> <span class="kt">void</span> <span class="nf">incrementAndReport</span><span class="o">()</span> <span class="o">{</span>
		<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">print</span><span class="o">((++</span><span class="n">sheepCount</span><span class="o">)+</span><span class="s">" "</span><span class="o">);</span>
	<span class="o">}</span>
</code></pre></div></div>

<ul>
  <li>You can use static synchronization if you need to order thread access across all instances, rather than a single instance</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="c1">// synchronize on class object</span>

	<span class="kd">public</span> <span class="kd">static</span> <span class="kt">void</span> <span class="nf">printDaysWork</span><span class="o">()</span> <span class="o">{</span>
		<span class="kd">synchronized</span><span class="o">(</span><span class="nc">SheepManager</span><span class="o">.</span><span class="na">class</span><span class="o">)</span> <span class="o">{</span>
			<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">print</span><span class="o">(</span><span class="s">"Finished work"</span><span class="o">);</span>
		<span class="o">}</span>
	<span class="o">}</span>

	<span class="kd">public</span> <span class="kd">static</span> <span class="kd">synchronized</span> <span class="kt">void</span> <span class="nf">printDaysWork</span><span class="o">()</span> <span class="o">{</span>
		<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">print</span><span class="o">(</span><span class="s">"Finished work"</span><span class="o">);</span>
	<span class="o">}</span>
</code></pre></div></div>

<h2 id="4-concurrent-collections">4. Concurrent collections</h2>

<h3 id="concurrenthashmap">ConcurrentHashMap</h3>

<ul>
  <li>It uses a <strong>group of locks</strong> (16 in all), each guarding a subset of the hash table (segment lock)</li>
  <li>Its methods allow read/write operations with minimal locking</li>
  <li>
    <p>Internal:</p>

    <ul>
      <li>Array of buckets with locks on several entries. (segment lock)</li>
      <li>Each bucket can be a linked list or a binary tree if <strong>#Elements &gt; threshold</strong></li>
    </ul>
  </li>
  <li><strong>Behaviors</strong>
    <ul>
      <li>R/W are concurrent if operate on different lists</li>
      <li>R/W to same list are optimized to avoid locking
        <ul>
          <li>atomic add to head of list</li>
          <li>remove from list by setting data to null, rebuild list to skip null. Unreachable cells are GCed</li>
        </ul>
      </li>
      <li>Entire map isn’t locked -&gt; changes may not be visible immediately (there is no single lock that pushes all changes to all threads waiting)</li>
    </ul>
  </li>
</ul>

<p><img src="/images/blogs/javaconcurrency/c_hashmap.png" alt="c_hashmap" /></p>

<h3 id="collectionssynchronizedmap">Collections.synchronizedMap()</h3>

<ul>
  <li>a SynchronizedMap only uses a <strong>single lock</strong> -&gt; slower</li>
  <li>Not scalable as ConcurrentHashMap</li>
</ul>

<h3 id="java-blocking-queue">Java Blocking Queue</h3>

<ul>
  <li>
    <p>Adding to full queue / Get from empty queue can block client (with timeout)</p>

    <ul>
      <li><strong>Consumer thread</strong>: wait for the queue to become non-empty when retrieving an element</li>
      <li><strong>Producer thread</strong>: wait for space to become available when adding an element</li>
    </ul>
  </li>
  <li>
    <p>Internally, many BlockingQueue implementations use <code class="language-plaintext highlighter-rouge">ReentrantLock</code> &amp; <code class="language-plaintext highlighter-rouge">ConditionObjects</code></p>
  </li>
</ul>

<h2 id="5-threading-problems">5. Threading problems</h2>

<h3 id="liveness">Liveness</h3>

<ul>
  <li>Liveness problems, then, are those in which the application becomes unresponsive or in some kind of “stuck” state</li>
</ul>

<p><strong>Deadlock</strong></p>

<ul>
  <li>Deadlock occurs when two or more threads are blocked forever, each waiting on the other.</li>
  <li><strong>Example</strong>: Imagine that our zoo has two foxes: Foxy and Tails
    <ul>
      <li>Foxy likes to eat first and then drink water, while Tails likes to drink water first and then eat. Furthermore, neither animal likes to share, and they will finish their meal only if they have exclusive access to both food and water\</li>
      <li>Foxy obtains the food and then moves to the other side of the environment to obtain the water. Unfortunately, Tails already drank the water and is waiting for the food to become available -&gt; <strong>DEADLOCK</strong></li>
    </ul>
  </li>
</ul>

<p><strong>Starvation</strong></p>

<ul>
  <li>Starvation occurs when a single thread is perpetually denied access to a shared resource or lock.</li>
  <li>The thread is still active, but it is unable to complete its work as a result of other threads constantly taking the resource that they trying to access.</li>
</ul>

<p><strong>Livelock</strong></p>

<ul>
  <li>A livelock is similar to a deadlock, except that the states of the processes involved in the livelock constantly change with regard to one another, none progressing</li>
  <li>ex: Imagine that Foxy and Tails are both holding their food and water resources, respectively.
    <ul>
      <li>They each realize that they cannot finish their meal in this state, so they both let go of their food and water, run to opposite side of the environment, and assetsk up the other resource. Now Foxy has the water, Tails has the food, and neither is able to finish their meal!</li>
      <li>Foxy and Tails are executing a form of failed deadlock recovery. Unfortunately, the lock and unlock process is cyclical, and the two foxes are conceptually deadlocked -&gt; <strong>LIVELOCK</strong></li>
    </ul>
  </li>
</ul>

<h2 id="6-lock-framework">6. Lock framework</h2>

<ul>
  <li>The <code class="language-plaintext highlighter-rouge">Lock</code> framework works in a similar manner to the synchronized code</li>
  <li>Instead of being able to synchronize on any Object , we can only synchronize on an object that implements the Lock interface</li>
  <li>The <code class="language-plaintext highlighter-rouge">Lock</code> framework ensures that once a thread has called the <strong>lock()</strong> method, all other threads that call <strong>lock()</strong> will wait until the thread that acquired the lock calls the <strong>unlock()</strong> method</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="c1">// Implementation #1 with synchronization</span>
	<span class="nc">Object</span> <span class="n">object</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">Object</span><span class="o">();</span>
	<span class="kd">synchronized</span><span class="o">(</span><span class="n">object</span><span class="o">)</span> <span class="o">{</span>
		<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">print</span><span class="o">(</span><span class="s">" "</span><span class="o">+(++</span><span class="n">birdCount</span><span class="o">));</span>
	<span class="o">}</span>

	<span class="c1">// Implementation #2 with a Lock</span>
	<span class="nc">Lock</span> <span class="n">lock</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ReentrantLock</span><span class="o">();</span>
	<span class="k">try</span> <span class="o">{</span>
		<span class="n">lock</span><span class="o">.</span><span class="na">lock</span><span class="o">();</span>
		<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">print</span><span class="o">(</span><span class="s">" "</span><span class="o">+(++</span><span class="n">birdCount</span><span class="o">));</span>
	<span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
		<span class="n">lock</span><span class="o">.</span><span class="na">unlock</span><span class="o">();</span>
	<span class="o">}</span>
</code></pre></div></div>

<h3 id="trylocklong-time-timeunit-unit">tryLock(long time, TimeUnit unit)</h3>

<ul>
  <li>The <code class="language-plaintext highlighter-rouge">tryLock()</code> method will attempt to acquire a lock and immediately return a boolean result indicating whether or not the lock was obtained.</li>
  <li>Unlike the <code class="language-plaintext highlighter-rouge">lock()</code> method, it does not wait if another thread already holds the lock
-&gt; Can be used with timeout to avoid deadlock</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="nc">Lock</span> <span class="n">lock</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ReentrantLock</span><span class="o">();</span>
	<span class="k">if</span><span class="o">(</span><span class="n">lock</span><span class="o">.</span><span class="na">tryLock</span><span class="o">(</span><span class="mi">10</span><span class="o">,</span><span class="nc">TimeUnit</span><span class="o">.</span><span class="na">SECONDS</span><span class="o">))</span> <span class="o">{</span>
		<span class="k">try</span> <span class="o">{</span>
			<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">print</span><span class="o">(</span><span class="s">" "</span><span class="o">+(++</span><span class="n">birdCount</span><span class="o">));</span>
		<span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
			<span class="n">lock</span><span class="o">.</span><span class="na">unlock</span><span class="o">();</span>
		<span class="o">}</span>
	<span class="o">}</span> <span class="k">else</span> <span class="o">{</span>
		<span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"Unable to acquire lock, doing something else"</span><span class="o">);</span>
	<span class="o">}</span>
</code></pre></div></div>

<h3 id="reentrantlock">ReentrantLock()</h3>

<ul>
  <li>A simple monitor lock behaves most like the locks created by the <strong>synchronized</strong> keyword</li>
  <li>
    <p>One advantage to using the <code class="language-plaintext highlighter-rouge">Lock</code> framework is that we can use <code class="language-plaintext highlighter-rouge">tryLock()</code> to avoid deadlocking</p>
  </li>
  <li><code class="language-plaintext highlighter-rouge">unlock()</code> method must be called the same number of times as the <code class="language-plaintext highlighter-rouge">lock()</code> method in order to release the lock</li>
</ul>

<h3 id="fair-lock-management">Fair Lock Management</h3>

<ul>
  <li>By default, when a <code class="language-plaintext highlighter-rouge">ReentrantLock</code> releases a lock, it then assigns it to a waiting thread at random if there are any, in the same manner as synchronized.
-&gt; Could lead to thread starvation</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="nc">Lock</span> <span class="n">lock</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ReentrantLock</span><span class="o">(</span><span class="kc">true</span><span class="o">);</span>
</code></pre></div></div>

<ul>
  <li>When the <code class="language-plaintext highlighter-rouge">boolean</code> value is set to <code class="language-plaintext highlighter-rouge">true</code> , fairness is enabled and the longest waiting thread is guaranteed to obtain the lock the next time it is released</li>
</ul>

<h3 id="readwrite-locks">Read/Write Locks</h3>

<ul>
  <li>Read/Write locks are a type of lock that allows concurrent read access to an object but <strong>requires WRITE exclusive access</strong>.</li>
  <li>Lock <code class="language-plaintext highlighter-rouge">readLock()</code> -&gt; If there is no thread having write lock, then multiple threads can acquire read lock ~ multiple threads can read the data concurrently.</li>
  <li>
    <p>Lock <code class="language-plaintext highlighter-rouge">writeLock()</code> -&gt; If no threads are writing or reading, <strong>only one thread</strong> at a moment can lock the lock for writing. Other threads have to wait until the lock gets released.</p>
  </li>
  <li>The idea is that many threads can be granted a lock to read the object, but a write object is special and can be granted only if no threads are holding any locks on the object</li>
  <li>ReadLock only waits when a write lock is granted.</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kd">class</span> <span class="nc">ReadWriteLockExample</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="nc">ReadWriteLock</span> <span class="n">lock</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ReentrantReadWriteLock</span><span class="o">();</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">read</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">lock</span><span class="o">.</span><span class="na">readLock</span><span class="o">().</span><span class="na">lock</span><span class="o">();</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="c1">// perform read operations</span>
        <span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
            <span class="n">lock</span><span class="o">.</span><span class="na">readLock</span><span class="o">().</span><span class="na">unlock</span><span class="o">();</span>
        <span class="o">}</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">write</span><span class="o">()</span> <span class="o">{</span>
        <span class="n">lock</span><span class="o">.</span><span class="na">writeLock</span><span class="o">().</span><span class="na">lock</span><span class="o">();</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="c1">// perform write operations</span>
        <span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
            <span class="n">lock</span><span class="o">.</span><span class="na">writeLock</span><span class="o">().</span><span class="na">unlock</span><span class="o">();</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="reentrantreadwritelock">ReentrantReadWriteLock</h3>

<ul>
  <li>Java classic R/W lock</li>
  <li>Like the <code class="language-plaintext highlighter-rouge">ReentrantLock</code> class, it also accepts an optional fairness boolean parameter in its constructor</li>
</ul>

<h3 id="stampedlock">StampedLock</h3>

<ul>
  <li>Java 8++ implementation of R/W lock</li>
  <li>
    <p>Provides 3 locking modes</p>

    <ul>
      <li><strong>Writing</strong>: Writing mode is “pessimistic” (assumes contention will occur), no other thread can acquire the lock while it’s held ~ a Write lock is “exclusive”</li>
      <li><strong>Reading</strong>: Reading mode is “pessimistic” (assumes contention will occur), though other threads can acquire the lock for reading ~ a Read lock is “shared”</li>
      <li><strong>Optimistic Reading</strong>: This reading mode is “optimistic” (assumes contention will not occur), so other threads can obtain the lock optimistically, i.e., the lock is “probabilistic”</li>
    </ul>
  </li>
  <li>Locking mode can be converted to each other</li>
  <li>Compare to <code class="language-plaintext highlighter-rouge">ReentrantReadWriteLock</code>:
    <ul>
      <li><code class="language-plaintext highlighter-rouge">StampedLock</code> is not reentrant &gt;&lt; <code class="language-plaintext highlighter-rouge">ReentrantReadWriteLock</code> is reentrant</li>
      <li><code class="language-plaintext highlighter-rouge">StampedLock</code> has optimistic reads, which is simpler/faster than read lock of <code class="language-plaintext highlighter-rouge">ReentrantReadWriteLock</code></li>
      <li>Reduced Blocking
        <ul>
          <li><code class="language-plaintext highlighter-rouge">ReentrantReadWriteLock</code>: If there are many readers, writers can be starved</li>
          <li><code class="language-plaintext highlighter-rouge">StampedLock</code>: By using optimistic reads and a simpler read-write locking mechanism, Writers can invalidate optimistic read stamps efficiently.</li>
        </ul>
      </li>
    </ul>
  </li>
</ul>

<hr />

<h2 id="7-condition-interface">7. Condition interface</h2>

<ul>
  <li>A <code class="language-plaintext highlighter-rouge">Lock</code> replaces the use of synchronized methods and statements, a <code class="language-plaintext highlighter-rouge">Condition</code> replaces the use of the Object monitor methods.</li>
  <li>Conditions (also known as condition queues or condition variables) provide a means for one thread to suspend execution (to “wait”) until notified by another thread that some state condition may now be true</li>
  <li>A Condition instance is bound to a lock using <code class="language-plaintext highlighter-rouge">lock.newCondition()</code> method.</li>
  <li>Use cases: java blocking collections</li>
</ul>

<h3 id="conditionawait">Condition.await()</h3>

<p>-&gt; Causes the current thread to wait until it is signalled or interrupted.</p>

<ul>
  <li>The lock associated with this <code class="language-plaintext highlighter-rouge">Condition</code> is <strong>atomically released</strong> and the current thread becomes disabled for thread scheduling purposes and lies dormant until one of four things happens:
    <ul>
      <li>Some other thread invokes <code class="language-plaintext highlighter-rouge">signal()</code> method for this Condition and the current thread happens to be chosen as the thread to be awakened</li>
      <li>Some other thread invokes the <code class="language-plaintext highlighter-rouge">signalAll()</code> method for this Condition</li>
      <li>Some other thread interrupts the current thread</li>
    </ul>
  </li>
</ul>

<h3 id="conditionsignal">Condition.signal()</h3>

<ul>
  <li>Wakes up one waiting thread.</li>
  <li>One thread is chosen for waking up, this thread must re-acquire the lock before returning from <code class="language-plaintext highlighter-rouge">await()</code></li>
  <li>Example:</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">// put() inserts an element into the queue. If the queue is full, it waits until there's space. After inserting an element, it signals any waiting threads that the queue is not empty.</span>

<span class="c1">// take() removes an element from the queue. If the queue is empty, it waits until there's an element. After removing an element, it signals any waiting threads that the queue is not full.</span>

<span class="kd">public</span> <span class="kd">class</span> <span class="nc">SimpleBlockingQueue</span><span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;</span> <span class="o">{</span>
    <span class="kd">private</span> <span class="nc">Queue</span><span class="o">&lt;</span><span class="no">T</span><span class="o">&gt;</span> <span class="n">queue</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">LinkedList</span><span class="o">&lt;&gt;();</span>
    <span class="kd">private</span> <span class="kt">int</span> <span class="n">capacity</span><span class="o">;</span>
    <span class="kd">private</span> <span class="nc">Lock</span> <span class="n">lock</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">ReentrantLock</span><span class="o">();</span>
    <span class="kd">private</span> <span class="nc">Condition</span> <span class="n">notFull</span> <span class="o">=</span> <span class="n">lock</span><span class="o">.</span><span class="na">newCondition</span><span class="o">();</span>
    <span class="kd">private</span> <span class="nc">Condition</span> <span class="n">notEmpty</span> <span class="o">=</span> <span class="n">lock</span><span class="o">.</span><span class="na">newCondition</span><span class="o">();</span>

    <span class="kd">public</span> <span class="nf">SimpleBlockingQueue</span><span class="o">(</span><span class="kt">int</span> <span class="n">capacity</span><span class="o">)</span> <span class="o">{</span>
        <span class="k">this</span><span class="o">.</span><span class="na">capacity</span> <span class="o">=</span> <span class="n">capacity</span><span class="o">;</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="kt">void</span> <span class="nf">put</span><span class="o">(</span><span class="no">T</span> <span class="n">element</span><span class="o">)</span> <span class="kd">throws</span> <span class="nc">InterruptedException</span> <span class="o">{</span>
        <span class="n">lock</span><span class="o">.</span><span class="na">lock</span><span class="o">();</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="k">while</span><span class="o">(</span><span class="n">queue</span><span class="o">.</span><span class="na">size</span><span class="o">()</span> <span class="o">==</span> <span class="n">capacity</span><span class="o">)</span> <span class="o">{</span>
                <span class="n">notFull</span><span class="o">.</span><span class="na">await</span><span class="o">();</span>
            <span class="o">}</span>
            <span class="n">queue</span><span class="o">.</span><span class="na">add</span><span class="o">(</span><span class="n">element</span><span class="o">);</span>
            <span class="n">notEmpty</span><span class="o">.</span><span class="na">signal</span><span class="o">();</span>
        <span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
            <span class="n">lock</span><span class="o">.</span><span class="na">unlock</span><span class="o">();</span>
        <span class="o">}</span>
    <span class="o">}</span>

    <span class="kd">public</span> <span class="no">T</span> <span class="nf">take</span><span class="o">()</span> <span class="kd">throws</span> <span class="nc">InterruptedException</span> <span class="o">{</span>
        <span class="n">lock</span><span class="o">.</span><span class="na">lock</span><span class="o">();</span>
        <span class="k">try</span> <span class="o">{</span>
            <span class="k">while</span><span class="o">(</span><span class="n">queue</span><span class="o">.</span><span class="na">isEmpty</span><span class="o">())</span> <span class="o">{</span>
                <span class="n">notEmpty</span><span class="o">.</span><span class="na">await</span><span class="o">();</span>
            <span class="o">}</span>
            <span class="no">T</span> <span class="n">item</span> <span class="o">=</span> <span class="n">queue</span><span class="o">.</span><span class="na">remove</span><span class="o">();</span>
            <span class="n">notFull</span><span class="o">.</span><span class="na">signal</span><span class="o">();</span>
            <span class="k">return</span> <span class="n">item</span><span class="o">;</span>
        <span class="o">}</span> <span class="k">finally</span> <span class="o">{</span>
            <span class="n">lock</span><span class="o">.</span><span class="na">unlock</span><span class="o">();</span>
        <span class="o">}</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h2 id="8-semaphore">8. Semaphore</h2>

<ul>
  <li>A semaphore is conceptually an “object” that can be atomically incremented &amp; decremented to <strong>control access to a shared resource</strong></li>
  <li>It records a <code class="language-plaintext highlighter-rouge">count</code> (“permits”) of how many units of a resource are available</li>
  <li>It provides operations to <strong>adjust the permit count atomically</strong> as units are acquired or released</li>
  <li>Threads can wait (timed or blocking) until a unit of the resource is available</li>
  <li>When a thread is done with a resource the permit count is incremented atomically &amp; another waiting thread can acquire it</li>
</ul>

<h3 id="semaphore-types">Semaphore types</h3>

<p><strong>1. Counting semaphore</strong></p>

<ul>
  <li>Have # of permits defined by a counter (N)
    <ul>
      <li><strong>Negative</strong>: exactly -N threads queued waiting to acquire semaphore</li>
      <li><strong>Zero</strong> = No waiting threads: an acquire operation will block the invoking thread until N is positive</li>
      <li><strong>Positive</strong> = No waiting threads: an acquire will not block the invoking thread</li>
    </ul>
  </li>
</ul>

<p><strong>2. Binary semaphore</strong></p>

<ul>
  <li>
    <table>
      <tbody>
        <tr>
          <td>Have only 2 states: acquired (0) &amp; not acquired (1) ==&gt; N = 0</td>
          <td> </td>
          <td>N = 1</td>
        </tr>
      </tbody>
    </table>
  </li>
</ul>

<h3 id="java-semaphore">Java Semaphore</h3>

<ul>
  <li>A semaphore maintains a set of permits.</li>
  <li>Each <code class="language-plaintext highlighter-rouge">acquire()</code> blocks if necessary until a permit is available, and then takes it.</li>
  <li>Each <code class="language-plaintext highlighter-rouge">release()</code> adds a permit, potentially releasing a blocking acquirer.</li>
  <li>A thread that acquires a semaphore need not be the one that releases it</li>
  <li>Note: Semaphore not provide any guarantees about the synchronization (order) in which threads will access the shared resource, it only control the number of threads that can access code at the same time.</li>
</ul>

<p><strong>Methods</strong></p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">acquire()</code> atomically obtains a permit from the semaphore, can be interrupted</li>
  <li><code class="language-plaintext highlighter-rouge">tryAcquire()</code> obtains a permit if it’s available at invocation time</li>
  <li><code class="language-plaintext highlighter-rouge">release()</code> atomically increments the permit count by 1 -&gt; a thread waiting to acquire the semaphore can then proceed</li>
</ul>

<h3 id="binary-semaphore-vs-reentrant-lock-mutex">Binary Semaphore vs Reentrant Lock (mutex)</h3>

<ul>
  <li>Mechanism
    <ul>
      <li>Binary semaphore = signaling mechanism</li>
      <li>Reentrant lock = locking mechanism</li>
    </ul>
  </li>
  <li>Ownership
    <ul>
      <li>No thread is the owner of a binary semaphore. Any thread can signal (release) a semaphore, regardless of threads wait on (acquire) it.</li>
      <li>A lock (mutex) has ownership, the last thread that successfully locked a resource is the owner of a reentrant lock, Only thread that locks the mutex can unlock it</li>
    </ul>
  </li>
  <li>Reentrant
    <ul>
      <li>Binary semaphores are non-reentrant by nature -&gt; same thread can’t re-acquire a critical section, else it will lead to a deadlock situation.</li>
      <li>A reentrant lock allows reentering a lock by the same thread multiple times.</li>
    </ul>
  </li>
</ul>

<h2 id="9-java-volatile-variables">9. Java Volatile Variables</h2>

<ul>
  <li>Ensure a variable is read from &amp; written to main memory &amp; not cached
    <ul>
      <li>e.x: sharing a field between two threads</li>
    </ul>
  </li>
  <li>Volatile ensures that changes to a variable are always consistent &amp; visible to other threads atomically</li>
  <li>Reads &amp; writes go directly to main memory (not registers/cache) to avoid read/write conflicts on Java fields storing shared mutable data</li>
  <li>
    <p>Volatile reads/writes cannot be reordered</p>

    <ul>
      <li>The Java compiler automatically transforms reads &amp; writes on a volatile variable into atomic <code class="language-plaintext highlighter-rouge">acquire</code> &amp; <code class="language-plaintext highlighter-rouge">release</code> pairs</li>
    </ul>
  </li>
  <li>volatile write is visible to “happens-after” reads</li>
  <li>Note: incrementing <code class="language-plaintext highlighter-rouge">i++</code> is not atomic</li>
</ul>

<h3 id="piggybacking--volatile-variable-rule">Piggybacking / volatile variable rule</h3>

<ul>
  <li>Anything prior to writing <code class="language-plaintext highlighter-rouge">true</code> to <code class="language-plaintext highlighter-rouge">boolean v</code> is visible to anything after reading <code class="language-plaintext highlighter-rouge">boolean v</code>.</li>
  <li>=&gt; the <code class="language-plaintext highlighter-rouge">x</code> variable piggybacks on the memory visibility enforced by <code class="language-plaintext highlighter-rouge">boolean v</code>. Simply put, even though it’s not a volatile variable, it’s exhibiting a volatile behaviour.</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code>	<span class="kd">public</span> <span class="kd">class</span> <span class="nc">VolatileExample</span> <span class="o">{</span>
		<span class="kt">int</span> <span class="n">x</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span>
		<span class="kd">volatile</span> <span class="kt">boolean</span> <span class="n">v</span> <span class="o">=</span> <span class="kc">false</span><span class="o">;</span>

		<span class="kd">public</span> <span class="kt">void</span> <span class="nf">writer</span><span class="o">()</span> <span class="o">{</span>
			<span class="n">x</span> <span class="o">=</span> <span class="mi">42</span><span class="o">;</span>  <span class="c1">// -&gt; enfore volatile behavior</span>
			<span class="n">v</span> <span class="o">=</span> <span class="kc">true</span><span class="o">;</span>
		<span class="o">}</span>

		<span class="kd">public</span> <span class="kt">void</span> <span class="nf">reader</span><span class="o">()</span> <span class="o">{</span>
			<span class="k">if</span> <span class="o">(</span><span class="n">v</span> <span class="o">==</span> <span class="kc">true</span><span class="o">)</span> <span class="o">{</span>
			   <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="n">x</span><span class="o">);</span>
			<span class="o">}</span>
		<span class="o">}</span>
	<span class="o">}</span>
</code></pre></div></div>

<h2 id="10-java-happens-before-relationships">10. Java “Happens-Before” Relationships</h2>

<ul>
  <li>In single thread, each action “happens-before” every action in that thread that occurs later in the program order</li>
  <li>
    <p>In multi-thread, actions in different threads can occur in different orders -&gt; can cause problems without proper synchronization</p>
  </li>
  <li>In computer system - “happens-before” guarantee that if one action “happens before” another action, the results must reflect that ordering</li>
  <li>
    <p>In Java, “happens-before” guarantee that an action performed by one thread is visible to another action in a different thread</p>
  </li>
  <li>How Threads Share Data with Each Other (Follow Code Rules to Ensure Thread Safety):
    <ul>
      <li>
        <p><strong>Program Order Rule</strong>: Each action in a single thread happens-before every action in that thread that comes later in the program order.</p>
      </li>
      <li>
        <p><strong>Monitor Lock Rule</strong>: An unlock action on a monitor lock happens-before every subsequent lock action on the same monitor lock (synchronized). The same applies to the Lock interface.</p>
      </li>
      <li>
        <p><strong>Volatile Variable Rule</strong>: A write to a volatile variable happens-before every subsequent read of that same volatile variable. The same applies to Atomic classes.</p>
      </li>
      <li>
        <p><strong>Thread Start Rule</strong>: A call to Thread.start() on a thread happens-before every action in the started thread.</p>
      </li>
      <li>
        <p><strong>Thread Termination Rule</strong>: Any action in a thread happens-before any other thread successfully returns from a Thread.join() on that thread. This means all data modified by threadB will be visible to threadA once threadB.join() returns.</p>
      </li>
      <li>
        <p><strong>Transitivity Rule</strong>: If action A happens-before action B, and action B happens-before action C, then action A happens-before action C.</p>
      </li>
    </ul>
  </li>
</ul>

<!-- 
- Cách các Thread chia sẻ dữ liệu với nhau (code theo để đảm bảo threadsafe):
  - **Program rule**: Hành động trong cùng một thread happens-before các hành động khác trong cùng thread.
  - **Monitor lock rule**: Hành động **unlock** happens-before trước các hành động **lock** trên cùng một monitor lock (synchronized). Tương tự cho interface Lock
  - **volatile variable rule** : Hành động thay đổi một biến volatile happens-before trước các hành động đọc biến volatile. Tương tự cho Atomic
  - **Thread start rule** : Hành động start() thread happens-before trước các hành động khác trong thread
  - **Thread terminate rule** : Tất cả hành động của thead happens-before trước hành động thread.join(). Nghĩa là tất cả dữ liệu được threadB thay đổi sẽ được threadA nhìn thấy khi hàm threadB.join() trả lại.
  - **Transitivity rule** : A happens before B & B happens before C => A happens before C -->

<h2 id="11-java-barrier-synchronization">11. Java Barrier Synchronization</h2>

<h3 id="introduction">Introduction</h3>

<ul>
  <li>A barrier is a synchronizer that ensures thread(s) <strong>must stop at a certain point</strong> &amp; cannot proceed until all other thread(s) reach this barrier</li>
  <li>Compare with other types of Java synchronizers
    <ul>
      <li><strong>Atomic operations</strong>: actions that happen effectively all at once or not at all (e.g: Atomic classes)</li>
      <li><strong>Mutual exclusion synchronizers</strong>: allow concurrent access &amp; updates to shared mutable data within critical sections (e.g: Lock)</li>
      <li><strong>Coordination synchronizers</strong>: ensure that computations run properly order, time, conditions, … (e.g: ConditionObject)</li>
    </ul>
  </li>
</ul>

<p><strong>3 types of Barrier:</strong></p>

<ul>
  <li><strong>Entry barrier</strong>: keep concurrent computations from running untils object(s) are fully init
    <ul>
      <li>e.g: Main thread spawns # of worker threads &amp; then performs some timeconsuming initialization of data structures. After init workers can perform tasks.</li>
      <li>e.g 2: Tourists wait outside museum until it opens or until a tour is schedule to begin</li>
    </ul>
  </li>
  <li>
    <p><strong>Exit barrier</strong>: don’t let a thread continue until a group of concurrent threads have finished their processing</p>

    <ul>
      <li>e.g: The main thread waits on an exit barrier for all worker threads to finish</li>
      <li>e.g 2: The museum closes only after last group of tourists leave</li>
    </ul>
  </li>
  <li><strong>Cyclic barrier</strong>: a group of threads all wait for each other to reach a certain point before advancing to the next cycle
    <ul>
      <li>e.g 2: Tour guide waits for all the tourists to finish exploring a room before continuing the tour in next room</li>
    </ul>
  </li>
</ul>

<h3 id="countdownlatch">CountDownLatch</h3>

<ul>
  <li>Allows one or more threads to wait on the completion of operations in other threads</li>
  <li>Supports 2: entry &amp; exit barriers, but not cyclic barriers</li>
  <li>Well-suited for fixed-size, one-shot “entry” &amp; “exit” barriers</li>
  <li>Simple APIs: <code class="language-plaintext highlighter-rouge">await()</code> and <code class="language-plaintext highlighter-rouge">countDown()</code> -&gt; releases any threads blocked on <code class="language-plaintext highlighter-rouge">await()</code> when count reaches 0</li>
</ul>

<h3 id="cyclicbarrier">CyclicBarrier</h3>

<ul>
  <li>The <code class="language-plaintext highlighter-rouge">CyclicBarrier</code> allows a group of threads to all wait for each other to reach a common barrier point. It is called cyclic because it can be re-used after the waiting threads are released.</li>
  <li>
    <p>Supports 3: entry, exit, &amp; cyclic barriers for a <strong>fixed</strong> # of threads</p>
  </li>
  <li>
    <p>The <code class="language-plaintext highlighter-rouge">CyclicBarrier</code> is initialized with a given count = number of threads it should wait for.</p>

    <ul>
      <li>As threads reach the barrier point, they call <code class="language-plaintext highlighter-rouge">CyclicBarrier.await()</code>, which puts the thread into a waiting state.</li>
      <li>Once the specified number of threads have each called <code class="language-plaintext highlighter-rouge">await()</code>, the barrier is considered broken and all waiting threads are released to continue execution.</li>
    </ul>
  </li>
  <li>
    <p>Compare <code class="language-plaintext highlighter-rouge">CountDownLatch</code> vs <code class="language-plaintext highlighter-rouge">CyclicBarrier</code>:</p>

    <ul>
      <li><code class="language-plaintext highlighter-rouge">CountDownLatch</code> focuses on actions (entry + exit)
        <ul>
          <li>When 1 thread waits until N threads have completed an action</li>
          <li>1 thread waits until an action has completed N times, irrespective of which thread(s) were responsible</li>
        </ul>
      </li>
      <li><code class="language-plaintext highlighter-rouge">CyclicBarrier</code> focuses on threads (entry + exit + cyclic)
        <ul>
          <li>When N threads wait for each other to reach a common process point</li>
        </ul>
      </li>
    </ul>
  </li>
  <li>Internally, <code class="language-plaintext highlighter-rouge">CyclicBarrier</code> use Lock + Condition + # parties + <code class="language-plaintext highlighter-rouge">Runnable barrierAction</code> when all parties arrive</li>
</ul>

<div class="language-java highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kd">public</span> <span class="kd">class</span> <span class="nc">CyclicBarrierExample</span> <span class="o">{</span>
    <span class="kd">public</span> <span class="kd">static</span> <span class="kt">void</span> <span class="nf">main</span><span class="o">(</span><span class="nc">String</span><span class="o">[]</span> <span class="n">args</span><span class="o">)</span> <span class="o">{</span>
        <span class="kd">final</span> <span class="kt">int</span> <span class="n">totalThread</span> <span class="o">=</span> <span class="mi">5</span><span class="o">;</span>

        <span class="c1">// Runnable - barrierAction ~ the command to execute when the barrier is tripped, or null if there is no action</span>
        <span class="nc">CyclicBarrier</span> <span class="n">barrier</span> <span class="o">=</span> <span class="k">new</span> <span class="nc">CyclicBarrier</span><span class="o">(</span><span class="n">totalThread</span><span class="o">,</span> <span class="o">()</span> <span class="o">-&gt;</span> <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"All tasks are finished."</span><span class="o">));</span>

        <span class="nc">ExecutorService</span> <span class="n">executorService</span> <span class="o">=</span> <span class="nc">Executors</span><span class="o">.</span><span class="na">newFixedThreadPool</span><span class="o">(</span><span class="n">totalThread</span><span class="o">);</span>
        <span class="k">for</span> <span class="o">(</span><span class="kt">int</span> <span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="o">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="n">totalThread</span><span class="o">;</span> <span class="n">i</span><span class="o">++)</span> <span class="o">{</span>
            <span class="n">executorService</span><span class="o">.</span><span class="na">execute</span><span class="o">(()</span> <span class="o">-&gt;</span> <span class="o">{</span>
                <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"Before barrier: "</span> <span class="o">+</span> <span class="nc">Thread</span><span class="o">.</span><span class="na">currentThread</span><span class="o">().</span><span class="na">getName</span><span class="o">());</span>

                <span class="n">barrier</span><span class="o">.</span><span class="na">await</span><span class="o">();</span> <span class="c1">// Block until all parties arrive &amp; barrier resets</span>

                <span class="nc">System</span><span class="o">.</span><span class="na">out</span><span class="o">.</span><span class="na">println</span><span class="o">(</span><span class="s">"After barrier: "</span> <span class="o">+</span> <span class="nc">Thread</span><span class="o">.</span><span class="na">currentThread</span><span class="o">().</span><span class="na">getName</span><span class="o">());</span>
            <span class="o">});</span>
        <span class="o">}</span>
        <span class="n">executorService</span><span class="o">.</span><span class="na">shutdown</span><span class="o">();</span>
    <span class="o">}</span>
<span class="o">}</span>
</code></pre></div></div>

<h3 id="phaser">Phaser</h3>

<ul>
  <li>A more flexible, reusable, &amp; dynamic barrier synchronizer that combines CyclicBarrier &amp; CountDownLatch</li>
  <li>Allows a variable (or fixed) # of threads to wait for all operations performed in other threads to complete before proceeding</li>
  <li><strong>Number of parties can vary dynamically</strong></li>
  <li>
    <p>Supports 3: entry, exit, &amp; cyclic barriers for a <strong>variable</strong> # of threads</p>
  </li>
  <li>
    <p>Internally, <code class="language-plaintext highlighter-rouge">Phaser</code> uses</p>

    <ul>
      <li><code class="language-plaintext highlighter-rouge">volatile long state</code> (4 bit fields)
        <ul>
          <li><strong>Unarrived</strong> - the # of parties yet to hit barrier (bits 0-15)</li>
          <li><strong>Parties</strong> - # of parties to wait for before advancing to the next phase (bits 16-31)</li>
          <li><strong>Phase</strong> - the generation of the barrier (bits 32 - 62)</li>
          <li><strong>Terminated</strong> - if barrier is terminated (bit 63 / sign)</li>
        </ul>
      </li>
    </ul>
  </li>
  <li>Compare to <code class="language-plaintext highlighter-rouge">CyclicBarrier</code>:
    <ul>
      <li><code class="language-plaintext highlighter-rouge">Phaser</code> allows threads to dynamically register and deregister. This is useful in scenarios where the number of tasks or threads is not known in advance.</li>
      <li><code class="language-plaintext highlighter-rouge">Phaser</code> supports multiple phases of computation. Once all threads have arrived at the <code class="language-plaintext highlighter-rouge">Phaser</code>, it advances to the next phase. This is useful in iterative algorithms where each iteration is a separate phase.</li>
      <li>Flexiable arrival: A thread can wait for all parties to arrive or can just register its arrival using <code class="language-plaintext highlighter-rouge">arrive()</code> and continue without waiting for others.</li>
    </ul>
  </li>
</ul>

<h2 id="references">References</h2>

<ul>
  <li><a href="https://www.dre.vanderbilt.edu/~schmidt/cs891s/2019-PDFs/">Java Concurrency Collections</a></li>
  <li><a href="https://docs.google.com/presentation/d/1wE986IU7dTriFPlubmYiDrXcZOPF01iF9qmwVOohTvo/edit#slide=id.g2ab1348b6de_0_72">Concurrency in practice (vnese)</a></li>
  <li><a href="https://rockset.com/blog/improving-concurrency-redis-rate-limiting-system/">Rate limiter design</a></li>
</ul>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Java" /><category term="Concurrency" /><summary type="html"><![CDATA[This article provides understanding of Java Concurrency concepts, including threads, ExecutorService, synchronization, concurrent collections, threading problems, locks, conditions, semaphores, volatile variables, happens-before relationships, and barrier synchronization.]]></summary></entry><entry><title type="html">Redis 101</title><link href="https://hoangtl.site/posts/redis-101/" rel="alternate" type="text/html" title="Redis 101" /><published>2025-02-24T00:00:00+00:00</published><updated>2025-02-24T00:00:00+00:00</updated><id>https://hoangtl.site/posts/redis101</id><content type="html" xml:base="https://hoangtl.site/posts/redis-101/"><![CDATA[<p>This article introduces Redis, a widely-used in-memory data store. It covers Redis basics, caching strategies, data structures, persistence mechanisms, and techniques.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#1-redis-introduction" id="markdown-toc-1-redis-introduction">1. Redis Introduction</a>    <ul>
      <li><a href="#11-what-is-redis" id="markdown-toc-11-what-is-redis">1.1. What is Redis?</a></li>
      <li><a href="#12-compared-to-other-db-and-software" id="markdown-toc-12-compared-to-other-db-and-software">1.2. Compared to other db and software</a></li>
      <li><a href="#13-why-redis" id="markdown-toc-13-why-redis">1.3. Why Redis?</a></li>
    </ul>
  </li>
  <li><a href="#2-redis-caching-strategies" id="markdown-toc-2-redis-caching-strategies">2. Redis caching Strategies</a>    <ul>
      <li><a href="#21-cache-aside" id="markdown-toc-21-cache-aside">2.1. Cache aside</a></li>
      <li><a href="#22-write-through" id="markdown-toc-22-write-through">2.2. Write through</a></li>
    </ul>
  </li>
  <li><a href="#2-redis-data-structures" id="markdown-toc-2-redis-data-structures">2. Redis data structures</a>    <ul>
      <li><a href="#20-redis-keys" id="markdown-toc-20-redis-keys">2.0. Redis keys</a></li>
      <li><a href="#21-strings" id="markdown-toc-21-strings">2.1. Strings</a></li>
      <li><a href="#22-lists" id="markdown-toc-22-lists">2.2. Lists</a></li>
      <li><a href="#23-sets" id="markdown-toc-23-sets">2.3. Sets</a></li>
      <li><a href="#24-hashes" id="markdown-toc-24-hashes">2.4. Hashes</a></li>
      <li><a href="#25-sorted-sets" id="markdown-toc-25-sorted-sets">2.5. Sorted Sets</a></li>
      <li><a href="#26-bitmaps" id="markdown-toc-26-bitmaps">2.6. Bitmaps</a></li>
      <li><a href="#27-hyperloglog" id="markdown-toc-27-hyperloglog">2.7. HyperLogLog</a></li>
      <li><a href="#27-why-redis-single-threaded" id="markdown-toc-27-why-redis-single-threaded">2.7. Why Redis single threaded?</a></li>
    </ul>
  </li>
  <li><a href="#3-redis-persistence" id="markdown-toc-3-redis-persistence">3. Redis persistence</a>    <ul>
      <li><a href="#31-rdb-redis-database" id="markdown-toc-31-rdb-redis-database">3.1. RDB (Redis Database)</a></li>
      <li><a href="#32-aof-append-only-file" id="markdown-toc-32-aof-append-only-file">3.2. AOF (Append-only file)</a></li>
      <li><a href="#33-rdb-vs-aof" id="markdown-toc-33-rdb-vs-aof">3.3. RDB vs AOF</a></li>
    </ul>
  </li>
  <li><a href="#4-partitioning" id="markdown-toc-4-partitioning">4. Partitioning</a>    <ul>
      <li><a href="#41-range-partitioning" id="markdown-toc-41-range-partitioning">4.1. Range partitioning</a></li>
      <li><a href="#42-hash-partitioning" id="markdown-toc-42-hash-partitioning">4.2. Hash partitioning</a></li>
      <li><a href="#43-hash-slot-consistent-hashing" id="markdown-toc-43-hash-slot-consistent-hashing">4.3. Hash slot, consistent hashing</a></li>
    </ul>
  </li>
  <li><a href="#references" id="markdown-toc-references">References</a></li>
</ul>

  </nav>
</aside>

<h2 id="1-redis-introduction">1. Redis Introduction</h2>

<h3 id="11-what-is-redis">1.1. What is Redis?</h3>

<p>Generally, Redis is a in-memory <strong>data structure store</strong>, used as a database that stores a mapping of keys to different value types</p>

<p>Redis supports in-memory persistent storage on disk, replication to scale read performance, client-side sharding to scale write performance</p>

<p><em>Sharding is a method of partitioning data into difference pieces. (ex: based on IDs of keys, hashes…)</em></p>

<h3 id="12-compared-to-other-db-and-software">1.2. Compared to other db and software</h3>

<p>In Redis, there are no tables, no database-defined way of relating data together</p>

<p>It’s not uncommon to compare <strong>Redis</strong> vs <strong>memcached</strong>.</p>

<p>Like memcached, Redis store a mapping of keys to values, achieve similar performance as memcached.</p>

<p>Redis ~ single thread execution (better performance for atomic operations), while memcached ~ multithreads</p>

<p>However, Redis supports the writing of its data to disk automatically, can store 4 different data structures beside plain string as memcached</p>

<p>⇒ Generally speaking, Redis users will choose to store data in</p>

<p><strong>Redis</strong> only when the performance or functionality of Redis is necessary,</p>

<p><strong>other relational or non-relational data storage</strong> for data where slower performance is acceptable, or where data is too large to fit in memory economically</p>

<p><img src="/images/blogs/redis101/Untitled.png" alt="Untitled" /></p>

<h3 id="13-why-redis">1.3. Why Redis?</h3>

<p><strong>High performance and low latency</strong></p>

<p>Redis been written in C → Optimize compiler better</p>

<p>Runs entirely in memory (&gt; 1.5m ops/s with &lt;1ms latency)</p>

<p>Single thread with atomic operations</p>

<p><strong>Support pre build-in data structures</strong></p>

<p>→ Simplify application, addressing complex functionalities within simple commands</p>

<p>Allows data to be processed on the database level instead of application level → reduce code complexity, bandwidth requirements, …</p>

<p><img src="/images/blogs/redis101/Untitled%201.png" alt="Untitled" /></p>

<p><strong>Compatibility</strong></p>

<p>Open source and stable, used by tech-giants like GitHub,Weibo, Pinterest, Snapchat, Craigslist, Digg, StackOverflow, Flickr</p>

<p>Large supporting community for almost all famous programming languages (Most loved database by developer (stackoverflow))</p>

<p>Redis Modules: extend Redis to cover most popular use cases in a wide variety of industries (Search, json, ML, data processing, …)</p>

<p><img src="/images/blogs/redis101/Screenshot_from_2021-11-24_16-36-13.png" alt="Screenshot from 2021-11-24 16-36-13.png" /></p>

<h2 id="2-redis-caching-strategies">2. Redis caching Strategies</h2>

<h3 id="21-cache-aside">2.1. Cache aside</h3>

<p><img src="/images/blogs/redis101/Untitled%202.png" alt="Untitled" /></p>

<p>This is the most commonly used caching strategy. The idea is that the cache sits between the application and the data source. The application will prioritize fetching data from the cache. When data is not available in the cache, the application will retrieve it from the data source, then update the cache, so that subsequent requests can find the data in the cache.</p>

<p><strong>Use Cases:</strong> This strategy is typically used for heavy data that is accessed frequently and returns results that change infrequently.</p>

<p><strong>Advantages:</strong> Systems using this strategy have the ability to recover from cache failures. If the cache fails, the application can directly access the data source.</p>

<p><strong>Disadvantages:</strong></p>

<ul>
  <li>Does not guarantee data consistency; requires an appropriate cache update strategy.</li>
  <li>When called for the first time, data is not in the cache =&gt; extra call to cache =&gt; needs warm-up, loading data into the cache beforehand.</li>
</ul>

<h3 id="22-write-through">2.2. Write through</h3>

<p><img src="/images/blogs/redis101/Untitled%203.png" alt="Untitled" /></p>

<p>The application fetches data similar to Read-Through, but when updating data, the Cache Provider will prioritize updating the cache first, then the Cache Provider will automatically update the data to the data source.</p>

<p><strong>Use Cases:</strong> Combined with Read-Through to ensure data consistency.</p>

<p><strong>Advantages:</strong> Ensures data consistency.</p>

<p><strong>Disadvantages:</strong> Increases latency when writing data.</p>

<h2 id="2-redis-data-structures">2. Redis data structures</h2>

<h3 id="20-redis-keys">2.0. Redis keys</h3>

<p>Redis keys are a <strong>binary safe</strong>, made up of a <strong>sequence of bytes</strong>, use any binary sequence as a key (which can hold string, integers, images, files, and serializable objects in them)</p>

<p>Key names maximum size = 512MB; Tradeoff between Length vs Readability</p>

<p>Key spaces:</p>

<ul>
  <li>Logical databases:
    <ul>
      <li>Database zero: assure unique key names</li>
    </ul>
  </li>
  <li>Flat key space: All key names occupies same space -&gt; Need naming convention</li>
  <li>No automatic namespace (ex: bucket, collection…)</li>
  <li><strong>Redis does not store empty lists, sets, sorted sets or hashes</strong></li>
</ul>

<p>Example: “user:id:followers”</p>

<ul>
  <li>User: object name</li>
  <li>1000: unique identifier of the instance</li>
  <li>Followers: composed object</li>
</ul>

<p><strong>Commands</strong></p>

<p><strong>KEYS</strong> (O(N) with N being the number of keys in the database)</p>

<p>Blocks until complete , which may ruin performance when it is executed against large databases -&gt; Never use in production</p>

<p>→ Not safe for production</p>

<p><strong>SCAN</strong> (O(1) for every call. O(N) for a complete iteration)</p>

<p><strong>cursor based iterator</strong> (pointer to next iteration); terminates when redis SCAN return 0</p>

<p><strong>SCAN</strong> does not provide guarantees about the number of elements returned at every iteration. Using <strong>COUNT</strong> to hint the implementation (default = 10)</p>

<p>invalid cursor will result in undefined behaviors but never into a crash</p>

<p>Drawbacks: A given element may be returned multiple times. Inconsistency elements may be returned or not: it is undefined</p>

<p><img src="/images/blogs/redis101/Untitled%204.png" alt="Untitled" /></p>

<p>Redis enables automatic expiration of keys through a <strong>Time To Live (TTL) mechanism</strong>. The TTL can be modified and removed by you as long as the key has not been removed.</p>

<p><strong>TTL can be set in seconds, milliseconds or Unix time epoch with EXPIREAT</strong></p>

<h3 id="21-strings">2.1. Strings</h3>

<p>In Redis, strings are called <strong>Simple Dynamic String (SDS) →</strong> binary safe</p>

<p><a href="https://github.com/antirez/sds">https://github.com/antirez/sds</a></p>

<p><img src="/images/blogs/redis101/Untitled%205.png" alt="Untitled" /></p>

<p><img src="/images/blogs/redis101/Untitled%206.png" alt="Untitled" /></p>

<p><img src="/images/blogs/redis101/Untitled%207.png" alt="Untitled" /></p>

<p>Strings can be manipulated as Text, Float, Integers (manipulate numerical value (INCR and INCRBY)</p>

<p>Commonly used for caching when combined with <strong>EXPIRE</strong></p>

<p>ex: Redis checks type of key → If String → check encoding value → If INT → perform INCR</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nb">type </span>inventory:4x100m-womens-final <span class="c">#string</span>
object encoding inventory:4x100m-womens-final <span class="c">#int</span>
</code></pre></div></div>

<p><strong>Commands</strong></p>

<p><img src="/images/blogs/redis101/Untitled%208.png" alt="Untitled" /></p>

<p><img src="/images/blogs/redis101/Untitled%209.png" alt="Untitled" /></p>

<h3 id="22-lists">2.2. Lists</h3>

<p>The advantage of the Redis list getting implemented as a linked list rather than an
array list is because Redis list as a data type was designed to have faster writes than
reads</p>

<p>Lists of strings, sorted by insertion order, duplicates are allowed</p>

<p>Single level -&gt; No concept of nesting hierarchies or graphs within data structures</p>

<p>max length of a list is 2^32 - 1 elements</p>

<p><img src="/images/blogs/redis101/Untitled%2010.png" alt="Untitled" /></p>

<p><strong>Use case scenario</strong></p>

<p>List provides with a sematic interface to store data sequentially in a Redis server
where the write speeds are more desirable than read performance. For example,
log messages</p>

<p>Pub/Sub scenario: inter process communication</p>

<p><strong>Commands</strong></p>

<p>LPUSH, RPUSH, LPOP, RPOP, LLEN, LRANGE, LINDEX</p>

<h3 id="23-sets">2.3. Sets</h3>

<p>Unordered collection of Strings contains no duplicates (Redis SETs use a hash table to keep item2 all strings unique)</p>

<p>Single level -&gt; No concept of nesting hierarchies or graphs within data structures</p>

<p>max length of a set is 2^32 - 1 elements</p>

<p><img src="/images/blogs/redis101/Untitled%2011.png" alt="Untitled" /></p>

<p><strong>Commands</strong></p>

<p><strong>SADD</strong> <set> <value></value></set></p>

<table>
  <tbody>
    <tr>
      <td><strong>SCARDS</strong> -&gt; cardinality</td>
      <td>set</td>
    </tr>
  </tbody>
</table>

<p><strong>SMEMBERS</strong> retrieve all elements of a set.</p>

<p><strong>SSCAN</strong> -&gt; cursor-based, more efficient</p>

<p><strong>SISMEMBER</strong> -&gt; check if element exists in set</p>

<p><strong>SREM</strong>: remove by value -&gt; return 0 1</p>

<p><strong>SPOP</strong>: remove random number of elements (default 1)</p>

<p><strong>SMOVE</strong> source destination member: Move member from the set at source to the set at destination</p>

<h3 id="24-hashes">2.4. Hashes</h3>

<p>Mutable collections of field-value pairs.</p>

<p>Nested structure -&gt; Redis JSON</p>

<p><strong>Note:</strong> Expiration time can only be defined on a Key, not a Field within a Key</p>

<p>It is worth noting that small hashes (i.e., a few elements with small values) are encoded in special way in memory that make them very memory efficient. (<code class="language-plaintext highlighter-rouge">listpack</code>)</p>

<p><a href="https://gist.github.com/antirez/66ffab20190ece8a7485bd9accfbc175">https://gist.github.com/antirez/66ffab20190ece8a7485bd9accfbc175</a></p>

<p><a href="https://www.fatalerrors.org/a/redis-source-code-analysis-26-listpack-source-code-analysis.html">https://www.fatalerrors.org/a/redis-source-code-analysis-26-listpack-source-code-analysis.html</a></p>

<p><img src="/images/blogs/redis101/Untitled%2012.png" alt="Untitled" /></p>

<p>Traditionally Redis, as compact representation of hashes, lists, and sorted sets having few elements, used a data structure called <em>ziplist (single heap allocated chunk of memory containing a list of string elements)</em></p>

<p>From Redis 5.0, <em>listpack</em> is used as a substitution of <em>ziplist →</em> guarantees the same function as ziplist and avoids cascading updates (ziplist inserting or deleting elements in the middle, while using this particular encoding, may have a <strong>cascading effect</strong>, where the previous length and even the number of bytes the previous length is encoded, may change and may <em>cascade</em> to the next elements. This was the main source of complexity of ziplist)</p>

<p><img src="/images/blogs/redis101/Untitled%2013.png" alt="Untitled" /></p>

<p><strong>Use cases scenario</strong></p>

<p>store simple and complex data objects (ex: session cache) in the Redis server. For example, user profile, product catalogue, and so on</p>

<p><strong>Commands</strong></p>

<p><strong>HSET</strong> creates and updates a hash</p>

<p><strong>HGET</strong> retrieves selected fields</p>

<p><strong>HGETALL</strong> retrieves all fields (O(n))</p>

<p><strong>HSCAN</strong> is more efficient the <strong>HGETALL</strong></p>

<p><strong>HDEL</strong> deltes fields within the hash</p>

<p><strong>HINCRBY</strong> increments a number stored at a field (There is no HDECRBY command)</p>

<p><strong>HEXISTS</strong> return 1 if the field exists and vice versa</p>

<p><strong>HKEYS</strong> will return all the field names.</p>

<p><strong>HLEN</strong> will return the cardinality (or number of fields) of the hash.</p>

<p><strong>HVALS</strong> returns the values associated with each field.</p>

<p><img src="/images/blogs/redis101/Untitled%2014.png" alt="Untitled" /></p>

<h3 id="25-sorted-sets">2.5. Sorted Sets</h3>

<p>Similar to Set. The difference is that every member of a Sorted Set is associated with a floating point score to order the set, from the <strong>smallest to the greatest score</strong>. While members are unique, scores may be repeated.</p>

<p>If two elements have the same score the tie is broken by the lexical order of the elements</p>

<p>Internally, Sorted Sets are implemented as two separate data structures:</p>

<p>A skip list with a hash table. A skip list is a data structure that allows fast search linked list within an ordered sequence of elements.</p>

<p>A ziplist, based on the zset-max-ziplist-entries and zset-max-ziplist-value configurations.</p>

<p><img src="/images/blogs/redis101/Untitled%2015.png" alt="Untitled" /></p>

<p><strong>Commands</strong></p>

<p><strong>ZADD</strong> <key> <score> <member></member></score></key></p>

<p><strong>ZREM</strong> -&gt; remove by value of element</p>

<ul>
  <li><strong>ZREMRANGEBYLEX</strong></li>
  <li><strong>ZREMRANGEBYRANK</strong> <key> <start> <stop>: remove the range specified</stop></start></key></li>
  <li><strong>ZREMRANGEBYSCORE</strong></li>
</ul>

<p><strong>ZINCRBY</strong> -&gt; increment the score of an element</p>

<p><strong>ZRANGE</strong>, <strong>ZREVRANGE</strong> [<strong>WITHSCORES</strong>]-&gt; traverse Low2High, High2Low respectively</p>

<p><strong>ZRANK, ZREVRANK</strong> -&gt; get rank of an element</p>

<p><strong>ZSCORE</strong> -&gt; get score of an element</p>

<p><strong>ZCOUNT</strong> <key> <min> <max> -&gt; count the members between min and the max score</max></min></key></p>

<p><strong>ZRANGEBYSCORE</strong> -&gt; return elements between min and max score</p>

<h3 id="26-bitmaps">2.6. Bitmaps</h3>

<p><img src="/images/blogs/redis101/Untitled%2016.png" alt="Untitled" /></p>

<p>Sequence of bits where each bit can store 0 or 1</p>

<p>Bitmaps are memory efficient, support fast data lookups, and can store up to 2 32 bits (more than 4 billion bits)</p>

<p>Not a real datatype, underthehood Bitmap is a string</p>

<p>Use bit operations onto a String</p>

<p><strong>use cases</strong></p>

<p>to store boolean information of a extremely large domain into (relatively) small space while retaining decent performance.</p>

<h3 id="27-hyperloglog">2.7. HyperLogLog</h3>

<p>Probabilistic data structure used in order to count unique things (technically this is referred to estimating the cardinality of a set) ⇒ All about efficient counting</p>

<p>⇒ Trade memory for precision: you end with an estimated measure with a standard error, which in the case of the Redis implementation is less than 1%</p>

<p>HyperLogLog is space efficient — the maximum size of the data structure is about 12kb per key</p>

<p><strong>Use cases</strong></p>

<p>When you want to count a very large set that you dont need to get them back or have a space for perfectly accurate counts.</p>

<p>Counting the number of distinct words that appear in a book</p>

<p>Counting the number of unique users who visited a website</p>

<p>example: HyperLogLog vs Set. Assume a website has an average of 100,000 unique visitors per hour. Each user has UUID (32-byte string)</p>

<p>In order to store all unique visitors, a Redis key is created for every hour of a day. This means that in a day, there are 24 keys, and in a month there are 720 keys (24 * 30)</p>

<p><img src="/images/blogs/redis101/Untitled%2017.png" alt="Untitled" /></p>

<p><strong>Commands</strong></p>

<p><strong>PFADD →</strong> Add element to the count</p>

<p><strong>PFCOUNT →</strong> retrieve the current approximation of the unique elements <em>added</em></p>

<p><strong>PFMERGE →</strong> Merge multiple HyperLogLog values into an unique value</p>

<p>Fun fact: Prefix “PF” was named after Philippe Flajolet, the author of the algorithm</p>

<h3 id="27-why-redis-single-threaded">2.7. Why Redis single threaded?</h3>

<p><a href="https://redis.io/topics/faq#redis-is-single-threaded-how-can-i-exploit-multiple-cpu--cores">https://redis.io/topics/faq#redis-is-single-threaded-how-can-i-exploit-multiple-cpu–cores</a></p>

<ul>
  <li>
    <p>Redis is single threaded, which means that it always executes one command at a time, commands are atomic.</p>
  </li>
  <li>Why single thread?
    <ul>
      <li>
        <p>Avoiding Multi-Threading Overhead (context switching, locking, race conditions, deadlocks, memory barriers, cache invalidations…)</p>
      </li>
      <li>
        <p>Redis operations are cheap (mostly O(1) time complexity) → Redis is memory, IO bound, not CPU bound</p>
      </li>
      <li>Better CPU cache locality
        <ul>
          <li>a multi-threaded Redis would suffer from <strong>CPU cache invalidations</strong> as different cores modify shared data structures (cache line ping-ponging)</li>
          <li>Redis keeps hot data in 1 CPU core’s cache for fast access</li>
        </ul>
      </li>
      <li>
        <p>Simplicity, easier to reason about code, correctness</p>
      </li>
      <li>Redis 8 = Targeted Threading Only for I/O
        <ul>
          <li>Redis adds threading where safe: I/O operations like socket read/write + parsing, <strong>RDB/AOF</strong> loading and saving</li>
          <li>Core command execution still single-threaded to protect main data structures.</li>
        </ul>
      </li>
    </ul>
  </li>
  <li>Redis vs Valkey threading design?
    <ul>
      <li>Redis uses one global keyspace accessed by one thread. This gives perfect cache locality, but prevents multi-core scaling.</li>
      <li>Valkey breaks the global keyspace into <strong>independent shards</strong> (like sharding), mapped to CPU core(s) eliminates the shared structures in Redis -&gt; parallelism with no interference.</li>
    </ul>
  </li>
</ul>

<h2 id="3-redis-persistence">3. Redis persistence</h2>

<p>if a Redis instance is shut down, crashes, or needs to be rebooted, all of the stored data will be lost. To solve this problem, Redis provides two mechanisms to deal with persistence: Redis Database (RDB) and Append-only File (AOF)</p>

<table>
  <thead>
    <tr>
      <th>Persistence Type</th>
      <th>What it stores</th>
      <th>How it stores</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>RDB (Redis Database Backup)</strong></td>
      <td>Periodic full snapshots of the dataset</td>
      <td>Forks a child process → child writes the entire dataset to a binary dump file (<code class="language-plaintext highlighter-rouge">dump.rdb</code>)</td>
    </tr>
    <tr>
      <td><strong>AOF (Append-Only File)</strong></td>
      <td>Every write command executed by Redis</td>
      <td>Appends each write command to a log file (<code class="language-plaintext highlighter-rouge">appendonly.aof</code>)</td>
    </tr>
  </tbody>
</table>

<h3 id="31-rdb-redis-database">3.1. RDB (Redis Database)</h3>

<p>Redis database file (RDB) is an option where the Redis server persists the dataset at regular interval or in other words, snapshots the data in memory at regular intervals.</p>

<p><code class="language-plaintext highlighter-rouge">.rdb</code> file is a binary representing the data stored in a Redis instance</p>

<p><code class="language-plaintext highlighter-rouge">.rdb</code> is optimized for fast reads and writes (internal representation ~ Redis in memory representation)</p>

<p>Can be configed inside <code class="language-plaintext highlighter-rouge">redis.conf</code></p>

<p><code class="language-plaintext highlighter-rouge">.rdb</code> uses LZF compression to make an RDB file very compact</p>

<p>It allows to save an RDB file every hour, day, …</p>

<p><code class="language-plaintext highlighter-rouge">rdbchecksum</code>, <code class="language-plaintext highlighter-rouge">rdbcompression</code>, <code class="language-plaintext highlighter-rouge">dbfilename</code>, <code class="language-plaintext highlighter-rouge">dir</code>, <code class="language-plaintext highlighter-rouge">save</code>, …</p>

<p><strong>Internal work</strong></p>

<ul>
  <li>Redis forks a child process.</li>
  <li>The child copies the in-memory dataset and writes it (in a nonblocking manner) to a single file (dump.rdb) ~ (<strong>BGSAVE</strong> command).</li>
</ul>

<p><strong>Drawbacks</strong></p>

<ul>
  <li>Chances of data loss when Redis crash between 2 snapshots</li>
  <li>
    <p>Copy-on-write (CoW) memory cost (extra RAM during snapshot)</p>

    <ul>
      <li>CoW: child and parent share same memory pages until one modifies -&gt; OS creates a copy</li>
      <li>For large datasets with frequent writes, CoW memory can be significant</li>
    </ul>
  </li>
</ul>

<p><strong>Use cases</strong></p>

<p>Stateless data → E.g: the data that website records the URLs the user visits in a browsing session to give better service.</p>

<p>E.g: stateful data is unappropriate → data stored is START , PAUSE , RESUME , and STOP . In this case, if we were to lose data such as PAUSE or RESUME during snapshotting, then it might bring the entire system to an unstable mode.</p>

<p>Another use case would be caching engine where there will be fewer data writes than data reads</p>

<h3 id="32-aof-append-only-file">3.2. AOF (Append-only file)</h3>

<p><strong>How AOF works</strong></p>

<ul>
  <li>Every write command is appended to the AOF buffer → rebuild to correct state</li>
  <li>Redis flushes the buffer to the OS and fsyncs based on configuration.</li>
  <li>Periodically, a rewrite occurs to compress the AOF:
    <ul>
      <li>Fork child → child rebuilds AOF to a minimal sequence of commands.</li>
    </ul>
  </li>
  <li>AOF <code class="language-plaintext highlighter-rouge">fsync</code> policies:</li>
</ul>

<table>
  <thead>
    <tr>
      <th>Setting</th>
      <th>Behavior</th>
      <th>Safety</th>
      <th>Performance</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>always</strong></td>
      <td>fsync every write</td>
      <td>Most safe</td>
      <td>Slowest</td>
    </tr>
    <tr>
      <td><strong>everysec</strong> (default)</td>
      <td>fsync once per second</td>
      <td>Lose ≤1s of data</td>
      <td>Good</td>
    </tr>
    <tr>
      <td><strong>no</strong></td>
      <td>OS decides when to flush</td>
      <td>Risky</td>
      <td>Fastest</td>
    </tr>
  </tbody>
</table>

<p><strong>Drawbacks</strong></p>

<ul>
  <li>Although AOF is more durable than RDB, it is also larger in size and slower to load.</li>
  <li>Higher write overhead than RDB snapshot</li>
</ul>

<p><strong>Use cases</strong></p>

<ul>
  <li>Useful for data that have states (e.g: workflow data)</li>
</ul>

<h3 id="33-rdb-vs-aof">3.3. RDB vs AOF</h3>

<p>Restoring data from an RDB is faster than AOF when recovering a big dataset. This is because an RDB does not need to re-execute every change made in the entire database; it only needs to load the data that was previously stored.</p>

<ul>
  <li>
    <p>Although RDB and AOF are different strategies, they can be enabled at the same time</p>

    <ul>
      <li>RDB for faster restarts,</li>
      <li>AOF for better durability,</li>
      <li>AOF rewrite that can include an initial RDB image + incremental commands.</li>
    </ul>
  </li>
</ul>

<h2 id="4-partitioning">4. Partitioning</h2>

<p>Partitioning is a general term used to describe the act of breaking up data and distributing it across different hosts. 2 types of partitioning:</p>

<p><strong>Horizontal partitioning:</strong> putting different rows into different tables</p>

<p><strong>Vertical partitioning:</strong> creating tables with fewer columns and using additional tables to store the remaining columns</p>

<p>In Redis, we can use replicas to optimize reads and remove bottlenecks fromt he master instance → sometimes not enough:</p>

<ul>
  <li>The total data to be stored is larger than the total memory available in a Redis server</li>
  <li>The network bandwidth is not enough to handle all of the traffic</li>
</ul>

<p>In the context of Redis,</p>

<p><strong>Horizontal partitioning ~</strong> distributing keys across different Redis instances (e.g: given 2 sets, distribute each key to different instance)</p>

<p><strong>Vertical partitioning ~</strong> means distributing key values across different Redis instances (e.g: given 2 sets, distribute some values of each set to different instance)</p>

<h3 id="41-range-partitioning">4.1. Range partitioning</h3>

<p>Data is distributed based on a range of keys (e.g: Given <em>user:1 → user:3000, user:3001 → user:5000</em>)</p>

<p><strong>Drawbacks</strong></p>

<ul>
  <li>
    <p>Uneven distribution (e.g: if you decide to distribute the keys based on their first letter but you do not have a good distribution of key names)</p>
  </li>
  <li>
    <p>Adding or removing a host will invalidate a good portion of data</p>
  </li>
</ul>

<h3 id="42-hash-partitioning">4.2. Hash partitioning</h3>

<p>Does not have “uneven distribution” of range partitioning</p>

<p>It consists of finding the instance to send the commands by applying a hash function to the Redis key, dividing this hash value by the number of Redis instances available, and using the remainder of that division as the instance inde</p>

<h3 id="43-hash-slot-consistent-hashing">4.3. Hash slot, consistent hashing</h3>

<ul>
  <li>
    <p>Redis Cluster uses hash slots to split the key space into <strong>16,384</strong> slots. Each key is hashed to one of these slots using the CRC16 algorithm, and each slot is assigned to a specific node in the cluster.</p>
  </li>
  <li>
    <p>Consistent hashing, in our context, is a kind of hashing that remaps only a small portion of the data to different servers when the list of Redis servers is changed (only K/n keys are remapped, where K is the number of keys and n is the number of servers).</p>
  </li>
</ul>

<p><img src="/images/blogs/redis101/image-1.png" alt="alt text" /></p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>redis&gt; SET mykey1 "Hello"
"OK"
redis&gt; SET mykey2 "Hello 2"
"OK"
redis&gt; CLUSTER KEYSLOT mykey1
(integer) 650
redis&gt; CLUSTER KEYSLOT mykey2
(integer) 8734
</code></pre></div></div>

<ul>
  <li><code class="language-plaintext highlighter-rouge">CROSSLOT</code> error when accessing multiple keys in different slots</li>
  <li>You can control <code class="language-plaintext highlighter-rouge">CROSSLOT</code> error by using hash tags to control key distribution (e.g: <code class="language-plaintext highlighter-rouge">user:{1000}:followers</code>, <code class="language-plaintext highlighter-rouge">user:{1000}:following</code> will be stored in the same hash slot)</li>
</ul>

<h2 id="references">References</h2>

<p>Learning Redis → Redis data structure, use cases, persistence handling</p>

<p>Redis in action →data structure, redis web app use cases</p>

<p>Redis Essentials → Common pitfalls, security technique, redis cluster and sentinel</p>

<p><a href="https://redis.io/topics/data-types-intro">https://redis.io/topics/data-types-intro</a></p>

<p><a href="https://gist.github.com/antirez/66ffab20190ece8a7485bd9accfbc175">https://gist.github.com/antirez/66ffab20190ece8a7485bd9accfbc175</a></p>

<p><a href="https://www.fatalerrors.org/a/redis-source-code-analysis-26-listpack-source-code-analysis.html">https://www.fatalerrors.org/a/redis-source-code-analysis-26-listpack-source-code-analysis.html</a></p>

<p><a href="https://builder.aws.com/content/2tfQijlXleV5iM6hDkSGkMJlpcd/the-engineering-wisdom-behind-rediss-single-threaded-design">The Engineering wisdom behind redis design</a></p>

<p>Doc: <a href="https://docs.google.com/document/d/1TZz44QoijEGMf9acsfVY2Bm89f93ioN8XvJ5Fzo00G8/edit#heading=h.i8j05yrck6a2">https://docs.google.com/document/d/1TZz44QoijEGMf9acsfVY2Bm89f93ioN8XvJ5Fzo00G8/edit#heading=h.i8j05yrck6a2</a></p>

<p>Slide: <a href="https://docs.google.com/presentation/d/1CsY9Ifd8GPwPh2d-ah0OeYrn4LTM8nW0Q84CcrANx0Y/edit#slide=id.p">https://docs.google.com/presentation/d/1CsY9Ifd8GPwPh2d-ah0OeYrn4LTM8nW0Q84CcrANx0Y/edit#slide=id.p</a></p>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Redis" /><category term="Caching" /><summary type="html"><![CDATA[This article introduces Redis, a widely-used in-memory data store. It covers Redis basics, caching strategies, data structures, persistence mechanisms, and techniques.]]></summary></entry><entry><title type="html">Kafka Message compression</title><link href="https://hoangtl.site/posts/kafka-message-compression/" rel="alternate" type="text/html" title="Kafka Message compression" /><published>2025-02-02T00:00:00+00:00</published><updated>2025-02-02T00:00:00+00:00</updated><id>https://hoangtl.site/posts/kafka-compression</id><content type="html" xml:base="https://hoangtl.site/posts/kafka-message-compression/"><![CDATA[<p>This article explains how Kafka message compression works, its configuration, and considerations for both producers and consumers.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#introduction" id="markdown-toc-introduction">Introduction</a></li>
  <li><a href="#compression-types" id="markdown-toc-compression-types">Compression Types</a></li>
  <li><a href="#kafka-producer-configuration" id="markdown-toc-kafka-producer-configuration">Kafka Producer Configuration</a></li>
  <li><a href="#kafka-consumers-handling-mixed-data-dynamics" id="markdown-toc-kafka-consumers-handling-mixed-data-dynamics">Kafka consumers: Handling mixed data dynamics</a></li>
  <li><a href="#kafka-compression-flow-producer---broker---consumer" id="markdown-toc-kafka-compression-flow-producer---broker---consumer">Kafka Compression Flow: Producer -&gt; Broker -&gt; Consumer</a></li>
  <li><a href="#notes" id="markdown-toc-notes">Notes</a></li>
  <li><a href="#reference" id="markdown-toc-reference">Reference</a></li>
</ul>

  </nav>
</aside>

<h2 id="introduction">Introduction</h2>

<p>Kafka producer data compression works by <strong>batching data going to the same partition</strong> before applying compression.</p>

<ul>
  <li>Batching: Kafka producers group records destined <strong>for the same partition</strong> into record batches, then compress each batch as a unit.</li>
  <li>Compression Type: The chosen compression algorithm (e.g., Snappy, Gzip) affects performance.</li>
  <li>Decompression: Brokers usually store producer-compressed batches using the original codec. They may decompress or recompress batches during validation, log compaction, message-format conversion, or when the broker/topic configuration enforces another compression codec.</li>
</ul>

<p>Batch size trade off:</p>

<ul>
  <li>Small Batch Size: Saves memory, reduces latency (good for low-throughput, low-latency scenarios).</li>
  <li>Large Batch Size: Increases throughput, but consumes more memory (good for high-throughput scenarios).</li>
</ul>

<h2 id="compression-types">Compression Types</h2>

<p><img src="/images/blogs/compression.png" alt="Compression Types" /></p>

<h2 id="kafka-producer-configuration">Kafka Producer Configuration</h2>

<p><code class="language-plaintext highlighter-rouge">compression.type</code>: The compression algorithm to use.
<code class="language-plaintext highlighter-rouge">batch.size</code>: The maximum size of a batch before compression.
<code class="language-plaintext highlighter-rouge">linger.ms</code>: The time to wait for more messages before sending a batch.
<code class="language-plaintext highlighter-rouge">max.request.size</code>: The maximum producer request size. A request may contain multiple partition batches, and this setting also effectively limits the maximum uncompressed record-batch size.</p>

<h2 id="kafka-consumers-handling-mixed-data-dynamics">Kafka consumers: Handling mixed data dynamics</h2>

<p>TLDR, you don’t need to config anything on the consumer side to handle compressed messages.</p>

<p>Kafka’s architecture ensures that consumers do not need to know which supported compression codec a producer used. Compression and decompression are handled transparently by the Kafka client. However, consumers must still use the correct key and value deserializers for the application’s data format.</p>

<ul>
  <li><strong>Compatibility</strong>
    <ul>
      <li>A single consumer can read from a topic partition containing a mix of both compressed and uncompressed messages</li>
      <li>Impact: You can upgrade producers individually or change compression types on the fly without breaking or restarting downstream consumer applications.</li>
    </ul>
  </li>
  <li><strong>Consumer Handling</strong>
    <ul>
      <li>Each record batch contains compression metadata in its batch attributes. The Kafka consumer client reads this metadata and automatically decompresses the batch before deserializing and returning individual records.</li>
      <li>The consumer checks these flags automatically. If the bits indicate the batch is compressed, the consumer looks up the designated compression codec in memory, unpacks the payload, and presents pure, readable records to the application loop. <strong>No manual decoding</strong> code is required by the developer.</li>
    </ul>
  </li>
  <li><strong>Decoupling Advantage</strong>
    <ul>
      <li>Kafka’s design allows decoupling between producers and consumers, facilitating the handling of mixed message types.</li>
      <li>Producers can choose compression based purely on their own environmental limits (like restricted network bandwidth). Consumers remain entirely unaffected by this choice because the underlying Kafka client wrapper handles the heavy lifting transparently.</li>
    </ul>
  </li>
</ul>

<h2 id="kafka-compression-flow-producer---broker---consumer">Kafka Compression Flow: Producer -&gt; Broker -&gt; Consumer</h2>

<p>Compression changes how records are transferred and stored, but the Kafka’s core model remains the same: offsets are assigned to records, and consumers read records in-order from a given offset. The compression flow is as follows:</p>

<p><img src="/images/blogs/kafka-compression-flow.png" alt="Kafka Compression Flow" /></p>

<p>When the producer builds a record batch, it gives records sequential deltas of offsets and these record structures are then compressed together. for example:</p>

<pre><code class="language-txt">Producer batch:

Record A → offsetDelta = 0
Record B → offsetDelta = 1
Record C → offsetDelta = 2

lastOffsetDelta = 2
</code></pre>

<p><strong>How offset is assigned per batch?</strong></p>

<ul>
  <li>Broker assigns a base offset to the batch (e.g, 100)</li>
  <li>Each record gets an offset = baseOffset + offsetDelta</li>
</ul>

<p><strong>How batch is stored in broker?</strong></p>

<ul>
  <li>Broker stores the batch as a single compressed unit with metadata</li>
  <li>Offsets are logical and preserved via baseOffset</li>
</ul>

<h2 id="notes">Notes</h2>

<ul>
  <li>Encrypted data should not be compressed since data is random.</li>
</ul>

<h2 id="reference">Reference</h2>

<ul>
  <li><a href="https://www.confluent.io/blog/apache-kafka-message-compression">Apache Kafka Message Compression</a></li>
  <li><a href="https://www.architecture-weekly.com/p/how-a-kafka-like-producer-writes">How a Kafka-like Producer Writes</a></li>
</ul>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Kafka" /><summary type="html"><![CDATA[This article explains how Kafka message compression works, its configuration, and considerations for both producers and consumers.]]></summary></entry><entry><title type="html">Kafka Best Practices</title><link href="https://hoangtl.site/posts/kafka-best-practices/" rel="alternate" type="text/html" title="Kafka Best Practices" /><published>2025-02-01T00:00:00+00:00</published><updated>2025-02-01T00:00:00+00:00</updated><id>https://hoangtl.site/posts/kafka-best-practices</id><content type="html" xml:base="https://hoangtl.site/posts/kafka-best-practices/"><![CDATA[<p>Below are some notes on Kafka best practices that I found useful while working with Kafka in production.</p>

<aside class="sidebar__right sticky">
<nav class="toc">
    <header><h4 class="nav__title"><i class="fa fa-file-text"></i> On This Page</h4></header>
<ul class="toc__menu" id="markdown-toc">
  <li><a href="#1-choosing-topicpartitions" id="markdown-toc-1-choosing-topicpartitions">1. Choosing topic/Partitions</a>    <ul>
      <li><a href="#consideration" id="markdown-toc-consideration">Consideration</a></li>
    </ul>
  </li>
  <li><a href="#2-factors-affecting-performance" id="markdown-toc-2-factors-affecting-performance">2. Factors Affecting Performance</a></li>
  <li><a href="#3-kafka-broker-configs" id="markdown-toc-3-kafka-broker-configs">3. Kafka Broker configs</a></li>
  <li><a href="#4-kafka-producer" id="markdown-toc-4-kafka-producer">4. Kafka producer</a>    <ul>
      <li><a href="#critical-configs" id="markdown-toc-critical-configs">Critical configs</a></li>
      <li><a href="#performance-notes" id="markdown-toc-performance-notes">Performance notes</a></li>
      <li><a href="#lifecycle-of-a-request-from-producer-to-broker" id="markdown-toc-lifecycle-of-a-request-from-producer-to-broker">Lifecycle of a request from Producer to Broker</a></li>
      <li><a href="#compressiontype" id="markdown-toc-compressiontype">Compression.type</a></li>
      <li><a href="#acks" id="markdown-toc-acks">ACKs</a></li>
      <li><a href="#maxinflightrequestsperconnection" id="markdown-toc-maxinflightrequestsperconnection">Max.in.flight.requests.per.connection</a></li>
    </ul>
  </li>
  <li><a href="#5-kafka-consumer" id="markdown-toc-5-kafka-consumer">5. Kafka consumer</a></li>
  <li><a href="#references" id="markdown-toc-references">References</a></li>
</ul>

  </nav>
</aside>

<h2 id="1-choosing-topicpartitions">1. Choosing topic/Partitions</h2>

<ul>
  <li>Topic/Partition is unit of parallelism in Kafka</li>
  <li>More Partitions = more parallelism of consumers -&gt; More throughput</li>
</ul>

<h3 id="consideration">Consideration</h3>

<ul>
  <li>
    <p>More partitions can increase the end-to-end latency (time from producer to consumer read)</p>

    <ul>
      <li>Messages are exposed to consumers only after being committed (replicated to all in-sync replicas)</li>
      <li>Replicating 1000 partitions can take 20ms, potentially too high for real-time applications.</li>
    </ul>
  </li>
  <li>
    <p>Kafka Producer Buffering mechanism:</p>

    <ul>
      <li>Messages are buffered per partition and sent to the broker after enough accumulation or time.</li>
      <li>more partitions = messages will be accumulated for more partitions on producer side.
        <ul>
          <li>Each partition has its own buffer, and messages are stored in batches within these buffers</li>
          <li>More partitions = producer needs to maintain more buffers</li>
        </ul>
      </li>
    </ul>
  </li>
  <li>
    <p>Kafka Consumer:</p>
    <ul>
      <li>fetches batch of messages per partitions. The more partitions that consumer is subscribing to, the more memory it needs.</li>
    </ul>
  </li>
</ul>

<h2 id="2-factors-affecting-performance">2. Factors Affecting Performance</h2>

<ul>
  <li>RAM - Main memory. More specifically File system buffer cache.</li>
  <li>Multiple dedicated disks.</li>
  <li><strong>Partitions per topic</strong>. More partitions allows increased parallelism.</li>
  <li>Ethernet bandwidth.</li>
</ul>

<h2 id="3-kafka-broker-configs">3. Kafka Broker configs</h2>

<ul>
  <li><code class="language-plaintext highlighter-rouge">log.retention.hours</code>: Controls when the old messages in a topic will be deleted.</li>
  <li><code class="language-plaintext highlighter-rouge">message.max.bytes</code>: Maximum message size the server can accept. Ensure <code class="language-plaintext highlighter-rouge">replica.fetch.max.bytes</code> is set to be &gt;= this value.</li>
  <li><code class="language-plaintext highlighter-rouge">delete.topic.enable</code>: Allows users to delete a topic from Kafka. Disabled by default, functional from Kafka 0.9 onwards.</li>
  <li><code class="language-plaintext highlighter-rouge">unclean.leader.election</code>: true by default, prioritizing availability over durability.
    <ul>
      <li>If set to true, a replica can become the leader without it being a ISR if the original leader broker goes down, risking data loss.</li>
      <li>Set to false for higher durability to prevent unclean leader elections.</li>
    </ul>
  </li>
</ul>

<h2 id="4-kafka-producer">4. Kafka producer</h2>

<h3 id="critical-configs">Critical configs</h3>

<ul>
  <li><code class="language-plaintext highlighter-rouge">batch.size</code> (size based batching)</li>
  <li><code class="language-plaintext highlighter-rouge">linger.ms</code> (time based batching)</li>
  <li><code class="language-plaintext highlighter-rouge">compression.type</code></li>
  <li><code class="language-plaintext highlighter-rouge">max.in.flight.requests.per.connection</code> (affects ordering)</li>
  <li><code class="language-plaintext highlighter-rouge">acks</code> (affects durability)</li>
</ul>

<h3 id="performance-notes">Performance notes</h3>

<ul>
  <li>
    <p><strong>Partition Targeting:</strong></p>

    <ul>
      <li>A producer thread targeting a single partition performs faster than one sending messages to multiple partitions.</li>
    </ul>
  </li>
  <li>
    <p><strong>Flush Optimization:</strong></p>

    <ul>
      <li>The new Producer API’s flush() call can improve performance if used correctly.</li>
      <li>Optimal performance is achieved with around 4MB of data between flush() calls (based on 1KB event size).</li>
      <li>Rule of thumb for batch size: <code class="language-plaintext highlighter-rouge">batch.size = total bytes between flush() / partition count.</code></li>
    </ul>
  </li>
  <li>
    <p><strong>Scaling Producers:</strong></p>

    <ul>
      <li>If producer throughput is maximized but there is spare CPU and network capacity, add more producer processes.</li>
    </ul>
  </li>
  <li>
    <p><strong>Event Size Sensitivity:</strong></p>

    <ul>
      <li>Larger event sizes (e.g., 1KB) generally yield better throughput than smaller events (e.g., 100 bytes).</li>
    </ul>
  </li>
  <li>
    <p><strong>Linger.ms Impact:</strong></p>
    <ul>
      <li>No definitive rule; its impact varies with use case. For small events (100 bytes or less), it generally has minimal effect.</li>
    </ul>
  </li>
</ul>

<h3 id="lifecycle-of-a-request-from-producer-to-broker">Lifecycle of a request from Producer to Broker</h3>

<ul>
  <li>
    <p><strong>Batch Polling:</strong> Polls a batch from the batch queue, one batch per partition.</p>
  </li>
  <li>
    <p><strong>Batch Grouping:</strong> Groups batches based on the leader broker then sends the grouped batches to the brokers.</p>
  </li>
  <li>
    <p><strong>Pipelining</strong>: If <code class="language-plaintext highlighter-rouge">max.in.flight.requests.per.connection</code> &gt; 1, requests are pipelined.</p>
  </li>
  <li>
    <p><strong>Batch Readiness:</strong> A batch is ready to send when:</p>

    <ul>
      <li><code class="language-plaintext highlighter-rouge">batch.size</code> is reached.</li>
      <li><code class="language-plaintext highlighter-rouge">linger.ms</code> is reached.</li>
      <li>Another batch to the same broker is ready.</li>
      <li>flush() or close() is called.</li>
    </ul>
  </li>
  <li>
    <p><strong>Big Batching:</strong></p>
    <ul>
      <li>Results in better compression ratio and higher throughput.</li>
      <li>Leads to higher latency.</li>
    </ul>
  </li>
</ul>

<h3 id="compressiontype">Compression.type</h3>

<ul>
  <li>Compression is in user thread, so adding more threads helps with the throughput if compression is slow</li>
</ul>

<p><img src="/images/blogs/compression.png" alt="Compression Types" /></p>

<h3 id="acks">ACKs</h3>

<ul>
  <li>Defines durability level for producer.</li>
</ul>

<h3 id="maxinflightrequestsperconnection">Max.in.flight.requests.per.connection</h3>

<ul>
  <li>Max.in.flight.requests.per.connection &gt; 1 means pipelining.
    <ul>
      <li>Gives better throughput</li>
      <li>May cause out of order delivery when retry occurs</li>
      <li>Excessive pipelining , drops throughput</li>
    </ul>
  </li>
</ul>

<h2 id="5-kafka-consumer">5. Kafka consumer</h2>

<ul>
  <li>Rule of thumb:
    <ul>
      <li>Number of consumer threads = Partition count</li>
      <li>Microbenchmarking showed that <code class="language-plaintext highlighter-rouge">Consumer performance was not as sensitive to event size or batch size as compared to Producer</code>. Both 1kb and 100byte events showed similar throughput.</li>
    </ul>
  </li>
</ul>

<h2 id="references">References</h2>

<ul>
  <li><a href="https://community.cloudera.com/t5/Community-Articles/Kafka-Best-Practices/ta-p/249371">https://community.cloudera.com/t5/Community-Articles/Kafka-Best-Practices/ta-p/249371</a></li>
  <li><a href="https://www.redpanda.com/guides/kafka-performance-kafka-rebalancing">https://www.redpanda.com/guides/kafka-performance-kafka-rebalancing</a></li>
  <li><a href="https://dev.to/konstantinas_mamonas/kafka-producers-explained-partitioning-batching-and-reliability-4bm8">https://dev.to/konstantinas_mamonas/kafka-producers-explained-partitioning-batching-and-reliability-4bm8</a></li>
  <li><a href="https://www.confluent.io/blog/exactly-once-semantics-are-possible-heres-how-apache-kafka-does-it/?placement=&amp;device=c&amp;creative=&amp;session_ref=https%3A%2F%2Fwww.google.com%2F)">https://www.confluent.io/blog/exactly-once-semantics-are-possible-heres-how-apache-kafka-does-it/?placement=&amp;device=c&amp;creative=&amp;session_ref=https%3A%2F%2Fwww.google.com%2F)</a></li>
</ul>]]></content><author><name>Le-Hoang Tran</name><email>hoangtl.cs@gmail.com</email></author><category term="Kafka" /><category term="Best Practices" /><summary type="html"><![CDATA[Below are some notes on Kafka best practices that I found useful while working with Kafka in production.]]></summary></entry></feed>